

AI로 만드는 단편 영화: 시나리오부터 최종 편집까지의 파이프라인
단편 영화의 핵심은 개별 샷이 아니라 파이프라인입니다. 'Last Train'은 25초 분량으로 주인공 1명, 거리 악사 1명, 승강장 1곳, 크롬 케이스 1개가 등장합니다. 이 영상을 만든 모든 단계와 실제 프롬프트, 각 단계에 사용한 모델, 그리고 파이프라인이 막혔던 지점들을 소개합니다.
- 13분 분량
영어에서 자동 번역되었습니다. 원문 보기
Last Train은 이 가이드를 위해 제작된 25초 분량의 영화입니다. Vale이 마지막 기차를 향해 달리지만 놓치고, 웃음을 터뜨립니다. 모든 내용은 실제 회사 계정에서 아래 순서대로 라이브 컴포저를 사용해 생성한 결과물이며, 등장하는 모든 인물은 가상의 인물입니다. 동일한 세트의 컷은 일관성 가이드에서 객체별로 측정됩니다.
먼저 두 가지 한계를 솔직하게 짚어보겠습니다. 저장된 캐릭터는 의상과 텍스트 설명을 모든 컷에 유지하지만, 컷 간에 동일한 인물로 인식되는지는 측정하지 않았으며 이 가이드도 이를 보장하지 않습니다. 또한 캐릭터를 바로 비디오 모델에 연결하면 거부되거나 역이 사라지는 문제가 발생하므로, 여기서는 모든 컷이 프레임에서 시작합니다. 이 두 가지 모두 단계에 포함되어 있습니다.
자주 발생하는 문제
| 실수 | 실패 원인 | 수정 |
|---|---|---|
| 출연진이 존재하기 전에 첫 번째 클립을 촬영하는 경우 | 모든 컷이 각자 다른 인물, 코트, 플랫폼을 생성합니다 | 캐릭터, 장소, 소품 스틸을 먼저 저장하세요 |
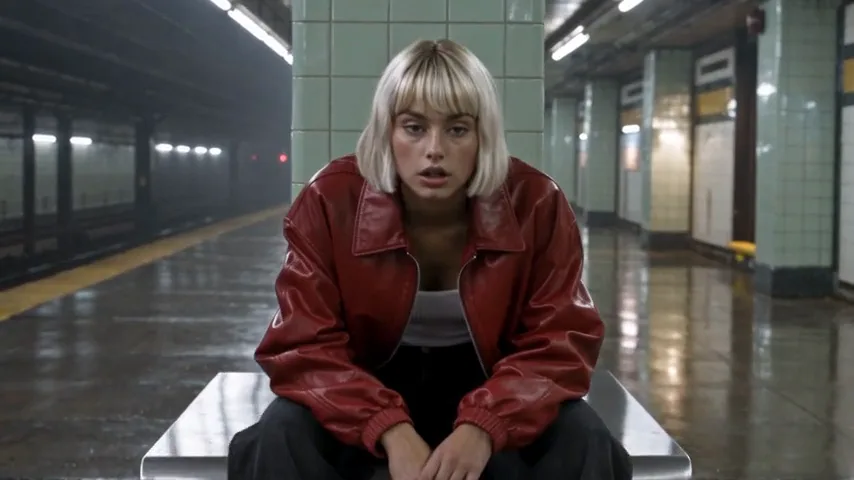
| 캐릭터를 바로 비디오 모델로 보내는 경우 | 일부 모델은 사실적인 인물을 참조로 거부하거나 참조로 사용할 수 없습니다. 그녀를 선택한 모델은 자체 플랫폼을 만들어냈습니다. | 이미지 컴포저에서 출연진을 연결하여 16:9 프레임을 만든 다음, 그 프레임을 애니메이션화하세요. |
| 한 장면 전체를 위한 하나의 롱 샷 | 모션이 흐트러지고, 소품이 변형되며, 세트가 반복됩니다. | 장면당 4~6초, 각 장면에는 하나의 동작만 포함하세요. 흐트러지는 지점에서 컷하세요. |
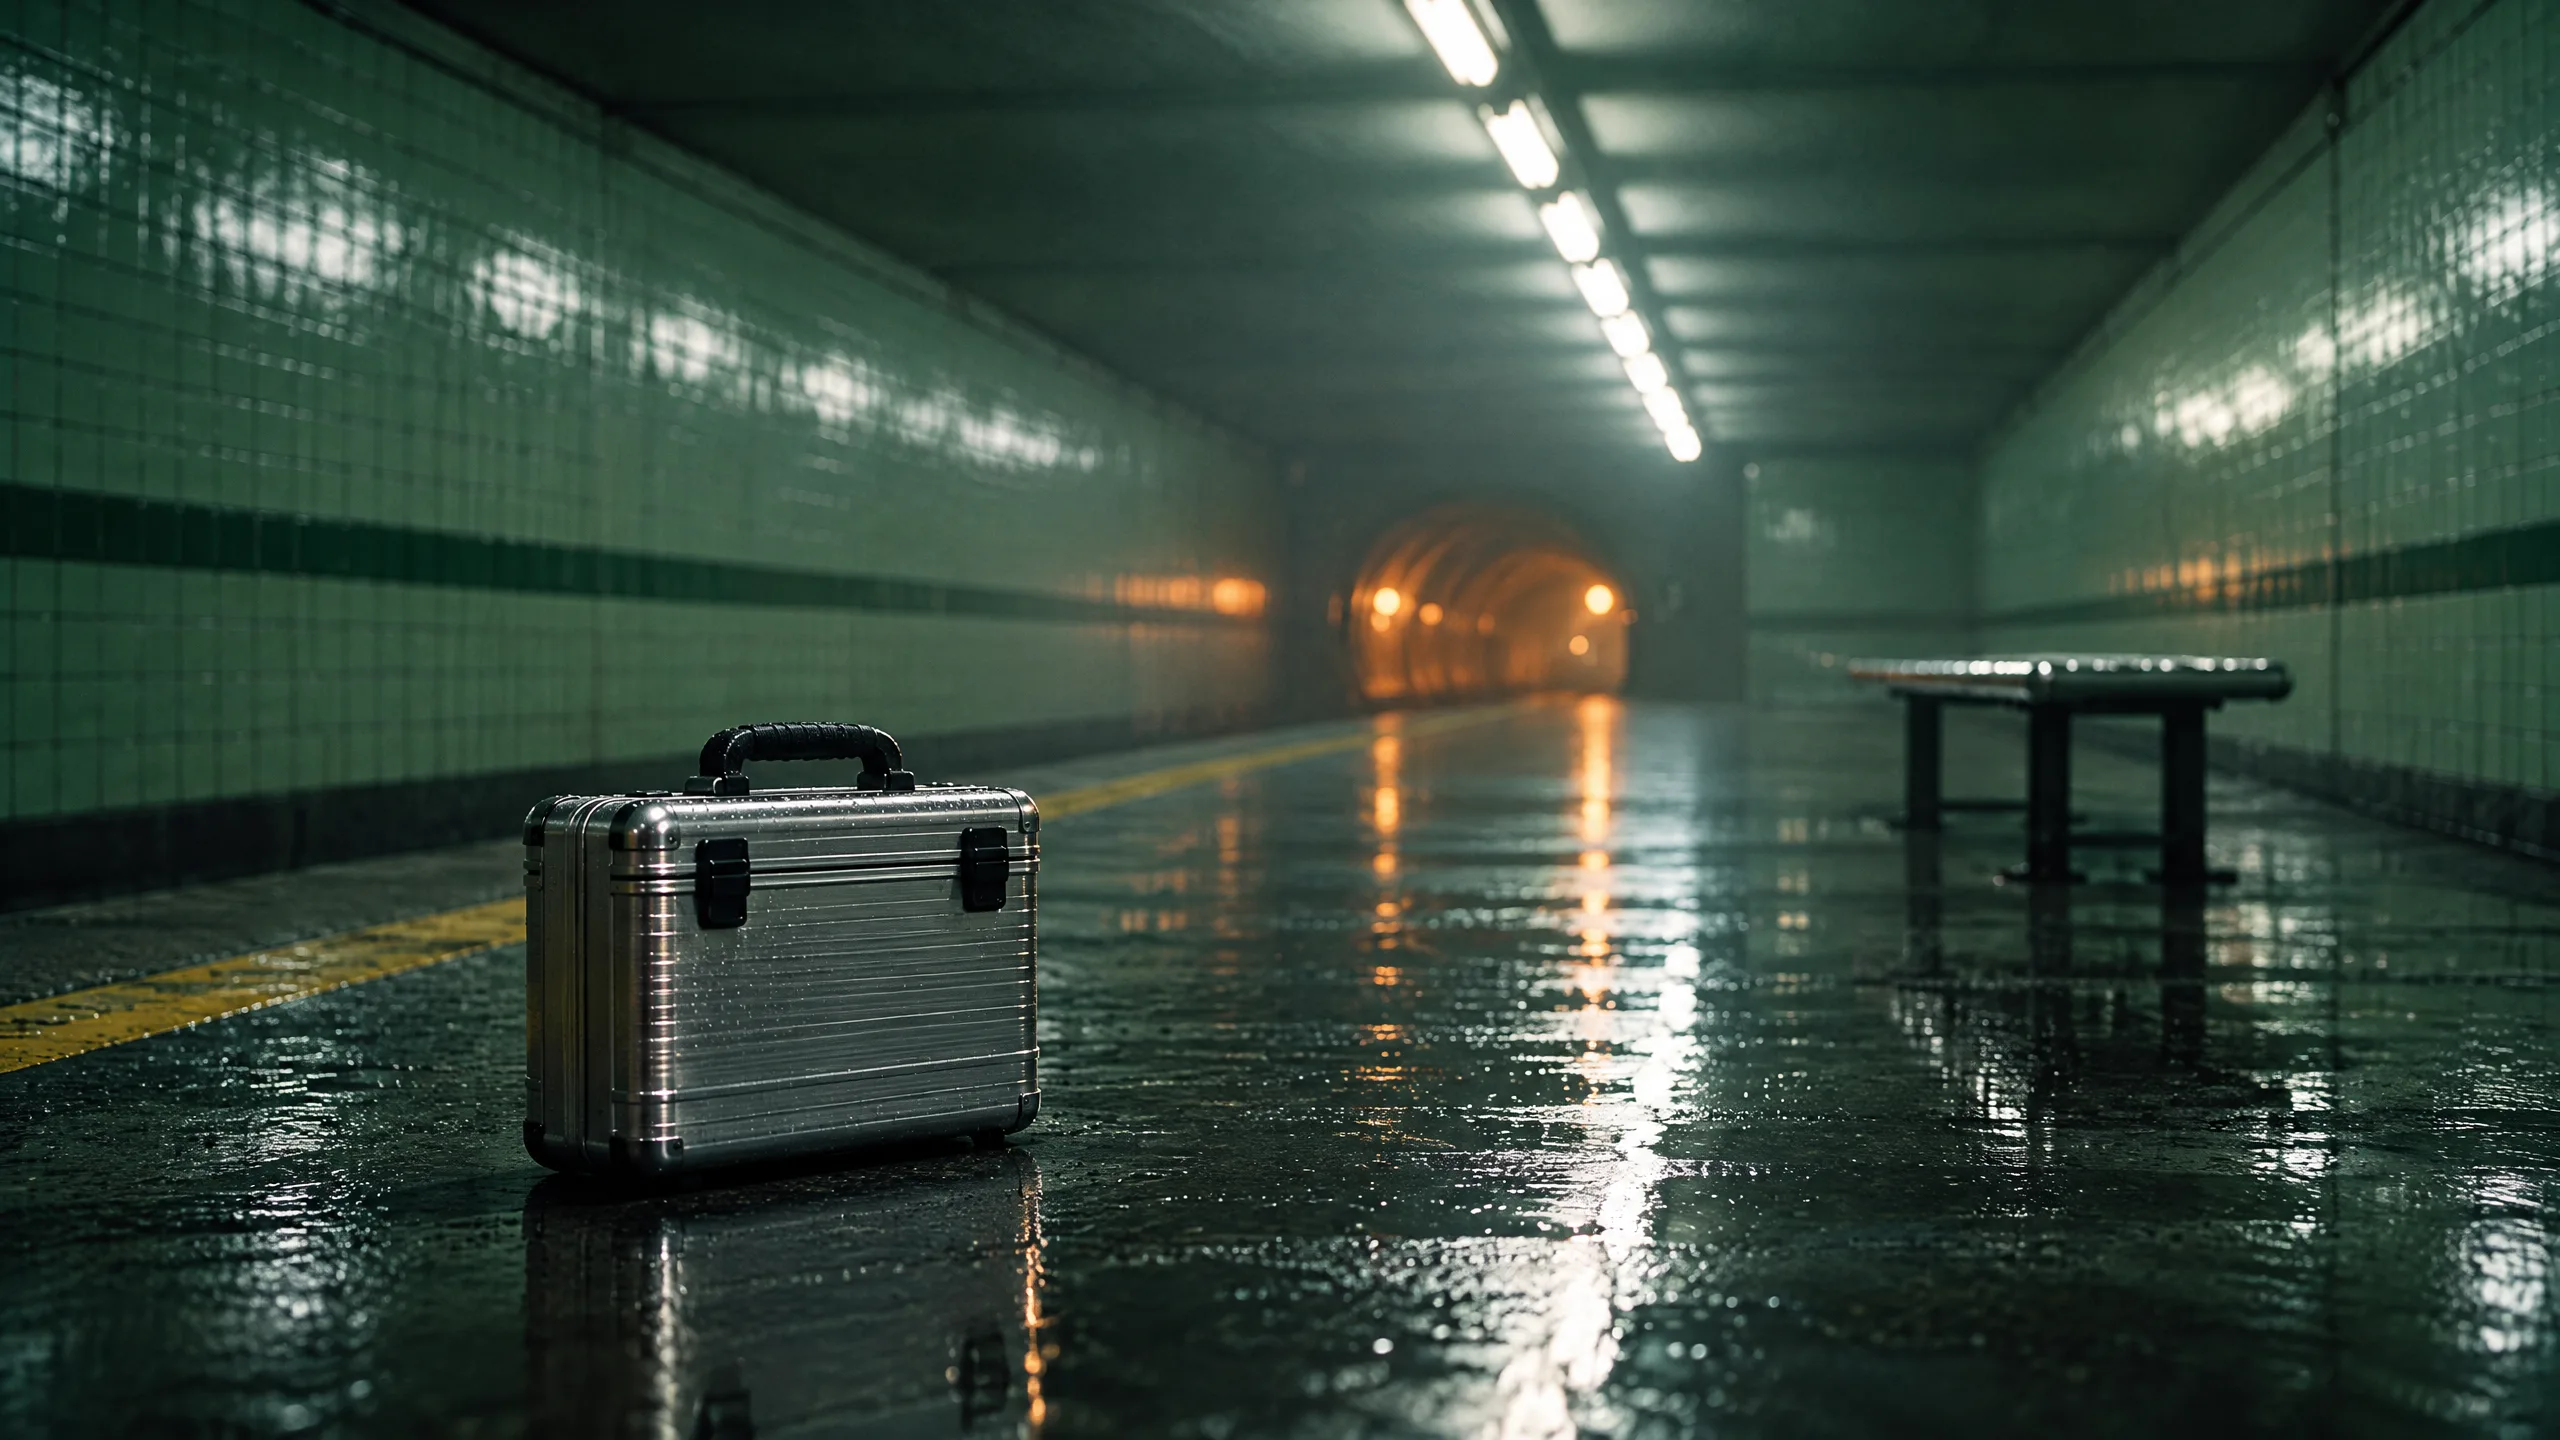
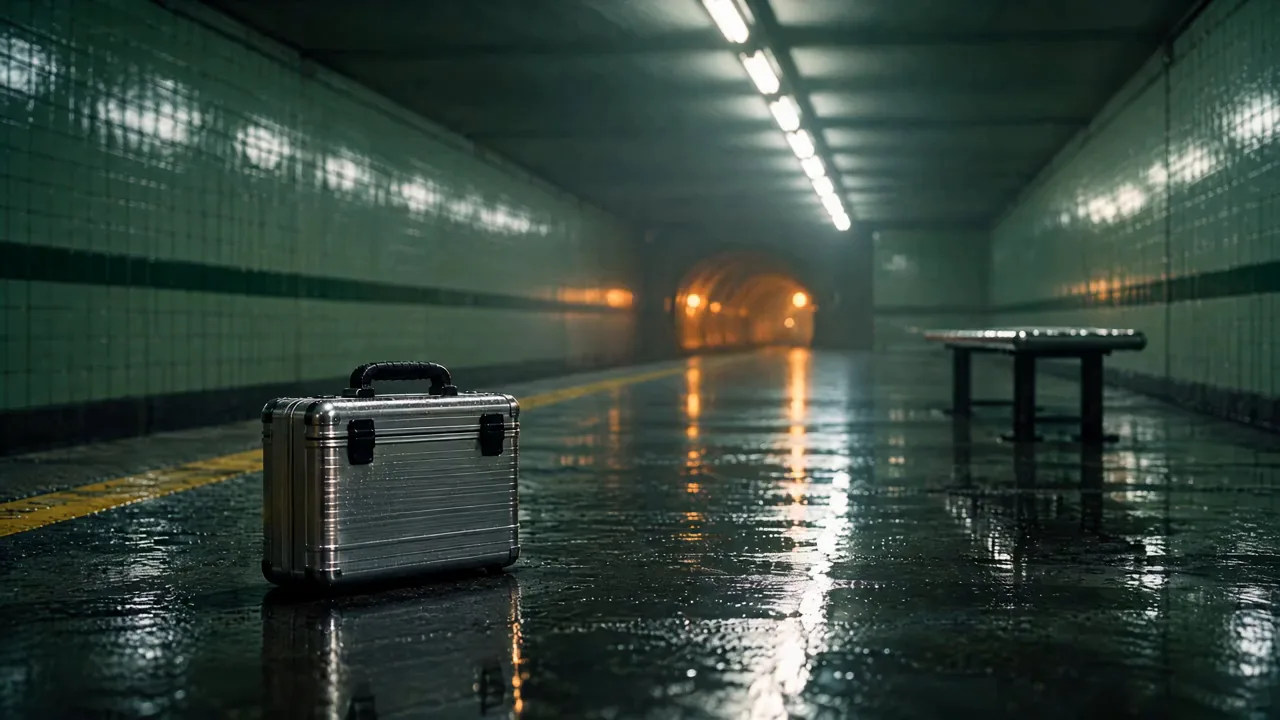
| 매번 소품을 다르게 설명하는 것 | 크롬 케이스가 브리프케이스가 되고, 다시 가방이 됩니다. | 소품에 대한 한 문장을 작성하여 모든 프롬프트에 붙여넣고, 인서트를 위해 소품의 정지 이미지를 준비하세요. |
| 각 클립을 개별적으로 그레이딩하는 것 | 다섯 가지 방식으로 그레이딩된 다섯 개의 클립은 마치 다섯 편의 영화처럼 보입니다. | 스튜디오에서 타임라인을 한 번에 그레이딩하세요. |
시작하기 전에
- 명명된 비트가 포함된 대본. 5개의 비트는 25초입니다.
- 캐릭터, 장소, 소품마다 한 문장씩 작성하세요. 의상팀이나 미술 팀이 작성하는 방식과 동일하게 작성해야 합니다. 이 문장들은 변경하지 않고 모든 프롬프트에 붙여넣습니다.
- NOLGIA 계정. 캐릭터, 장소, 컴포저, 스튜디오가 함께 제공됩니다.
- 각 단계마다 한 번의 재시도를 위한 인내심. 저희도 한 번이 필요했으며, 가이드에 그 위치가 명시되어 있습니다.
LAST TRAIN. Night. An underground platform, pale green tiles under cold fluorescent tubes. 1. Vale runs for the last train, a chrome case in one hand. 2. She passes Ozzy, the busker, who turns to watch. 3. The doors close in her face and the train pulls away. 4. The case, set down on the wet platform. 5. On the bench, out of breath, she laughs.출연진, 세트, 소품 저장하기
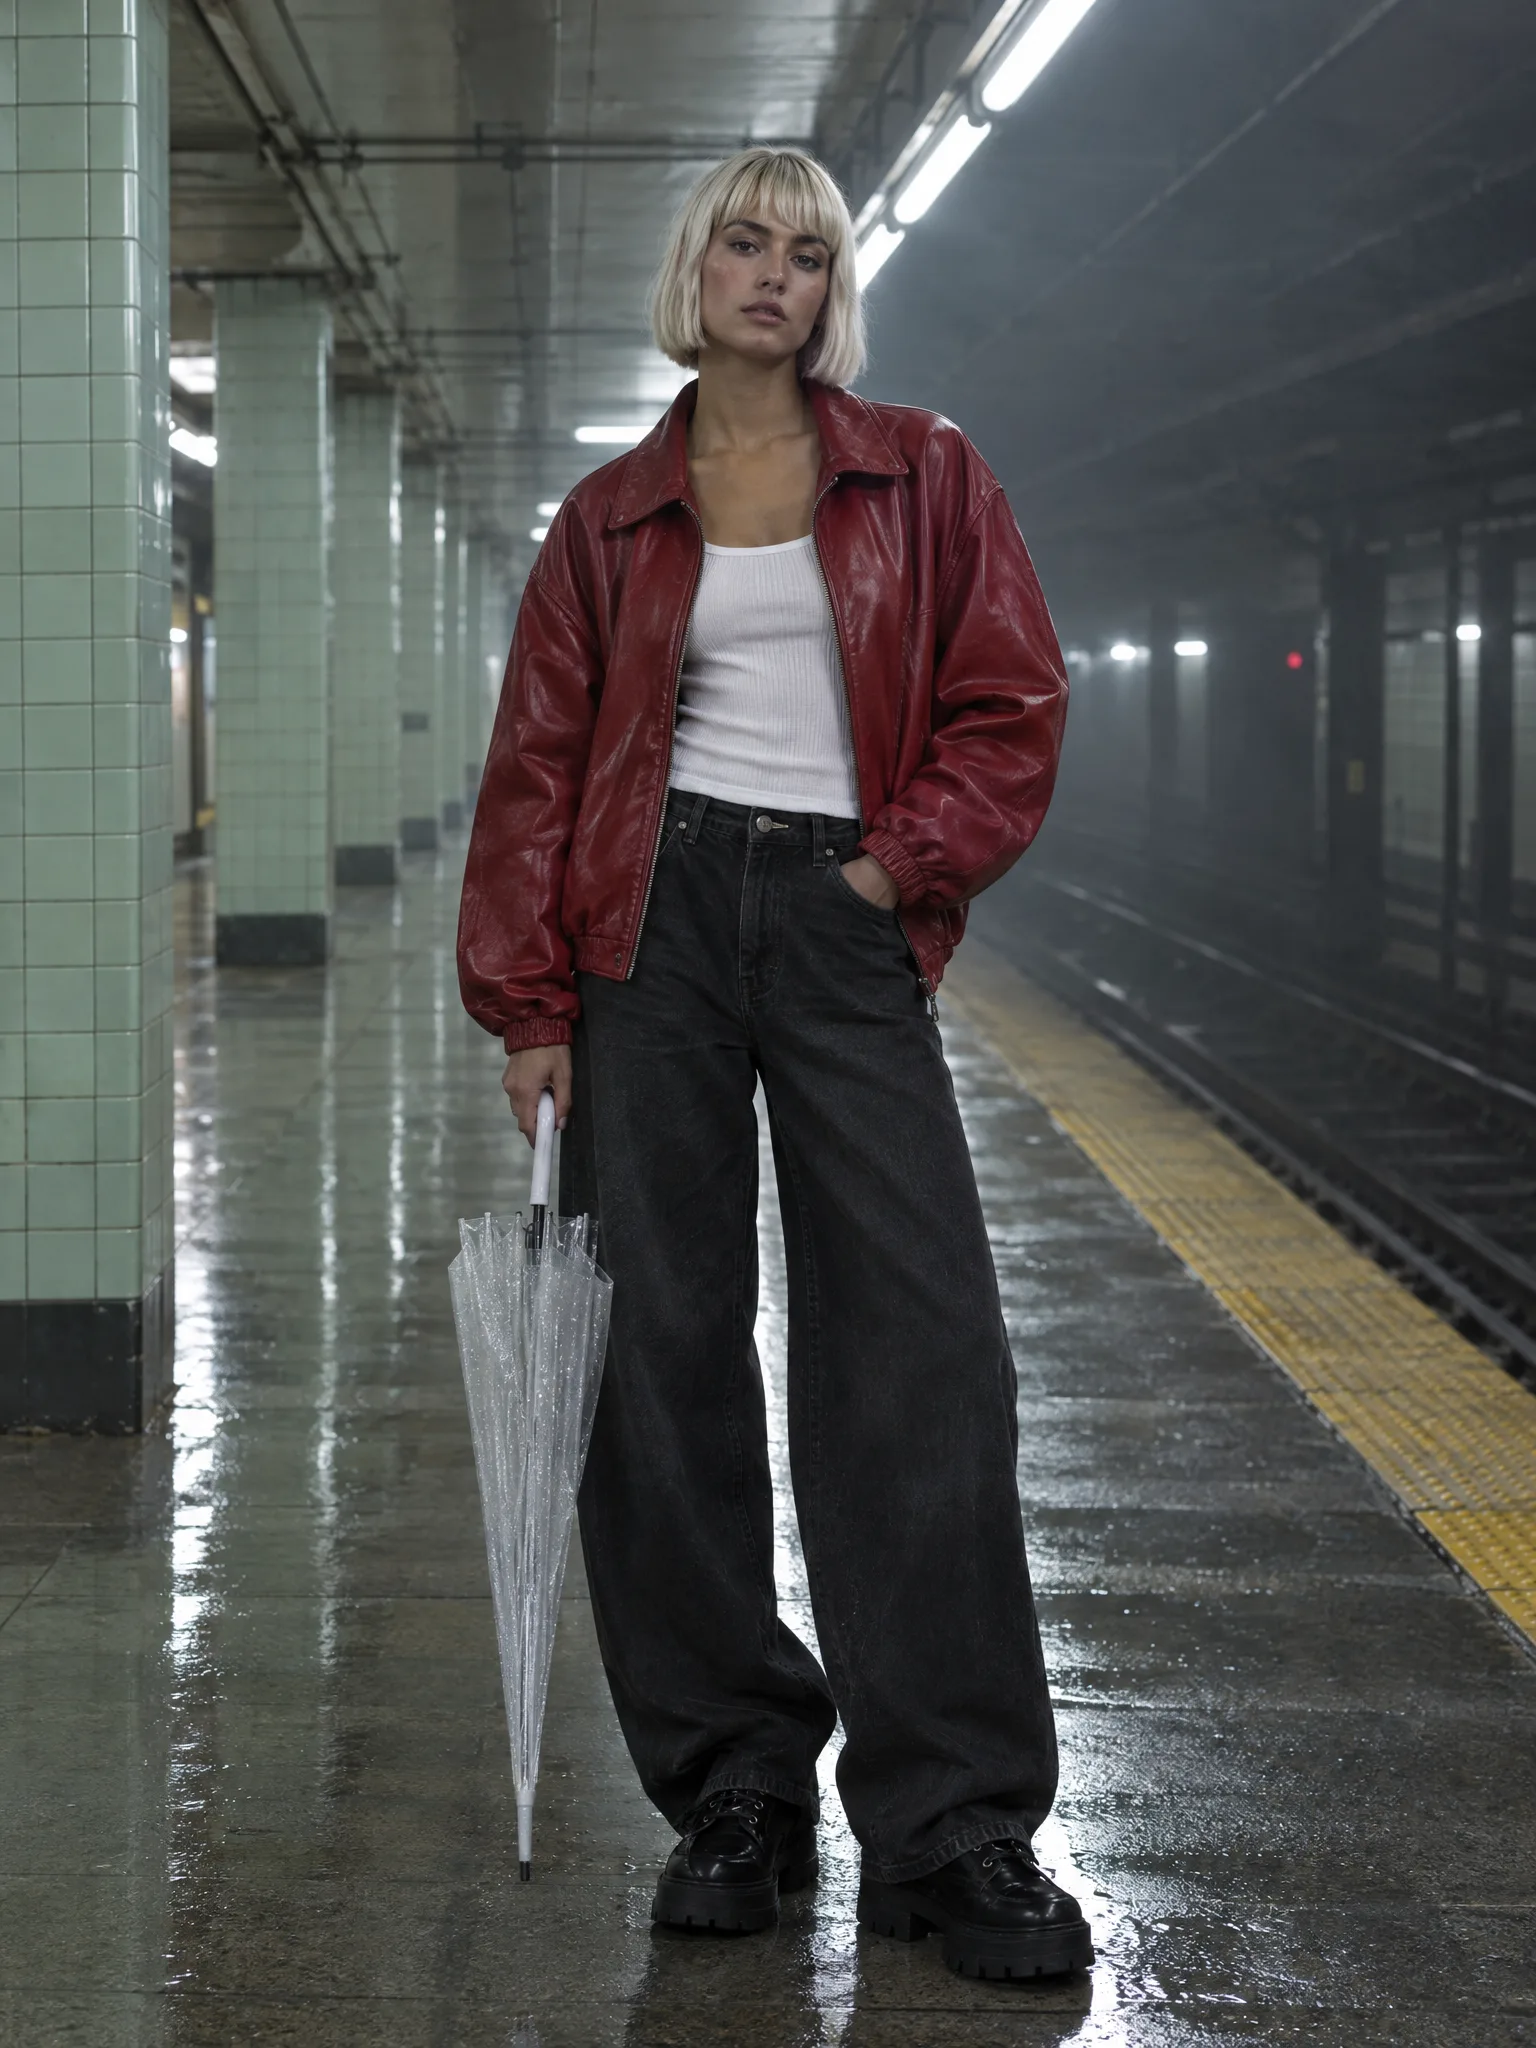
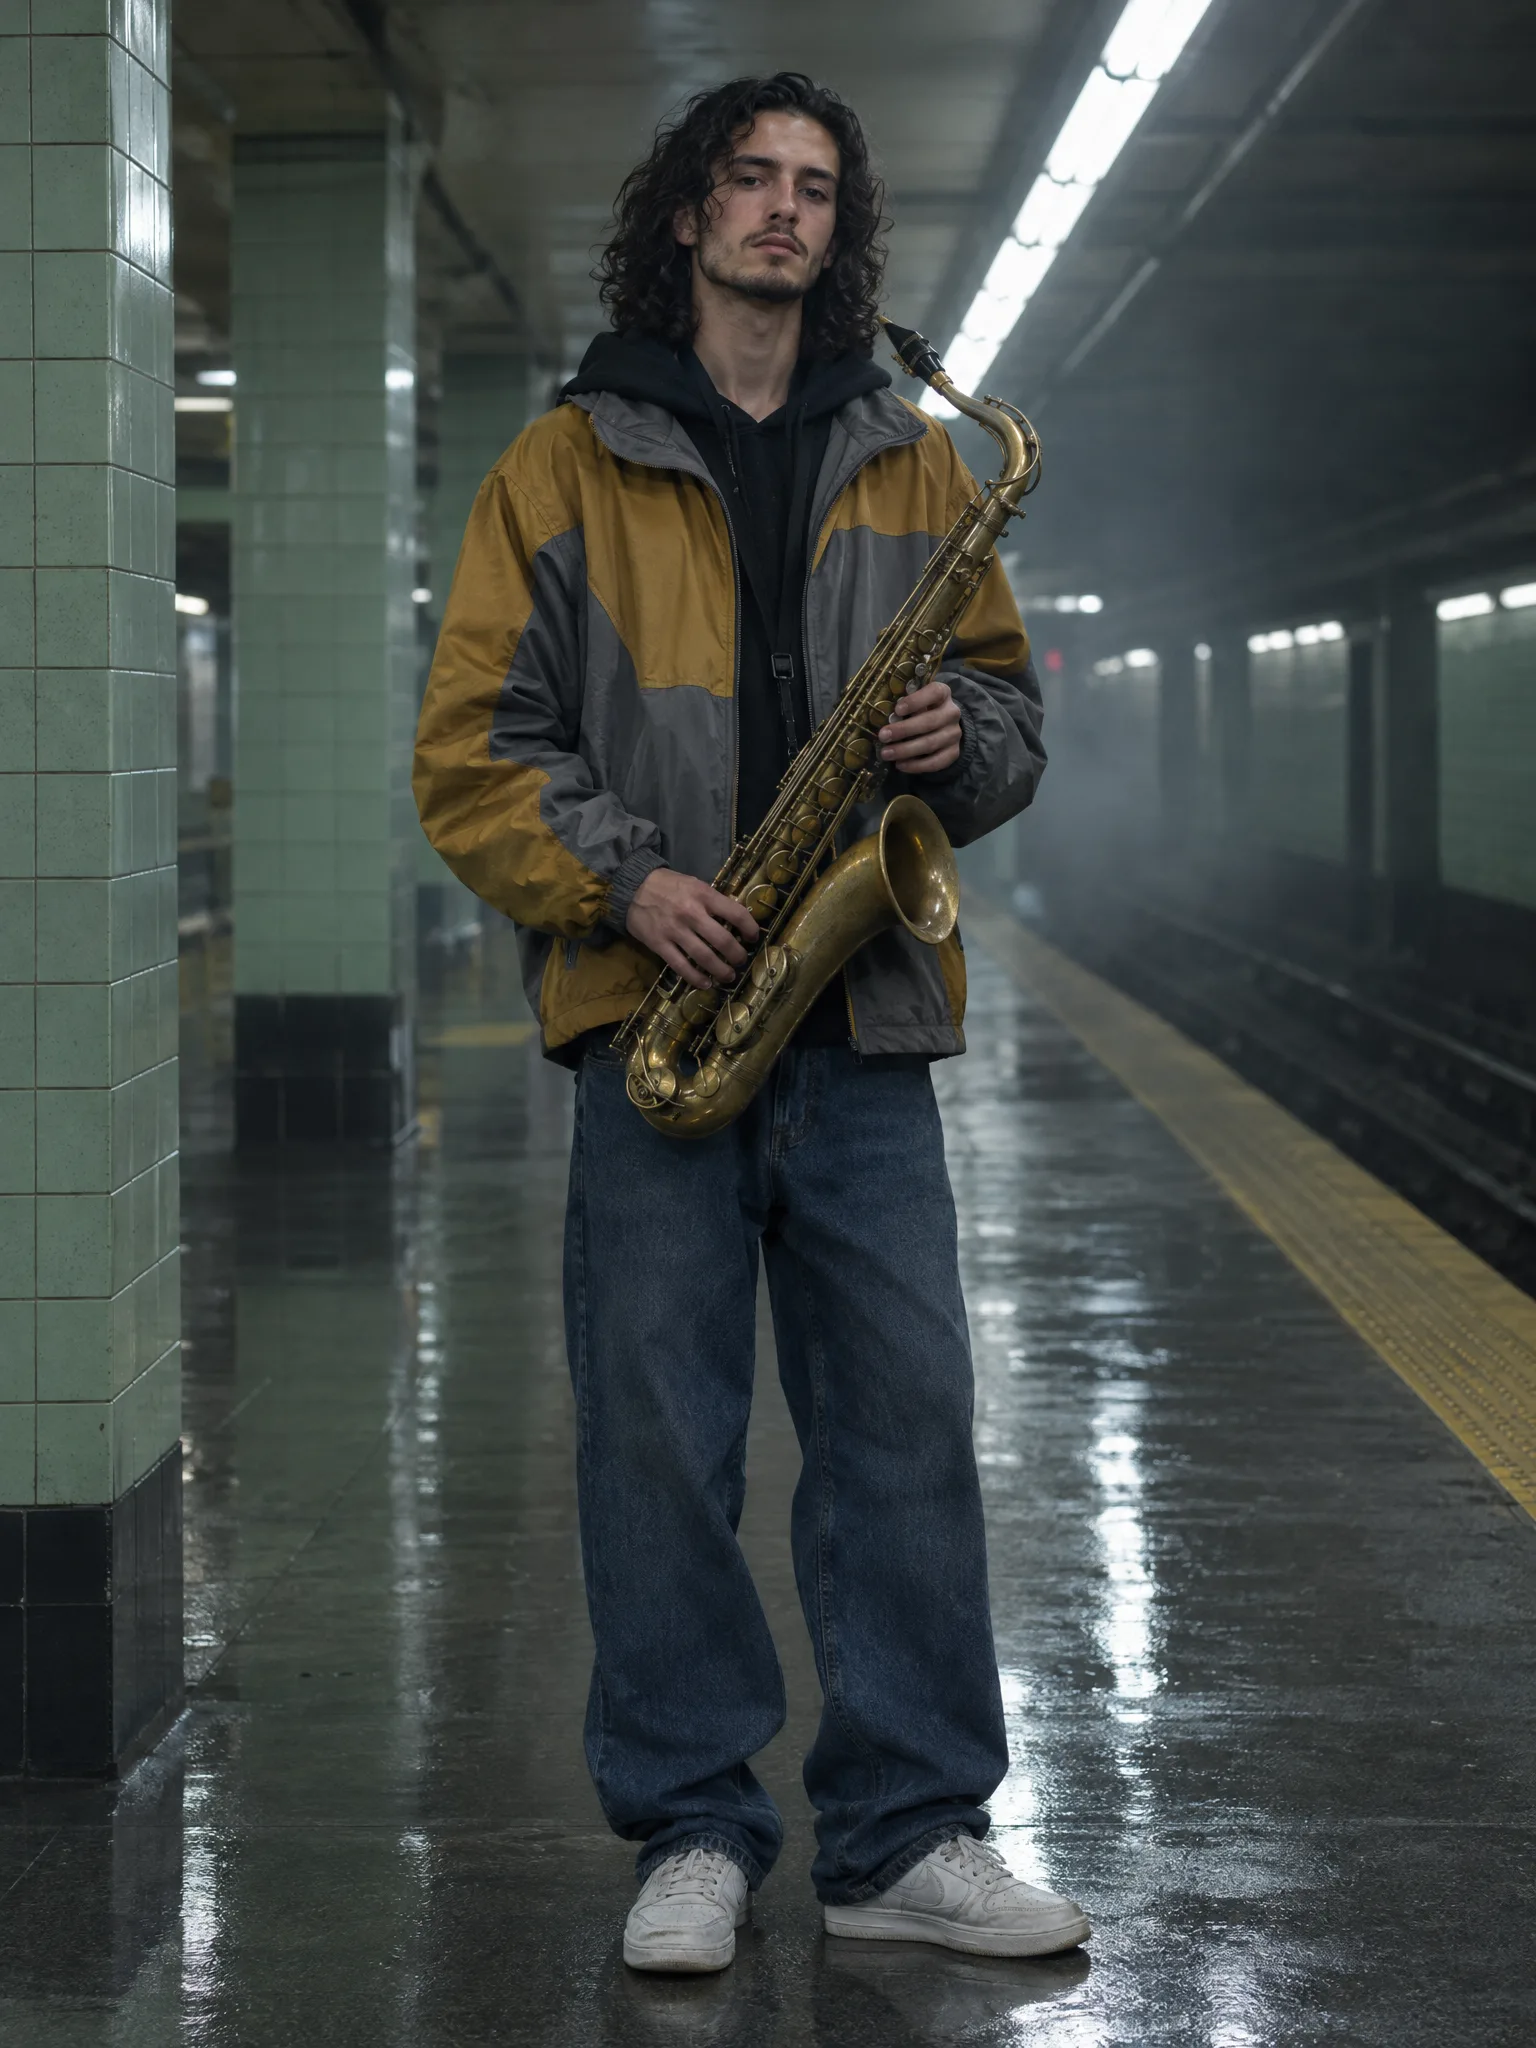
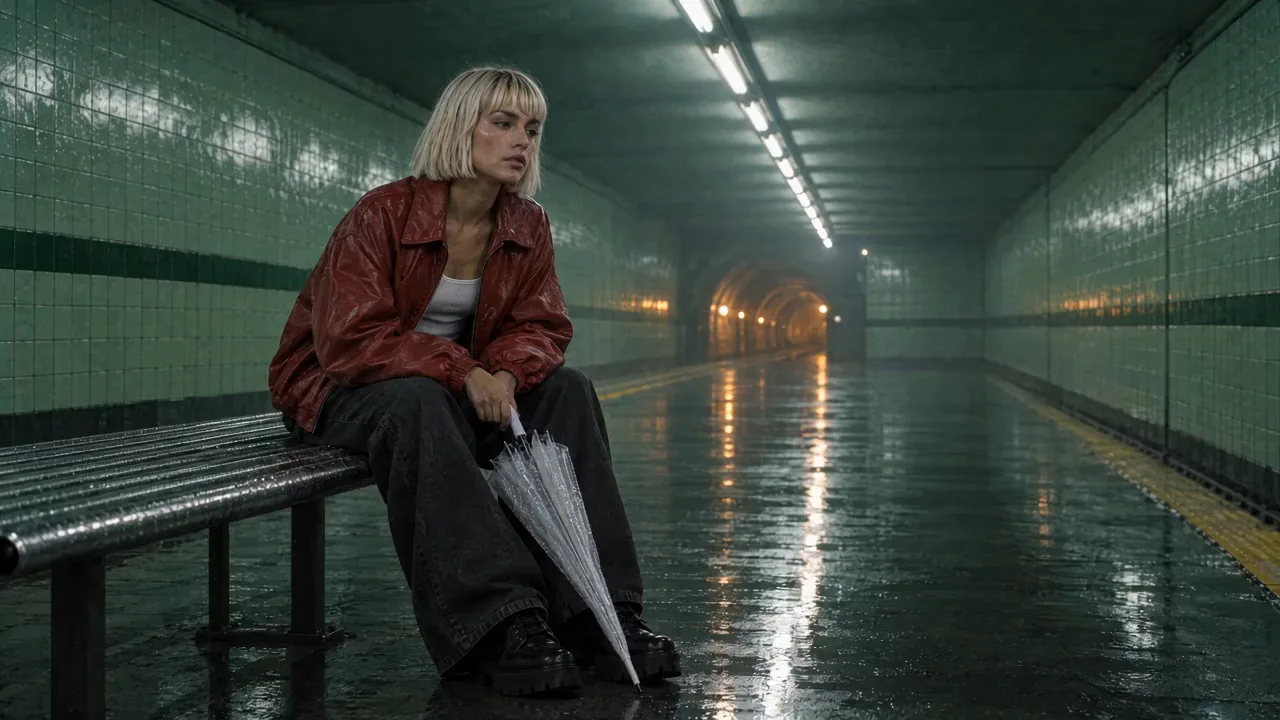
캐릭터를 엽니다. 이름과 캐릭터를 한 문장으로 설명하는 내용을 입력하고, 레퍼런스 이미지 추가를 열어 사진을 업로드하거나 초상화 프롬프트와 모델을 사용하여 생성을 누릅니다. 초상화를 레퍼런스로 선택한 후 캐릭터 만들기를 누릅니다. 베일의 초상화는 GPT Image 2.5 Flare로 만들어 그녀의 레퍼런스로 저장했으며, 오지도 같은 방식으로 처리했습니다.
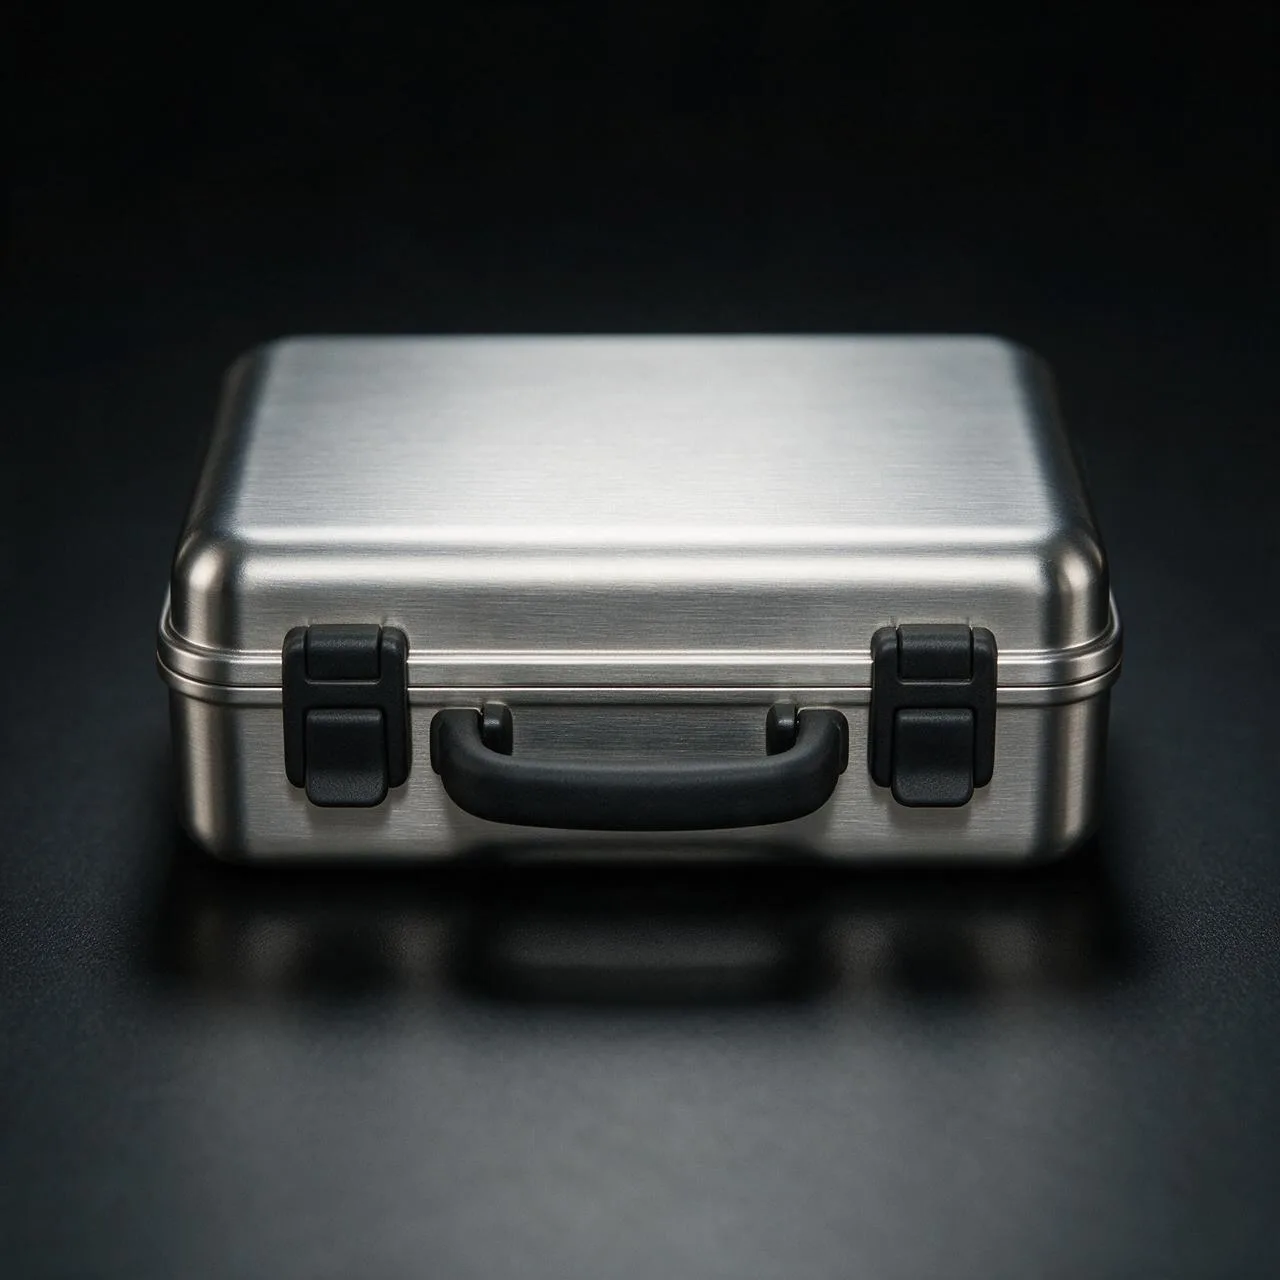
Full-length portrait of a woman in her early twenties, platinum blonde sleek chin-length bob with a straight fringe, light olive skin, bold brows, wearing an oversized cherry-red leather bomber jacket open over a white ribbed tank, wide black jeans and chunky black platform lace-up boots, holding a folded transparent bubble umbrella, standing on an underground subway platform with pale green tiles and cold fluorescent tubes along the ceiling, wet floor reflections, thin haze. Photoreal, cinematic, editorial fashion photograph, no text, no logos.장소를 열고 장소도 같은 방식으로 처리합니다: 이름, 설명, 표준 설명으로 사용할 한 문장, 그리고 라이브러리에서 가져온 정지 이미지나 업로드한 이미지를 추가합니다. 저희 플랫폼은 Seedream 5.0 Pro로 만든 정지 이미지입니다. 소품 역시 이미지 컴포저에서 만들어 라이브러리에 보관한 정지 이미지이며, 인서트 장면에서는 레퍼런스 이미지로, 다른 모든 프롬프트에서는 한 문장으로 사용됩니다.
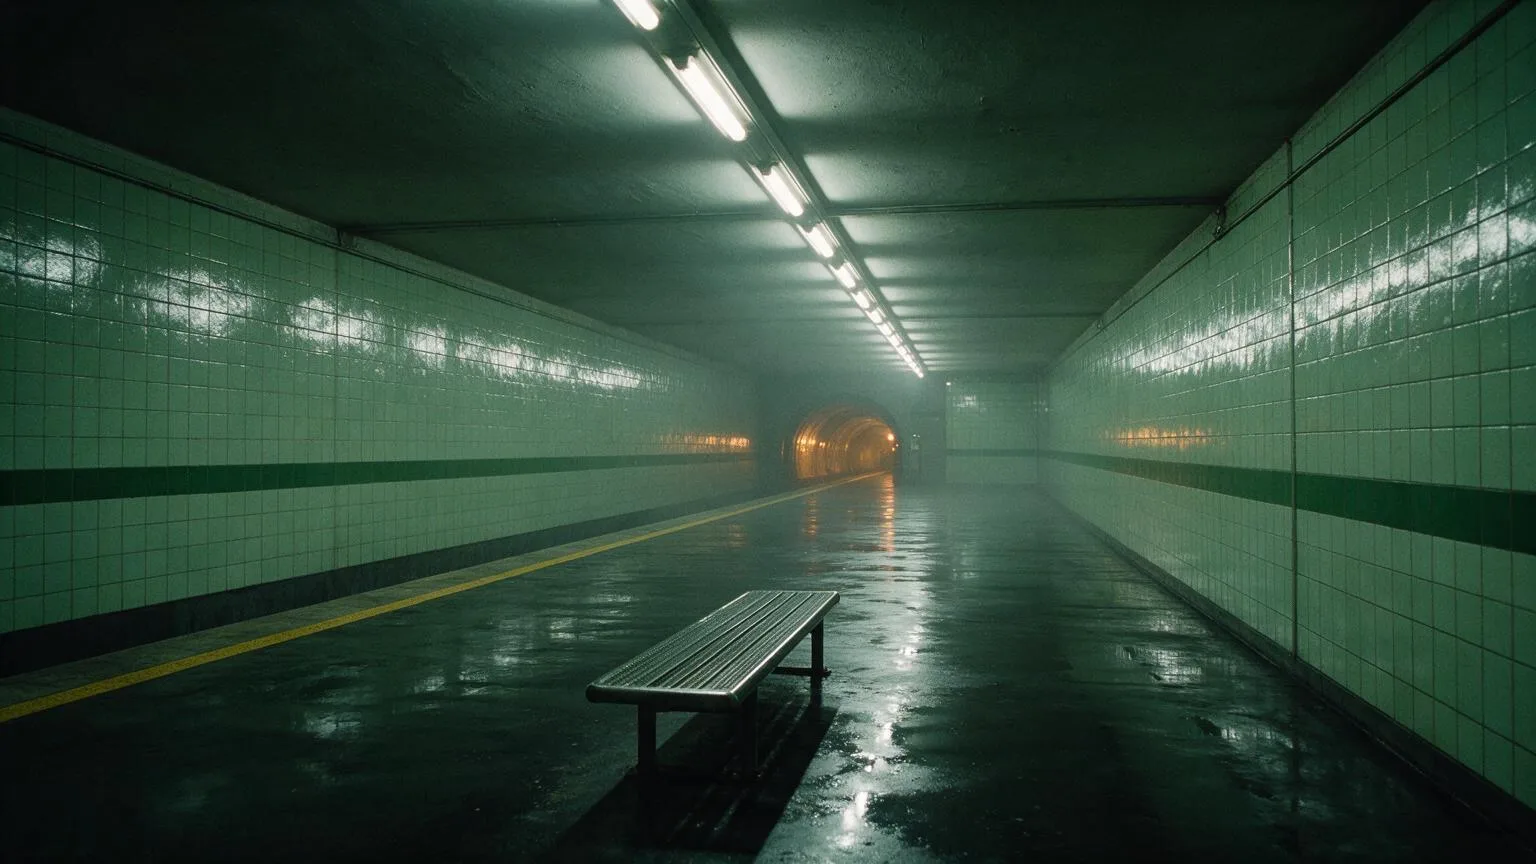
An empty underground subway platform at night: glossy pale green tiles with one dark green stripe at waist height, a long run of cold fluorescent tubes along the ceiling, wet floor with mirror reflections, thin haze, a yellow safety line along the platform edge, a single steel bench, the tunnel mouth glowing warm amber. No readable text or signs.각 샷을 먼저 프레임으로 만들기
이미지 컴포저를 엽니다. GPT Image 2.5 Flare를 선택하고, 비율을 16:9로 설정한 다음, 캐릭터를 눌러 베일을 선택하고, 장소를 눌러 할사이온 스트리트 역을 선택합니다. 컴포저에 각 항목의 칩이 표시됩니다. 한 순간으로 샷을 작성하고, 프롬프트에서 @ 기호로 캐릭터를 지정한 후, 이미지 생성을 누릅니다. 5개의 프레임, 즉 샷당 1개는 영상 테이크 하나보다 비용이 적게 들며, 의상, 소품, 구도가 고정되는 단계입니다.
@Vale mid-sprint along the empty platform toward the camera, her red leather bomber flying open over the white tank, the folded transparent umbrella in her left hand and a small brushed-chrome hard-shell case with a black rubber handle and two black latches in her right, black platform boots splashing the wet tiles. Wide low shot, the cold fluorescent tubes above her, thin haze, the tunnel glowing warm amber behind. Cinematic film still, anamorphic, fine grain, no text.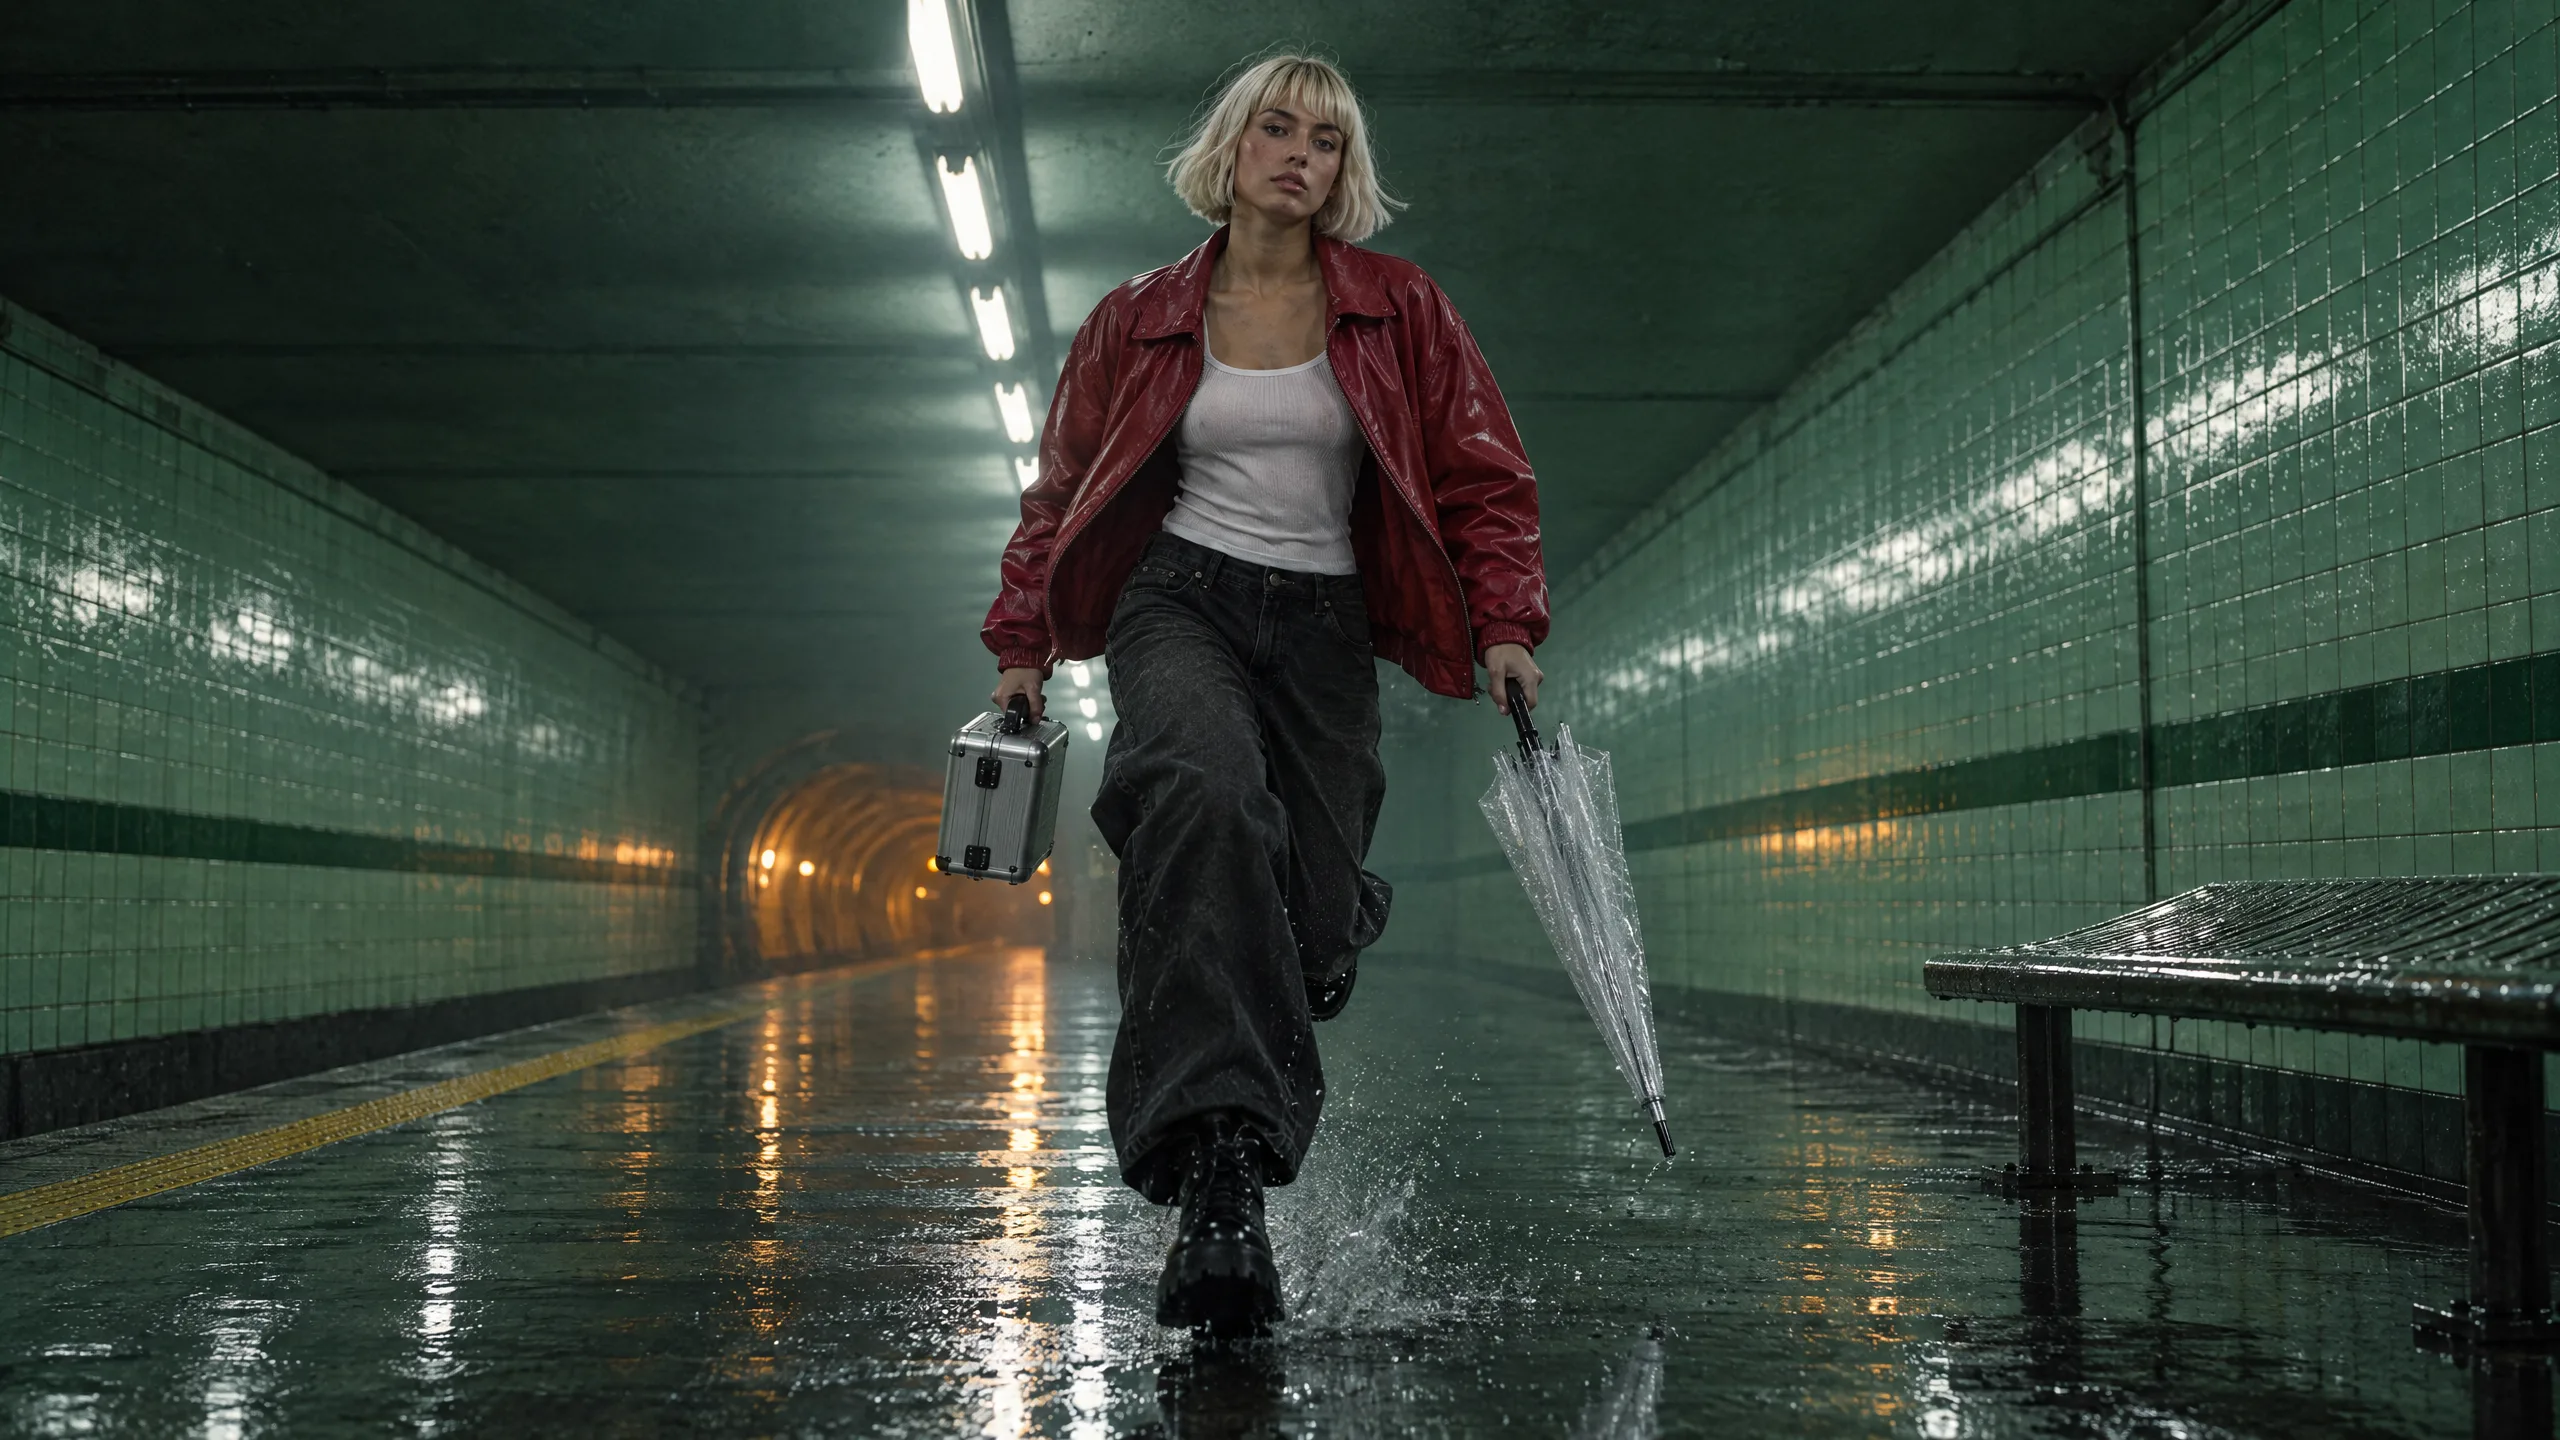
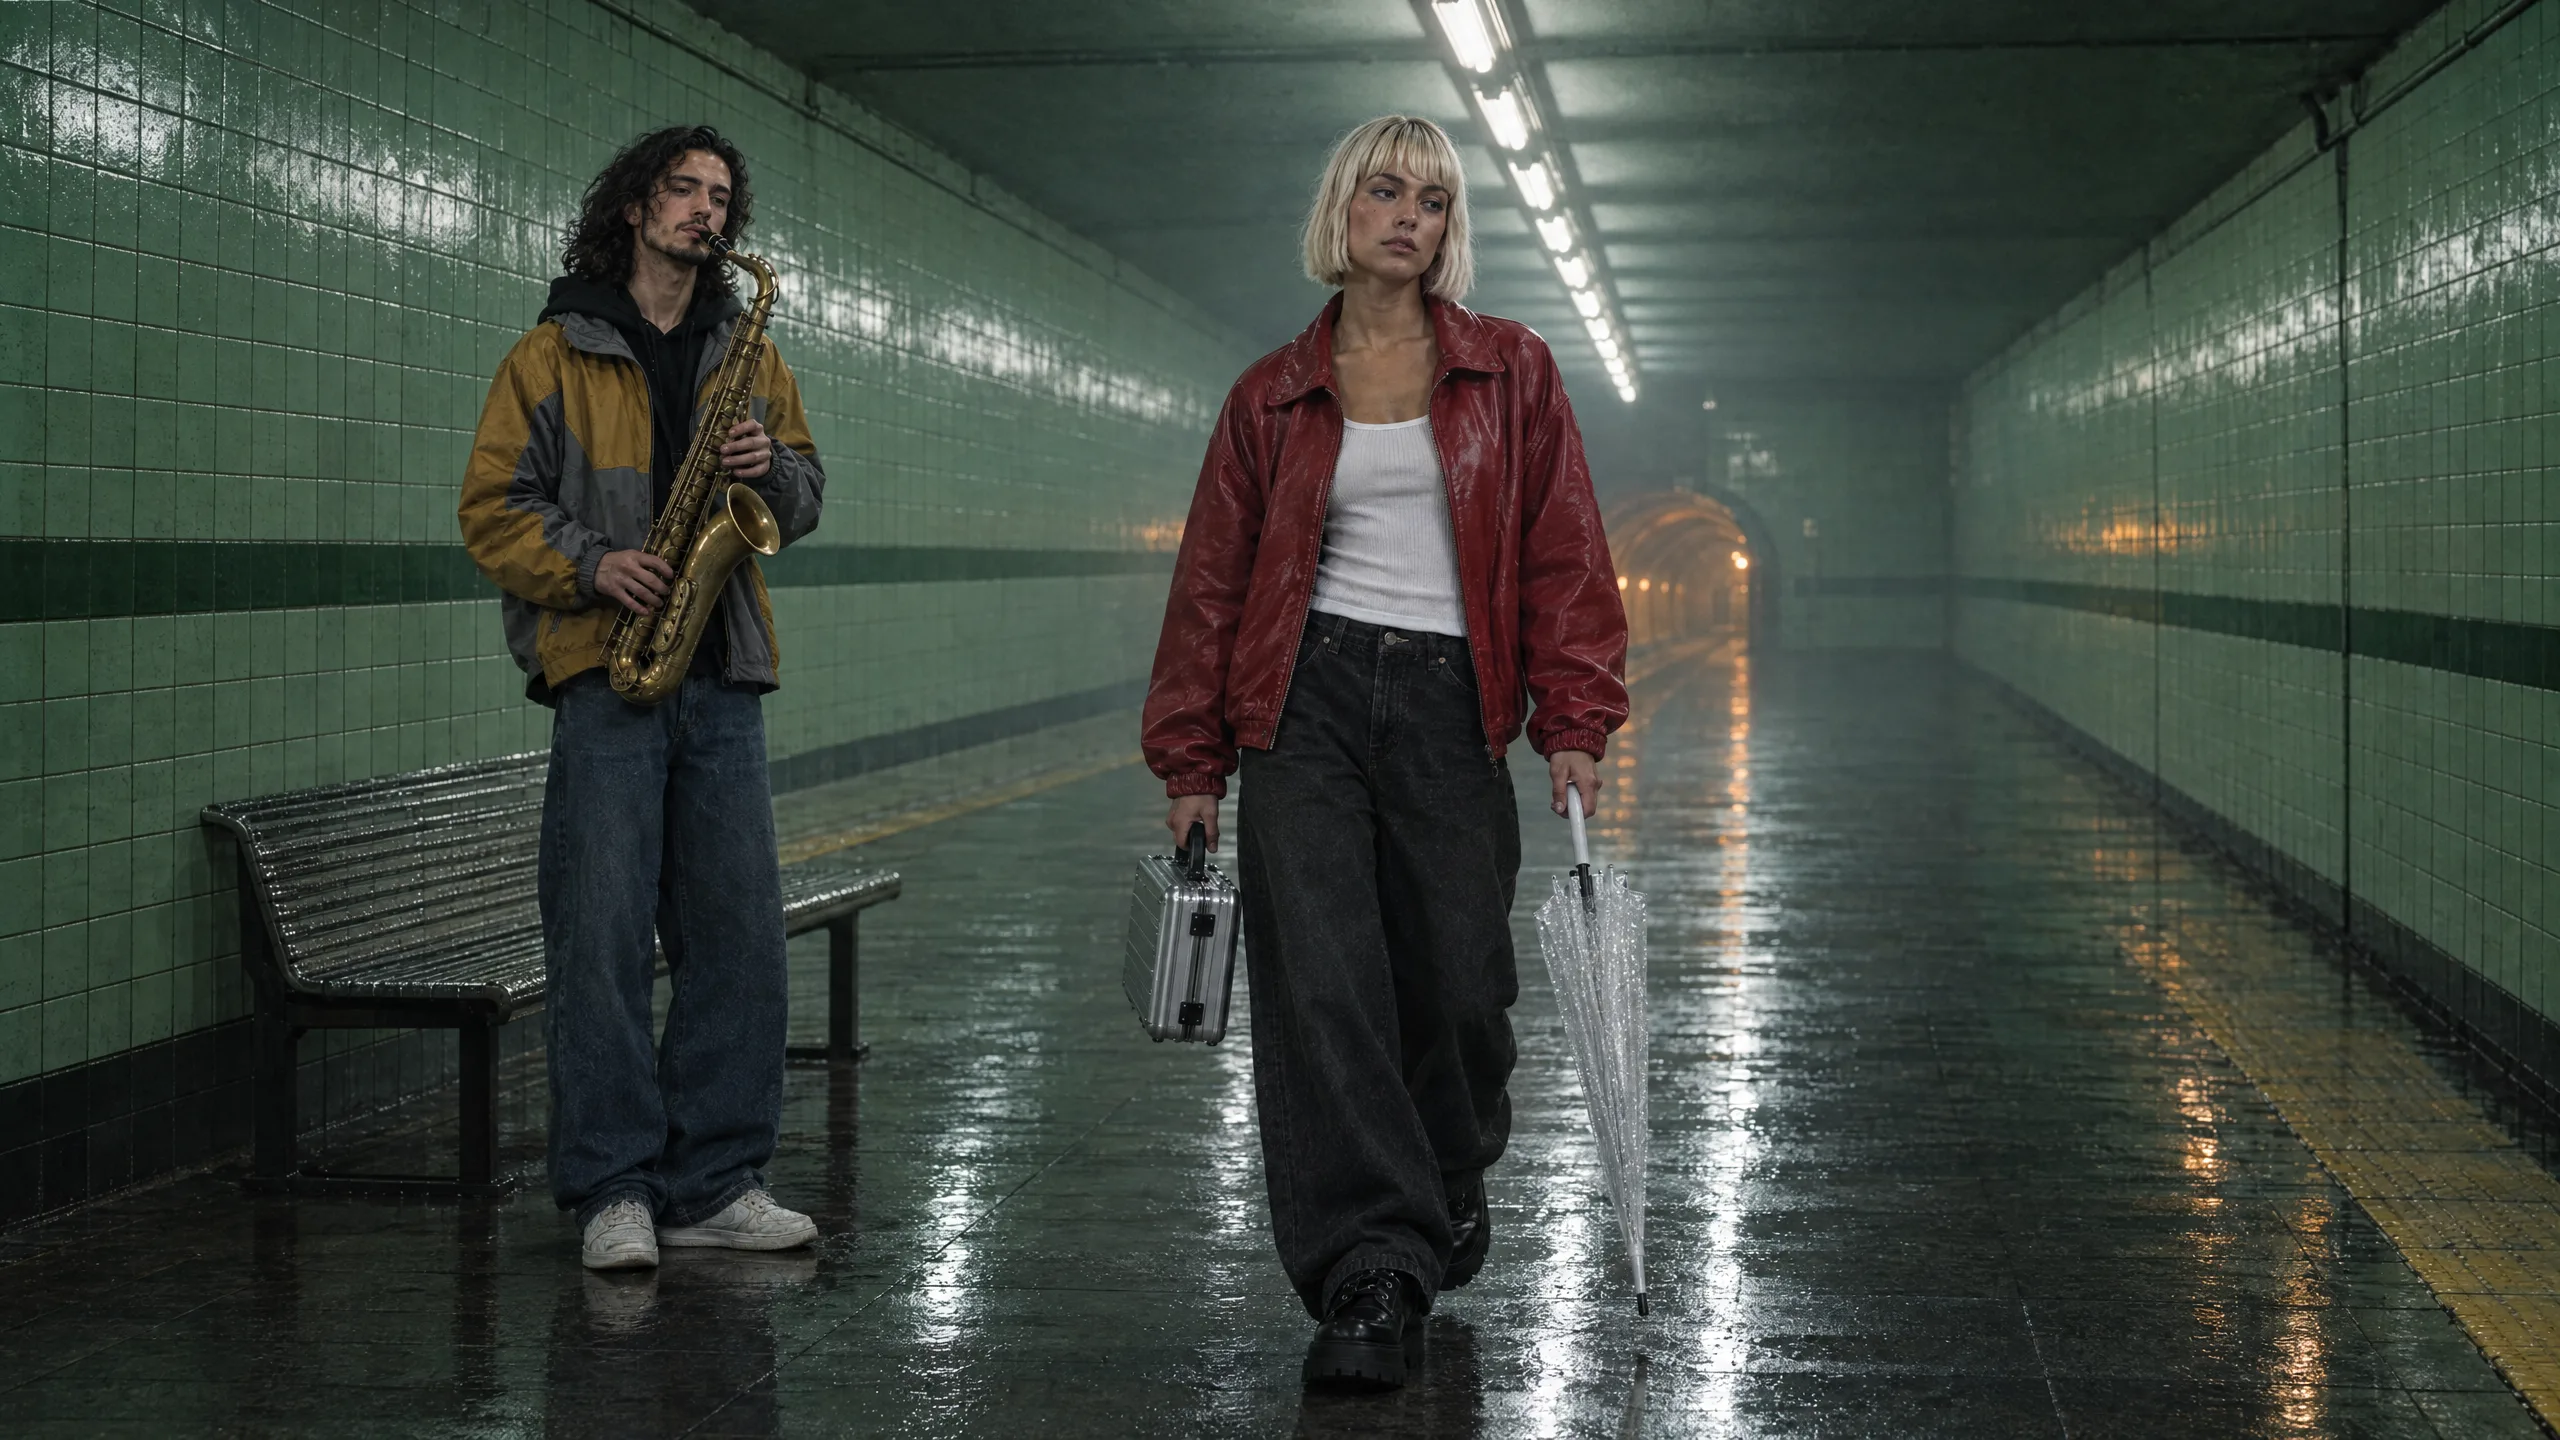
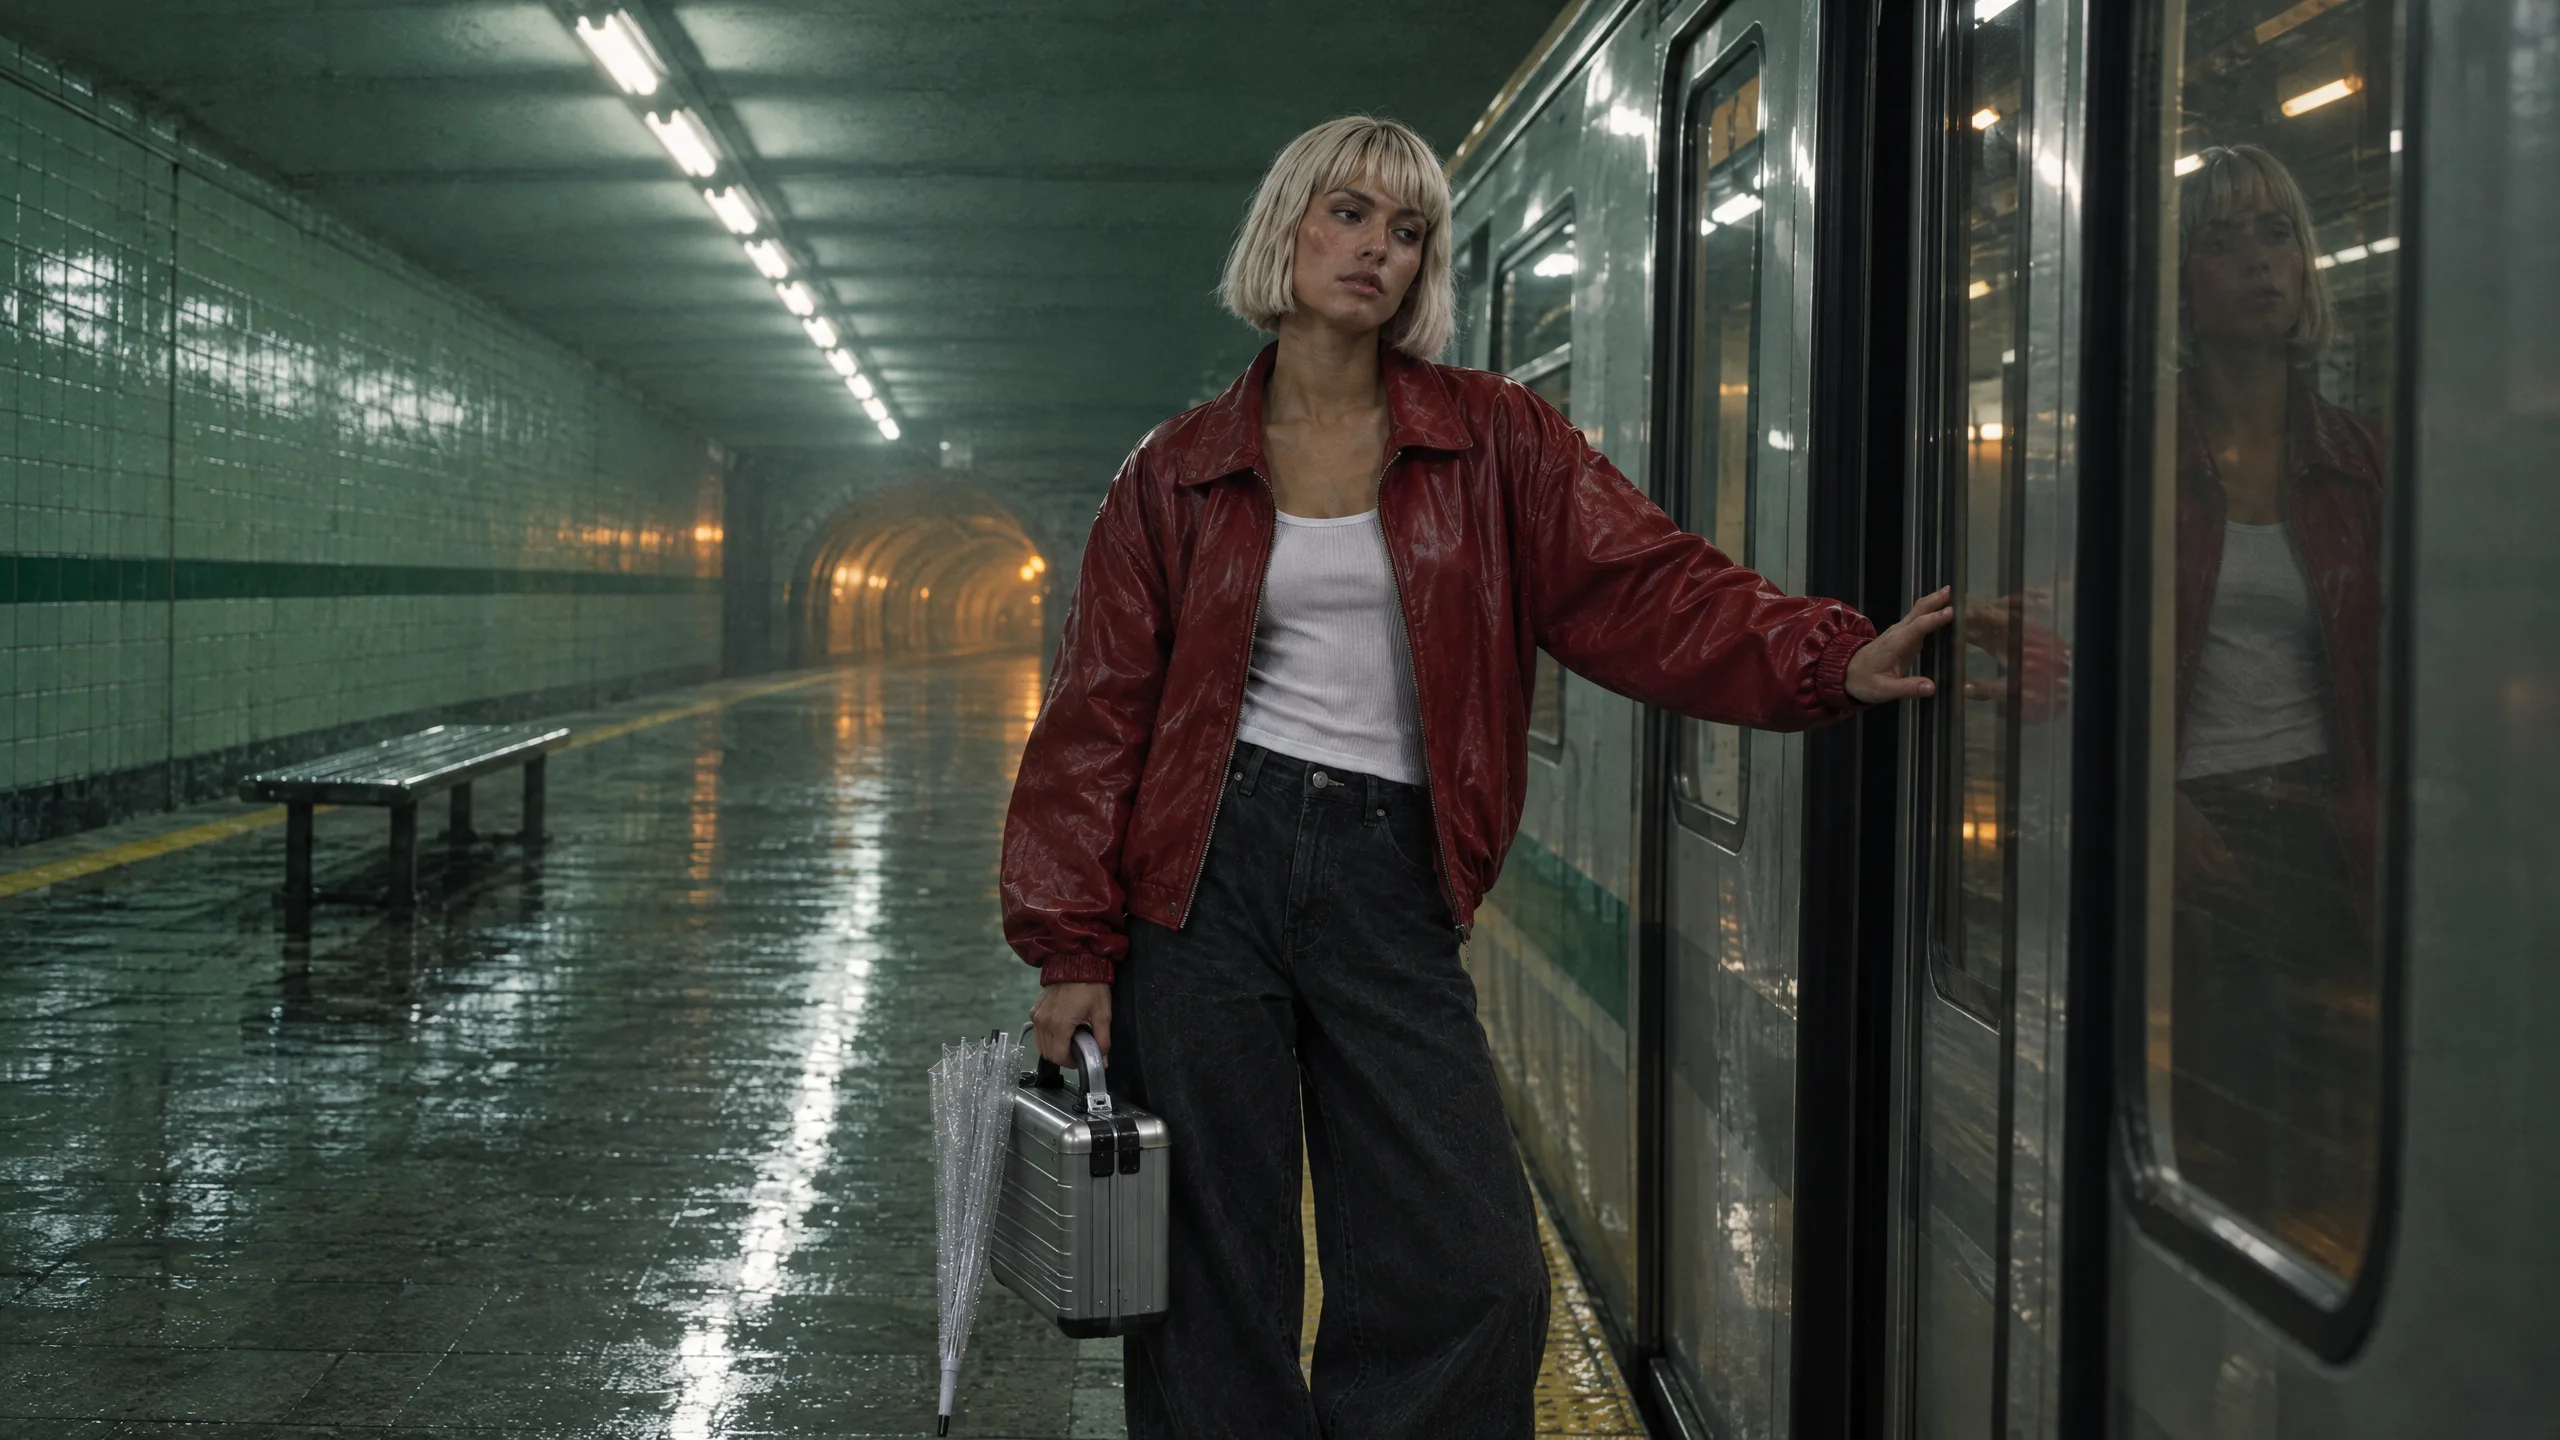
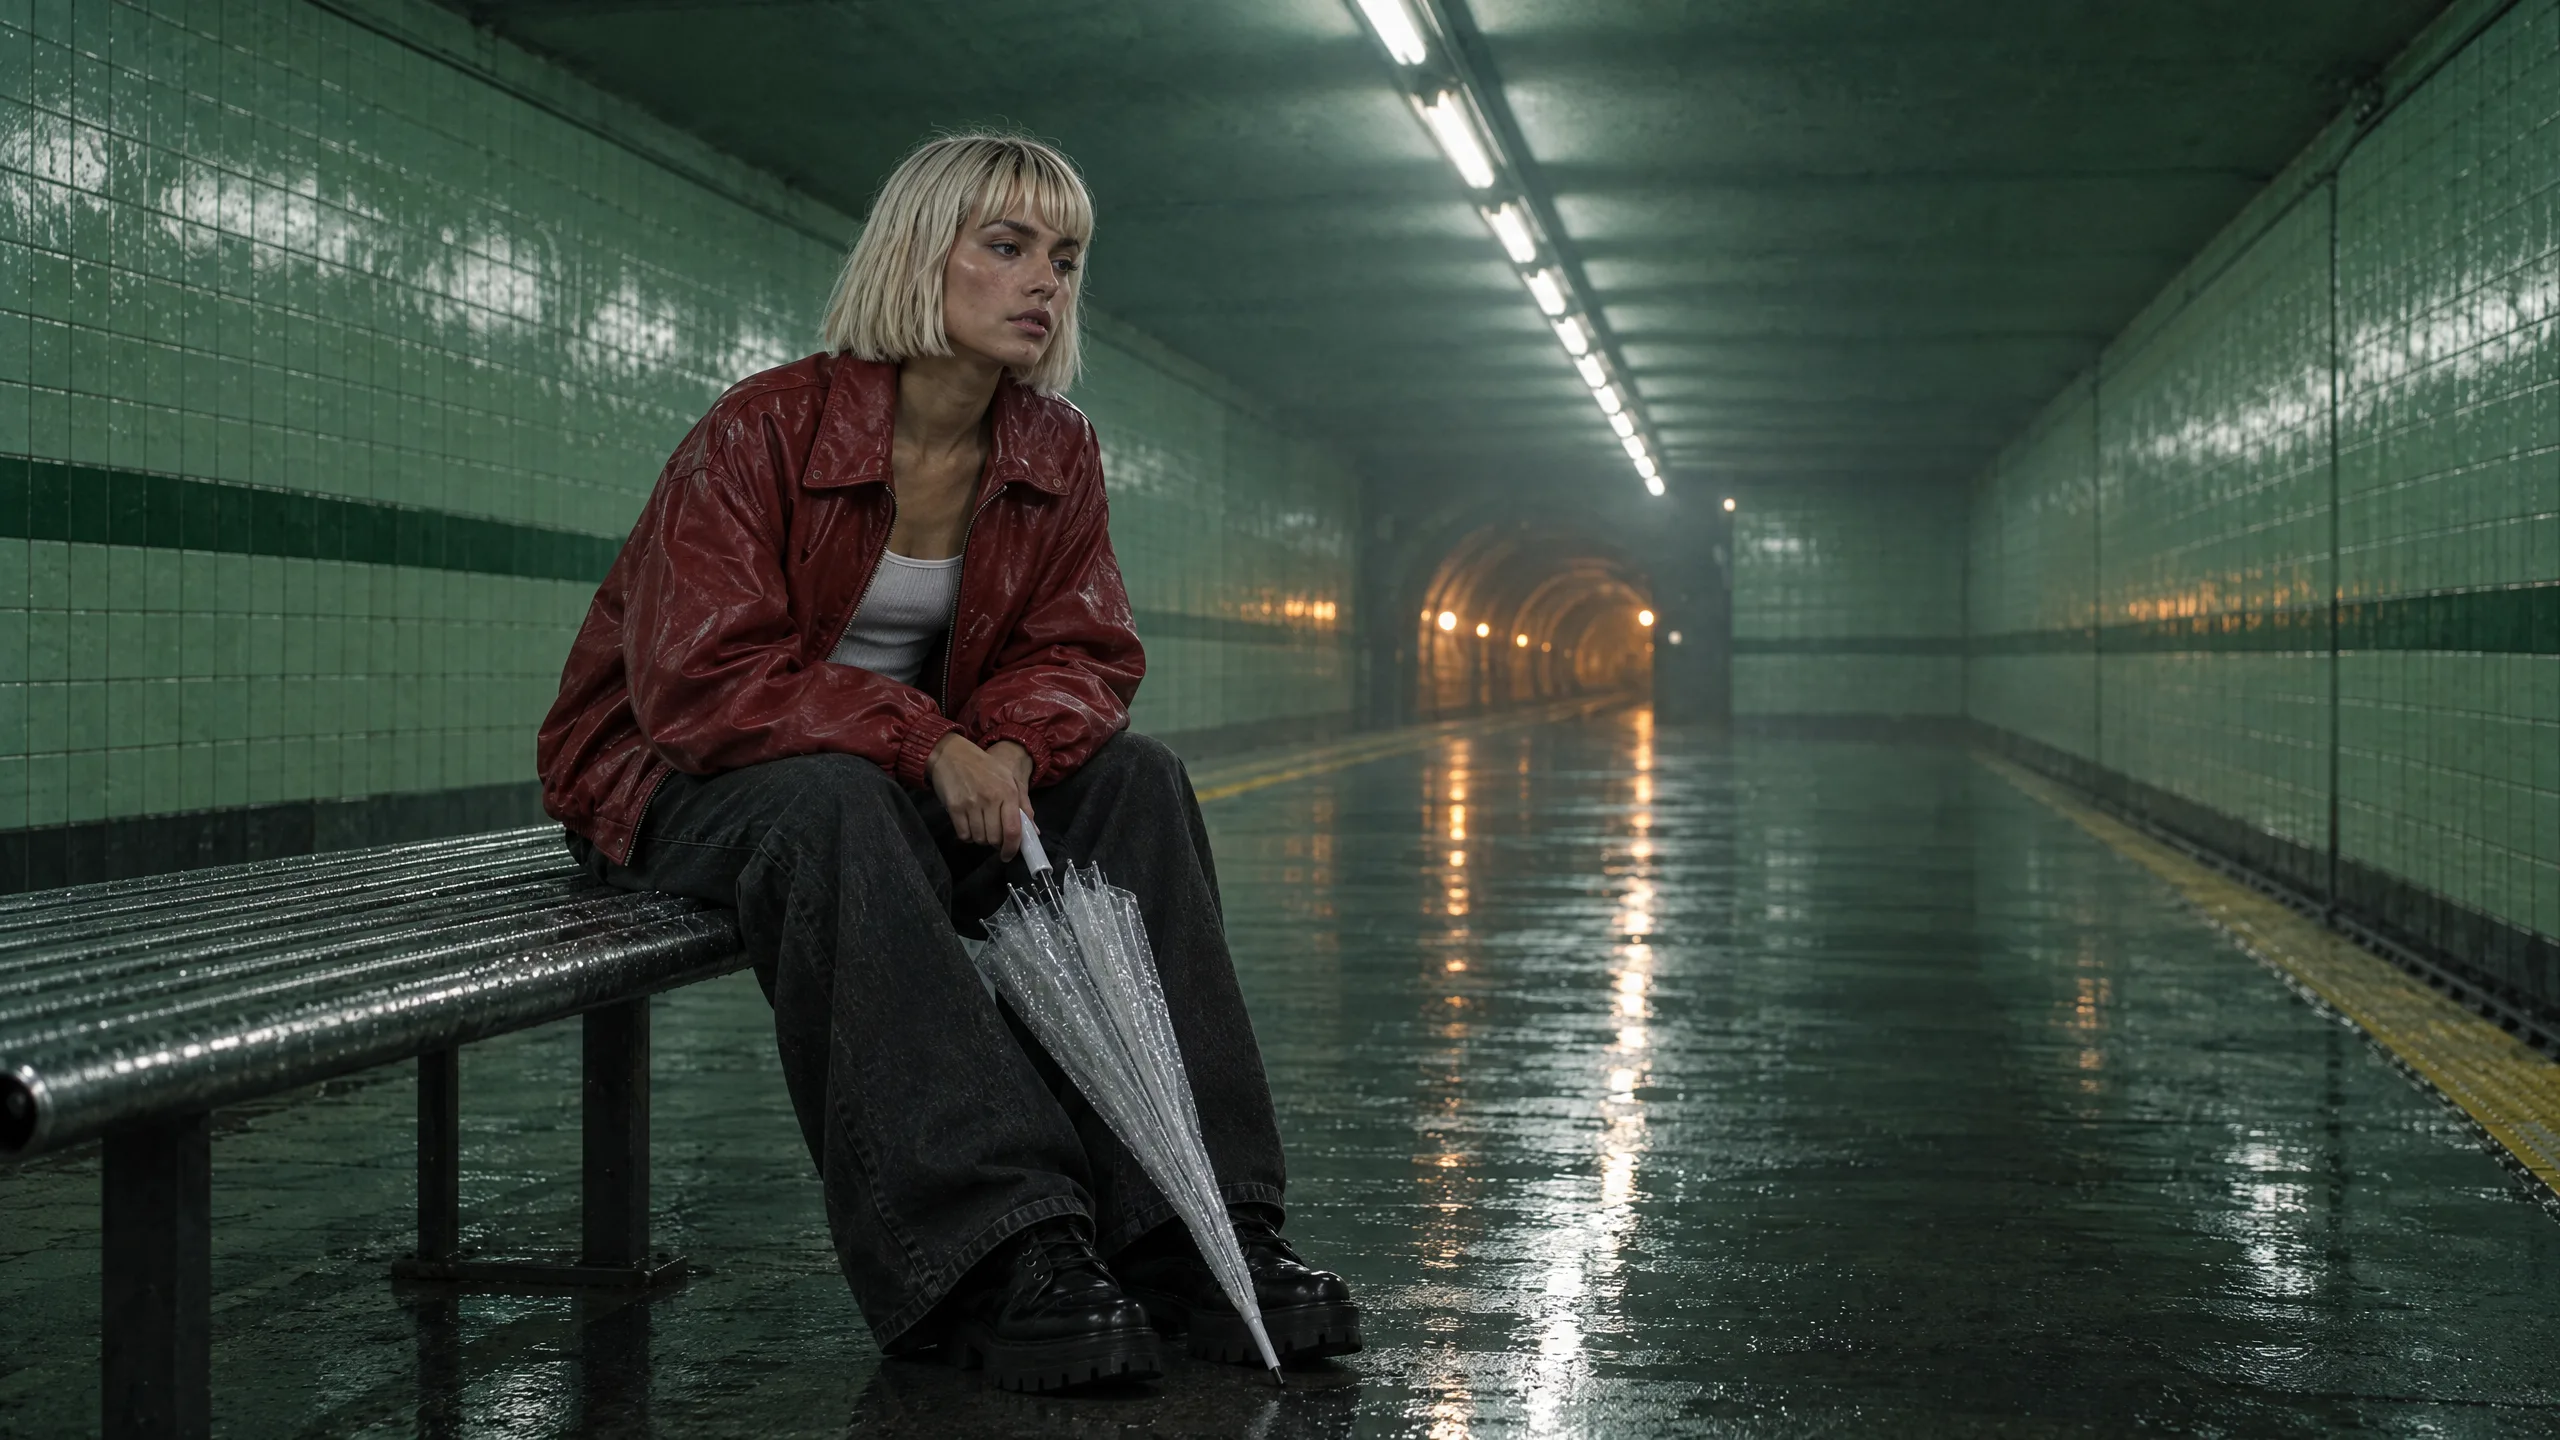
팁:두 사람이 한 화면에 있을 때 누가 어디에 서는지 이름으로 지정하기. 프레임 2는 누가 누구를 지나가는지, Ozzy가 어디에 서 있는지, 그리고 그녀가 무엇을 들고 있는지를 나타냅니다. 이 부분의 첫 번째 버전에서는 문장에서 케이스를 생략했기 때문에 프레임에 케이스가 없었습니다. 출연진에 두 명의 캐릭터가 있는 경우, 컴포저는 선택한 순서대로 캐릭터에 번호를 매기며, 프롬프트의 @Vale와 @Ozzy는 해당 참조로 해결됩니다.
프레임을 샷으로 애니메이션화하기
비디오 컴포저를 열고, 시작 기준에서 이미지 애니메이션을 선택한 후, 시작 프레임 추가를 누르고, 에셋 고르기를 눌러 라이브러리에서 프레임을 선택하세요. 이 프레임이 클립의 첫 번째 프레임이 됩니다. 그 프레임부터 일어나는 행동을 작성하고, 카메라 무브 칩을 누르고, 길이를 설정한 후 생성하세요. 우리는 가장 움직임이 많은 샷인 스프린트에는 Kling v3를, 나머지 네 개의 샷에는 720p의 Seedance 2.5를 사용했으며, 각 샷은 4~6초 길이로 설정하고 그중 하나를 Studio에서 더 짧게 편집했습니다. 달리기, 점프 또는 무게감이 있는 동작의 경우, Kling v3 또는 Seedance 2.5로 프레임을 애니메이션화하세요.
She sprints straight toward the camera along the platform, the red leather bomber flying open, the chrome case in her right hand and the folded umbrella in her left, black platform boots splashing the wet tiles, hair bouncing with each stride, the cold fluorescent tubes and the warm amber tunnel glow behind her. Real sprint physics, cinematic, anamorphic, fine film grain.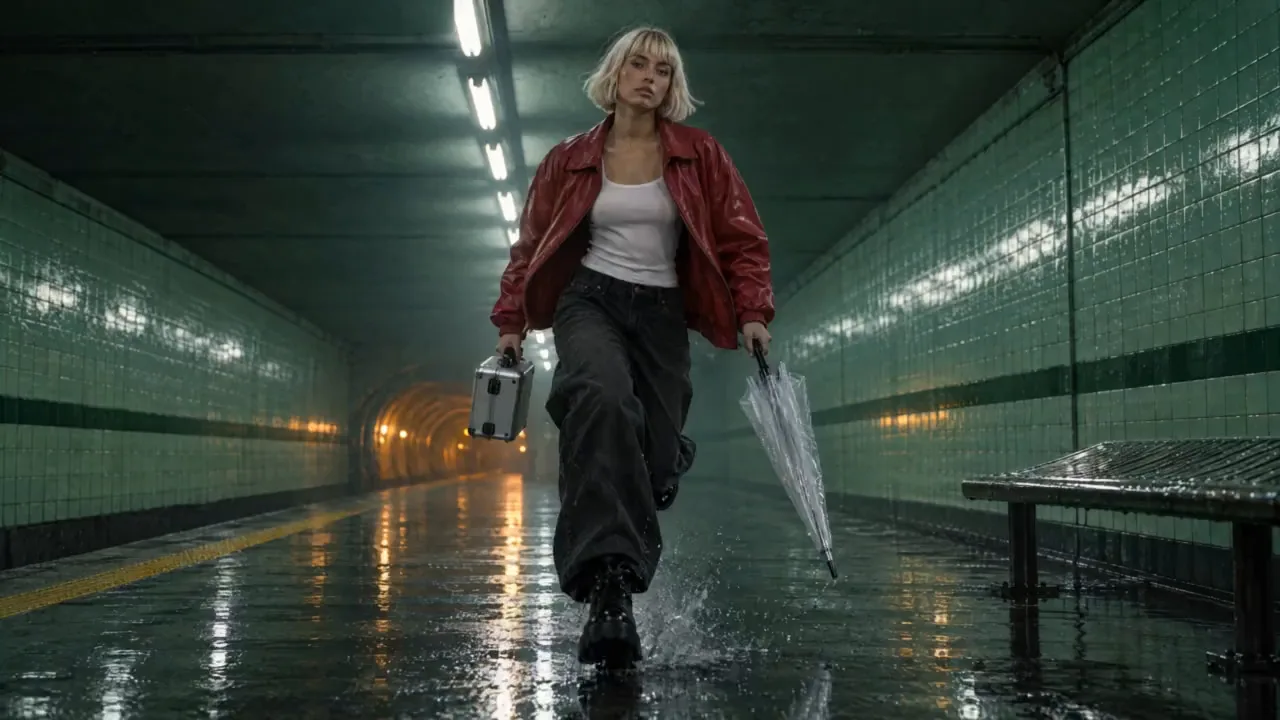
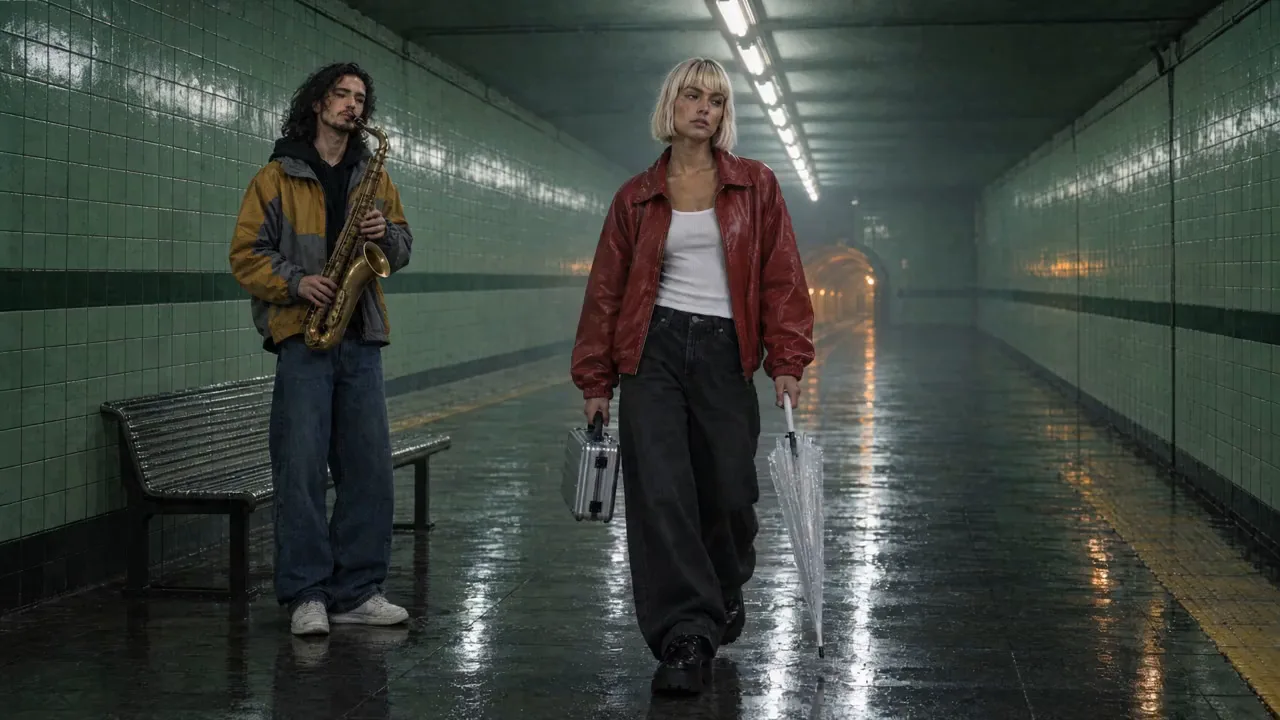
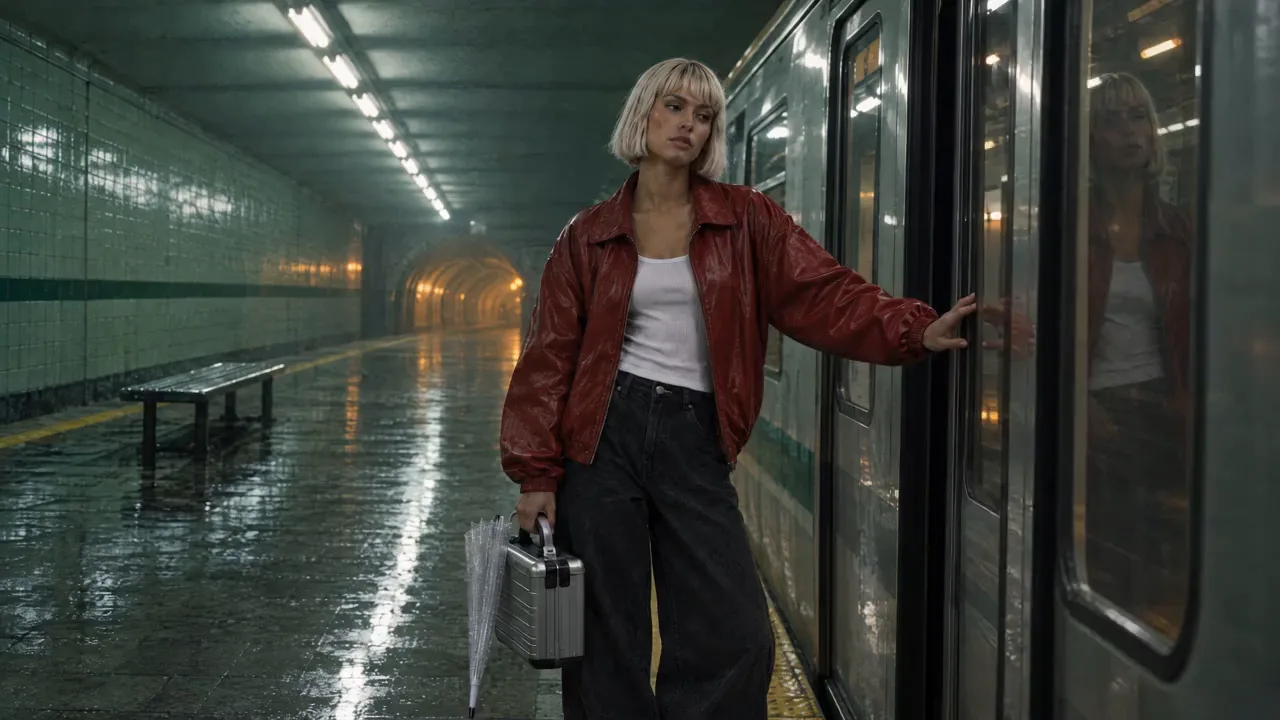
주의:왜 캐릭터를 바로 비디오 모델에 넣지 않고 프레임을 먼저 사용하는가. 우리는 세 가지 모델로 직접적인 방식을 시도했습니다. Seedance 2.0 Fast는 크레딧 차감 전에 Vale의 참조 이미지를 거부하며 실제 사람의 사진처럼 보인다고 했습니다. Seedance 1.5 Pro도 거부했습니다. 이 모델은 캐릭터 참조 이미지를 전혀 사용할 수 없습니다. Seedance 2.5는 그녀를 받아 16:9 클립을 만들었지만, 캐릭터만 그 경로로 전달되기 때문에 기둥이 있고 초록색 줄이나 호박색 터널이 없는 자체 플랫폼에서 생성되었습니다. 출연진과 장소가 연결된 16:9 프레임을 애니메이션화하면 두 요소 모두 포함됩니다.
음악 및 효과
대사가 없는 영화이므로 사운드는 오디오 컴포저에서 두 단계로 작업합니다. Lyria 3.5로 만든 스코어와 ElevenLabs Sound Effects v2로 만든 두 가지 효과음(문이 닫히는 소리와 달리는 부츠 소리)을 추가합니다. 스코어는 템포와 분위기로 설명하고, 각 효과음은 하나의 이벤트로 설명하세요.
A tense, driving electronic cue at 118 bpm for a short film about missing the last train: pulsing arpeggiated synth, deep sub bass, a ticking hi-hat, a sudden drop to a single warm pad at the end, no vocals, cinematic underground nightSubway train doors closing: a two-tone chime, a pneumatic hiss, doors thud shut, then the train accelerates away through a tunnel with a rising electric whine and echo, station reverbStudio에서 편집, 색보정 및 내보내기
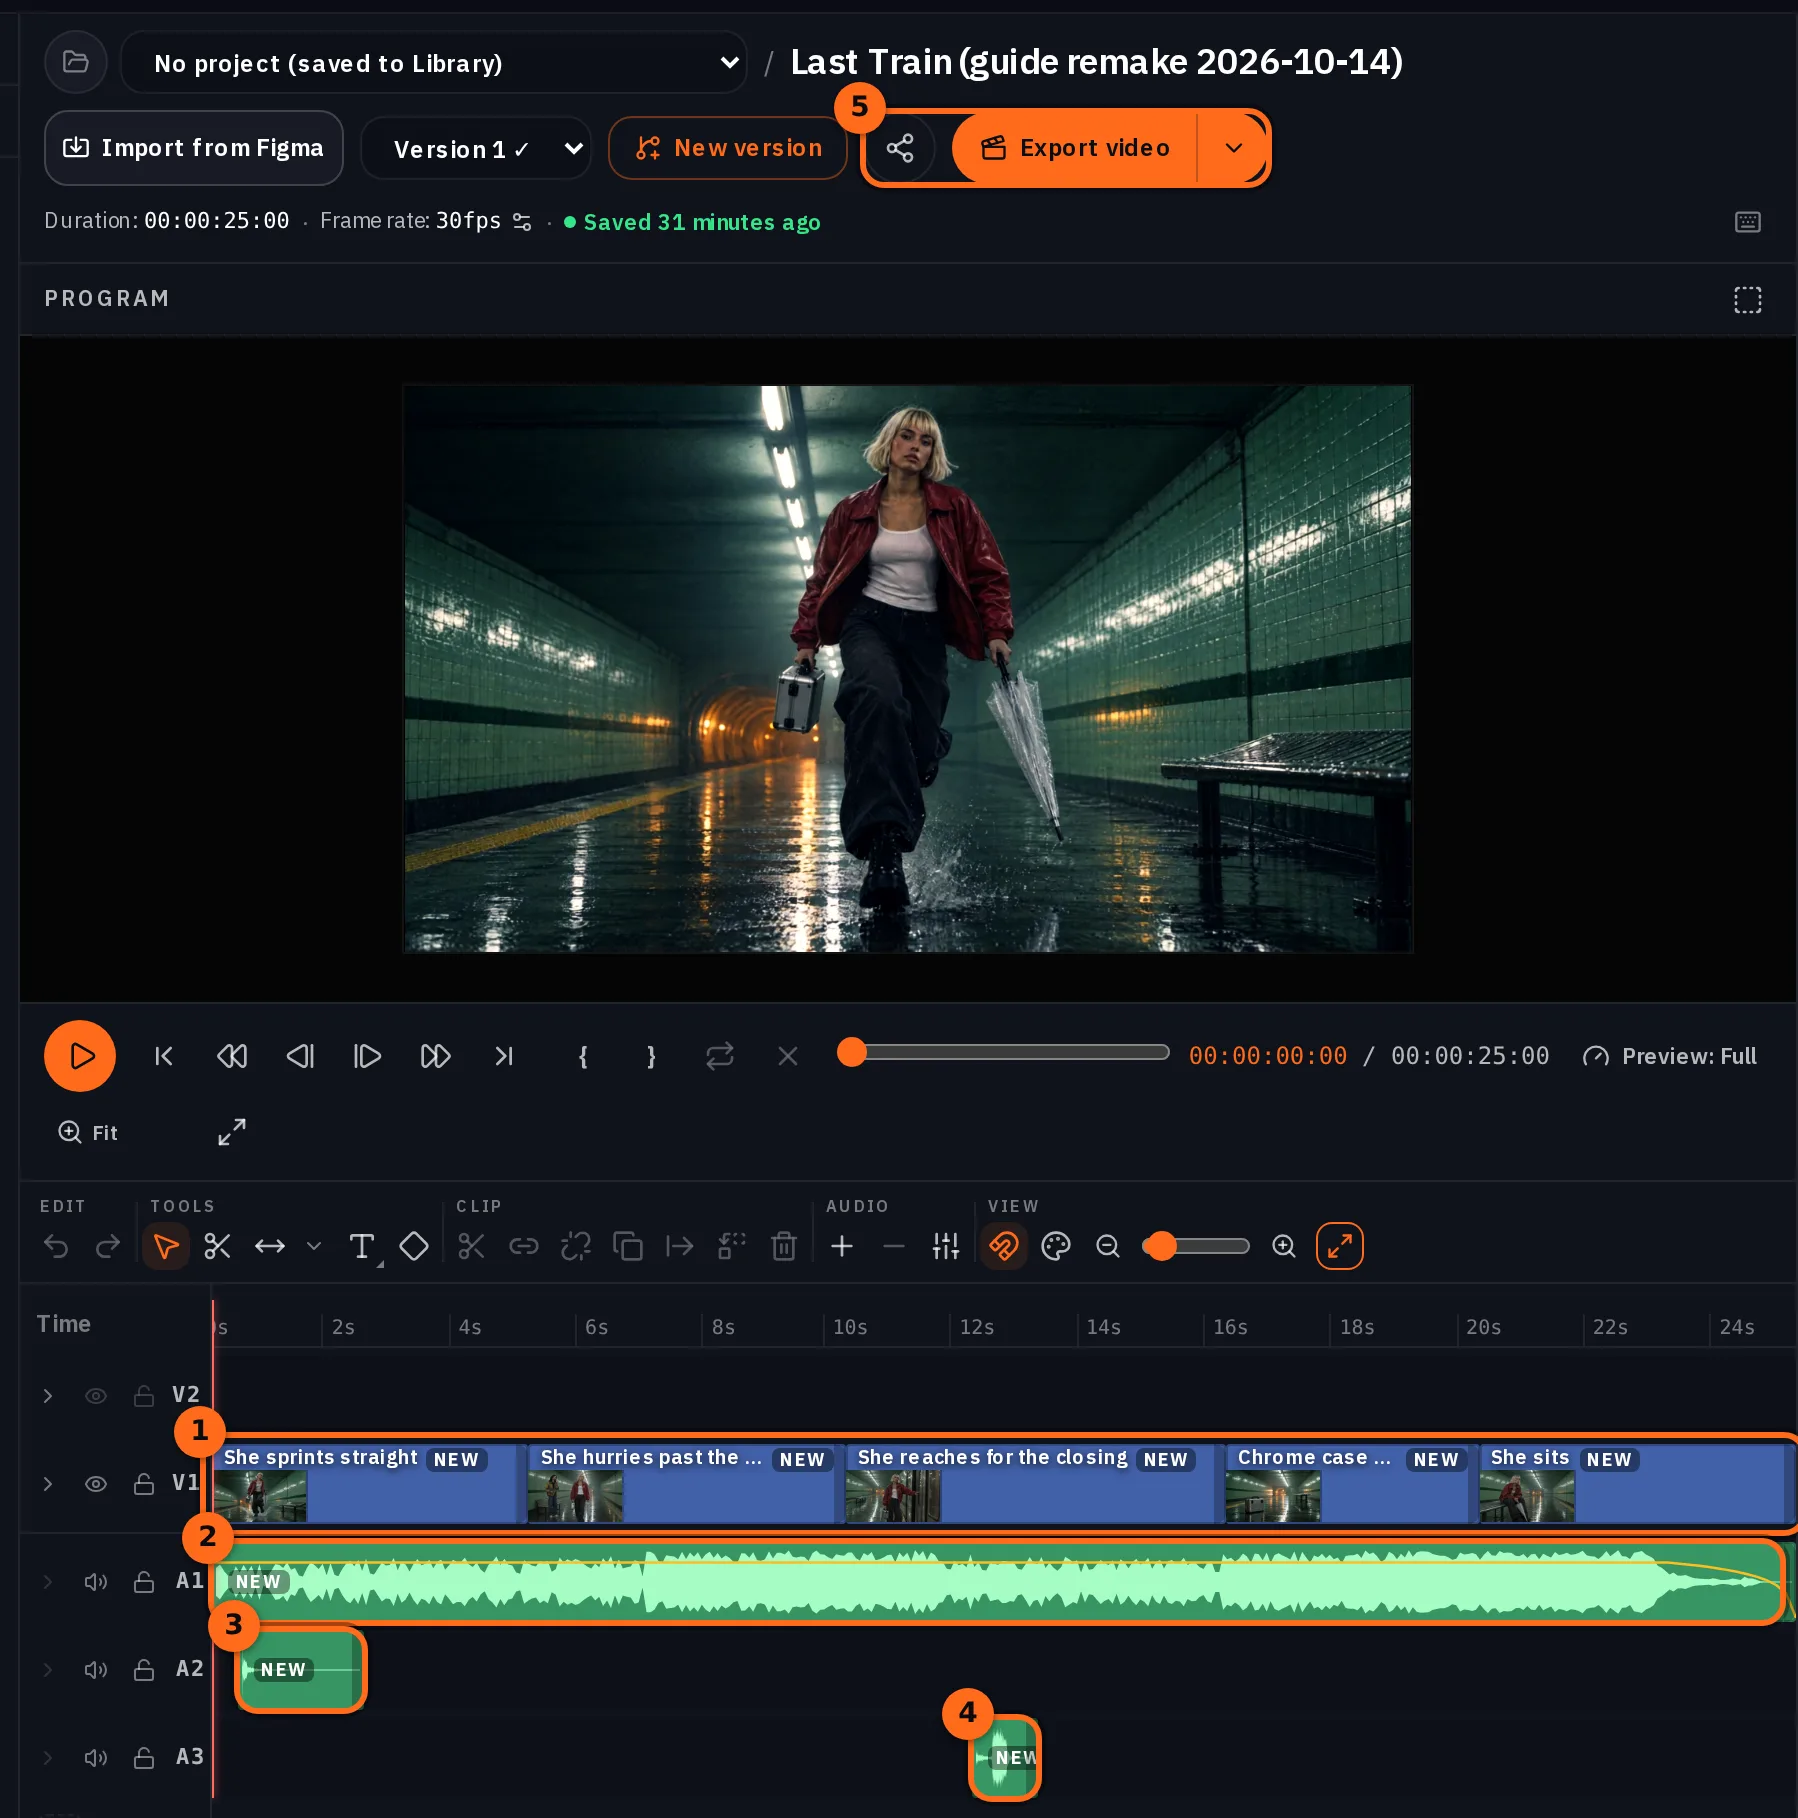
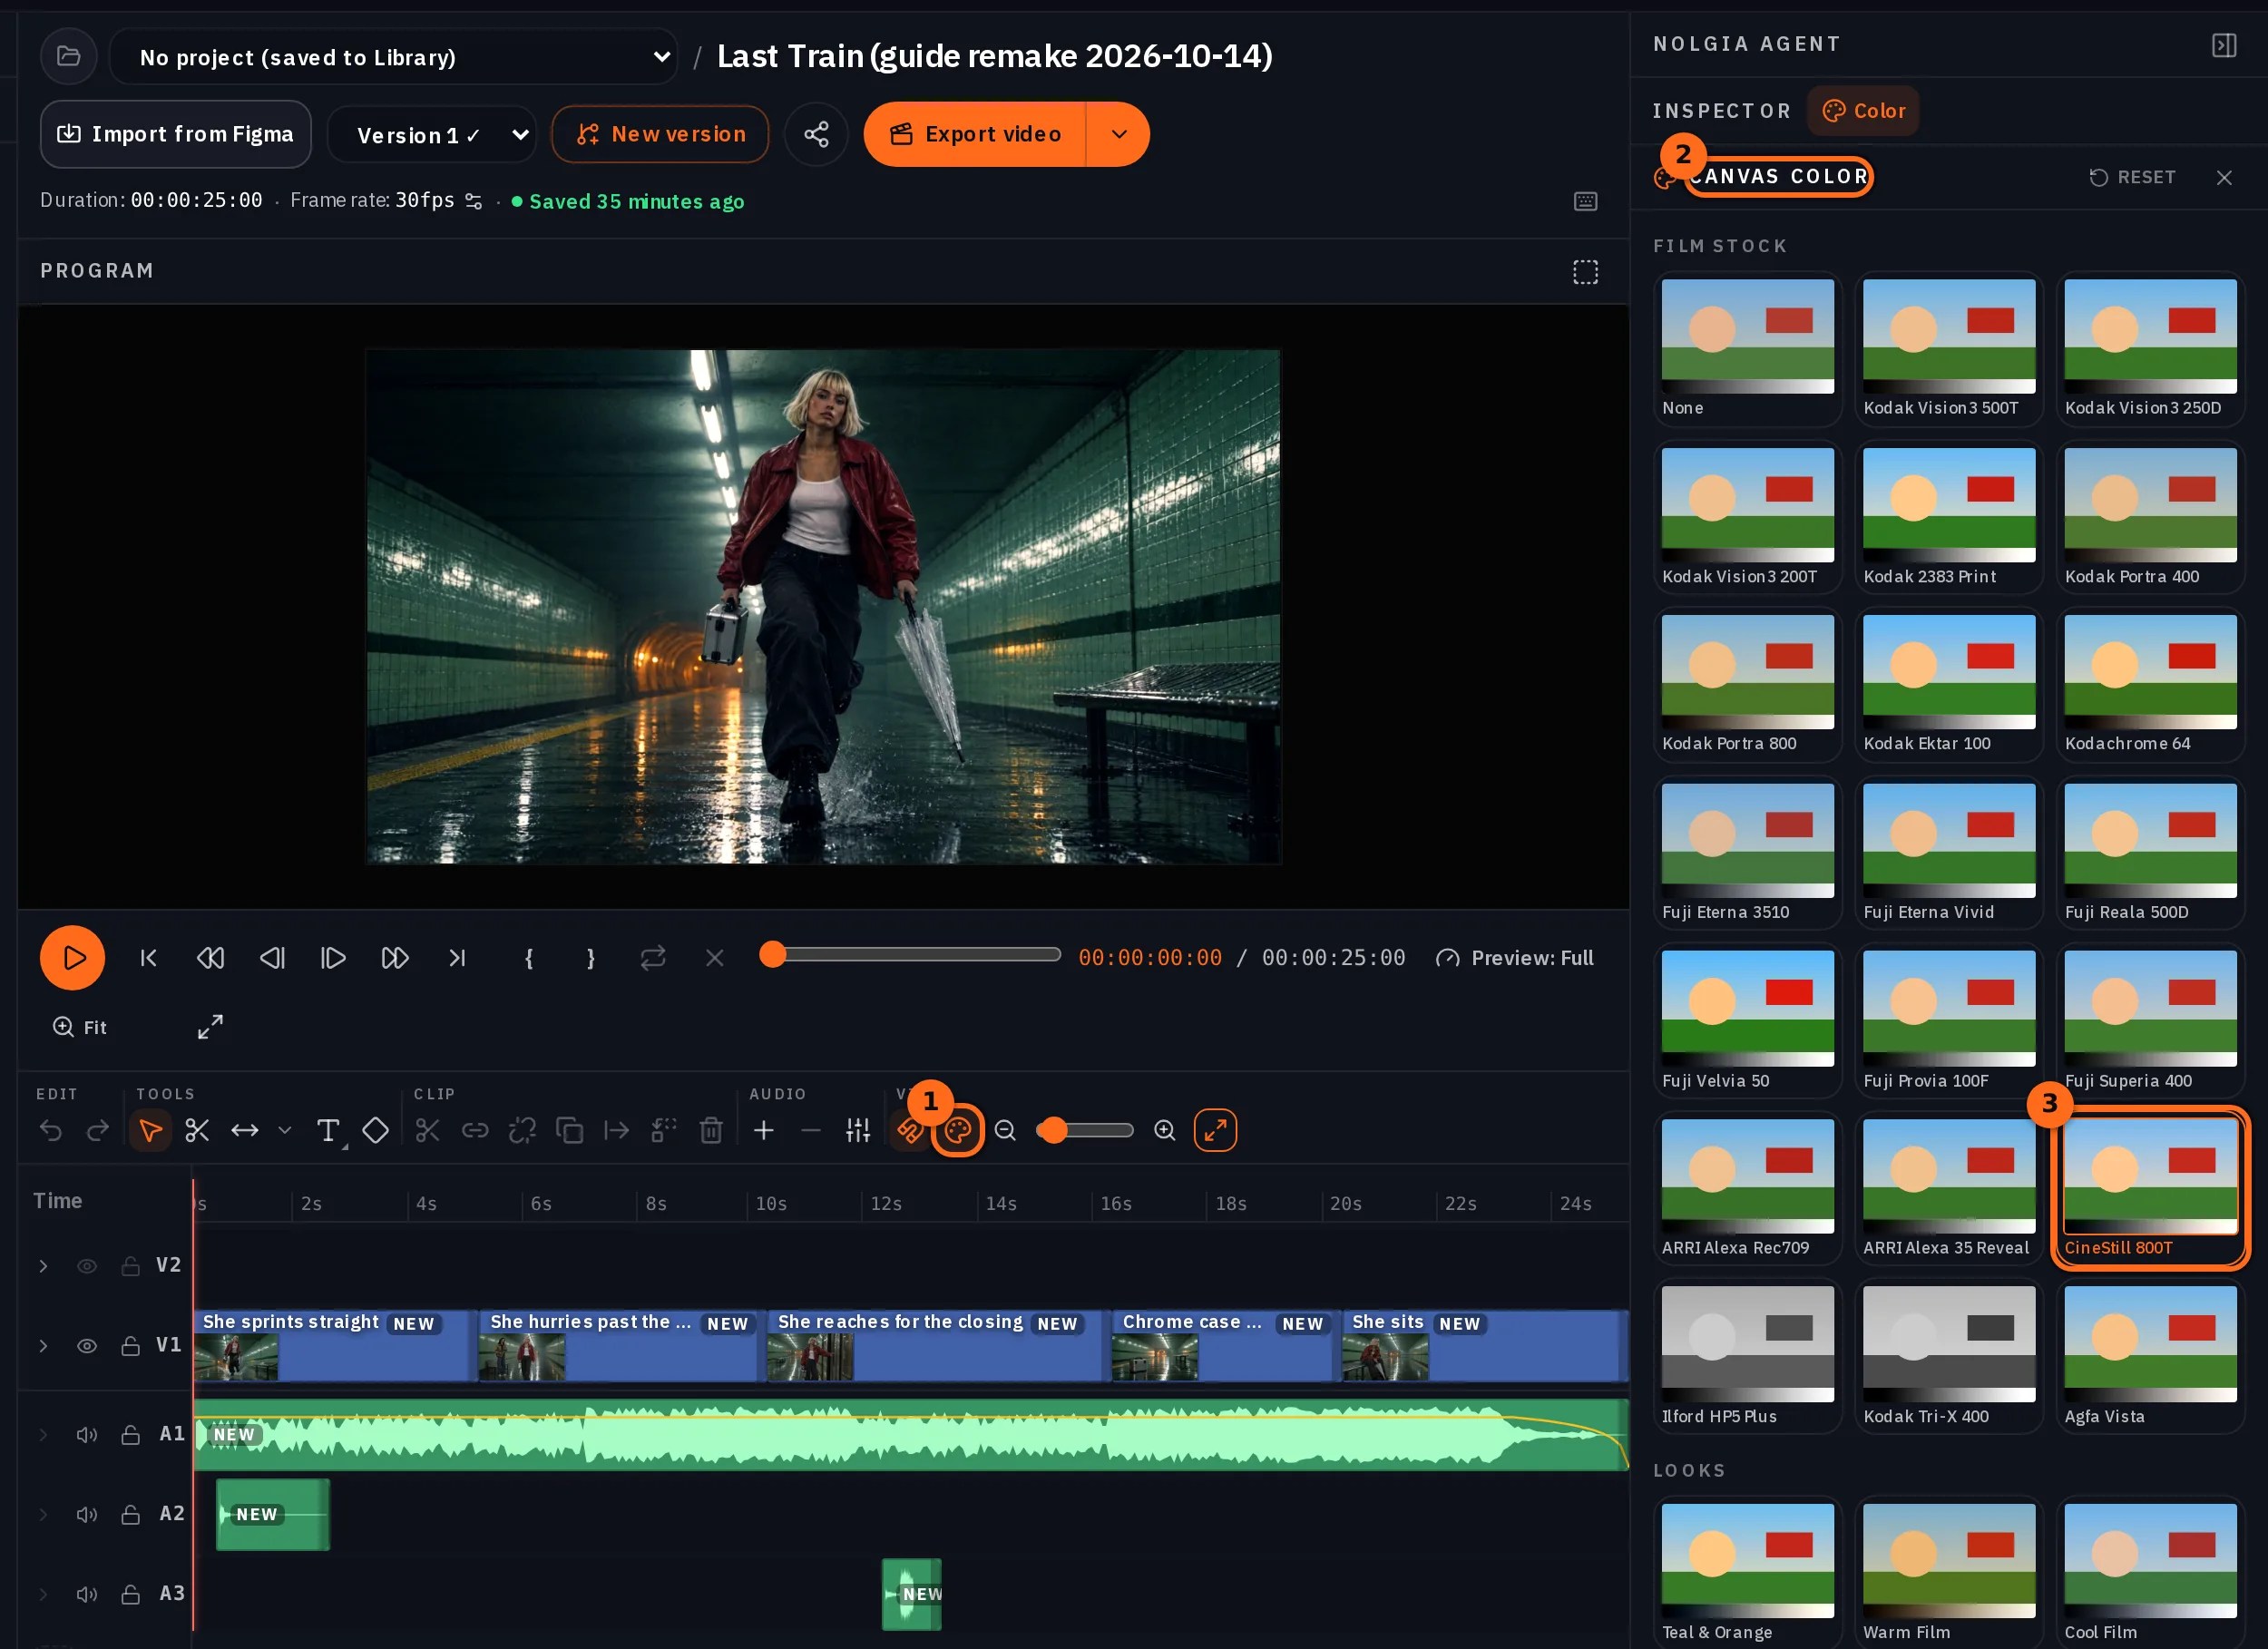
타임라인을 열고 새 타임라인을 누른 후 프로젝트와 타임라인 이름을 지정하세요. 그런 다음 미디어 열에서 라이브러리를 열고 + 버튼을 사용하여 5개의 샷을 순서대로 추가하세요. + 버튼을 누를 때마다 재생 헤드 위치에 새 트랙에 클립이 추가되며, End 키를 누르면 현재 있는 부분의 끝으로 재생 헤드가 이동합니다. 샷 2의 경우 소스 미리보기를 5초로 드래그한 후 + 버튼을 누르기 전에 끝 표시를 눌러 앞의 5초만 포함되도록 하세요. 시작 부분에 스코어를 추가하세요. 스코어 길이가 2분이므로 재생 헤드를 영상 끝으로 이동하고 아무것도 선택하지 않은 상태에서 C를 눌러 분할한 후, 꼬리 부분을 클릭하고 삭제를 누르세요. 부츠가 착지하는 부분과 문이 닫히는 부분에 두 가지 효과음을 추가하세요. 그런 다음 아무것도 선택하지 않은 상태에서 툴바에서 색상을 열고 전체 타임라인에 하나의 필름 스톡을 선택하세요. 여기서는 CineStill 800T를 사용했습니다.
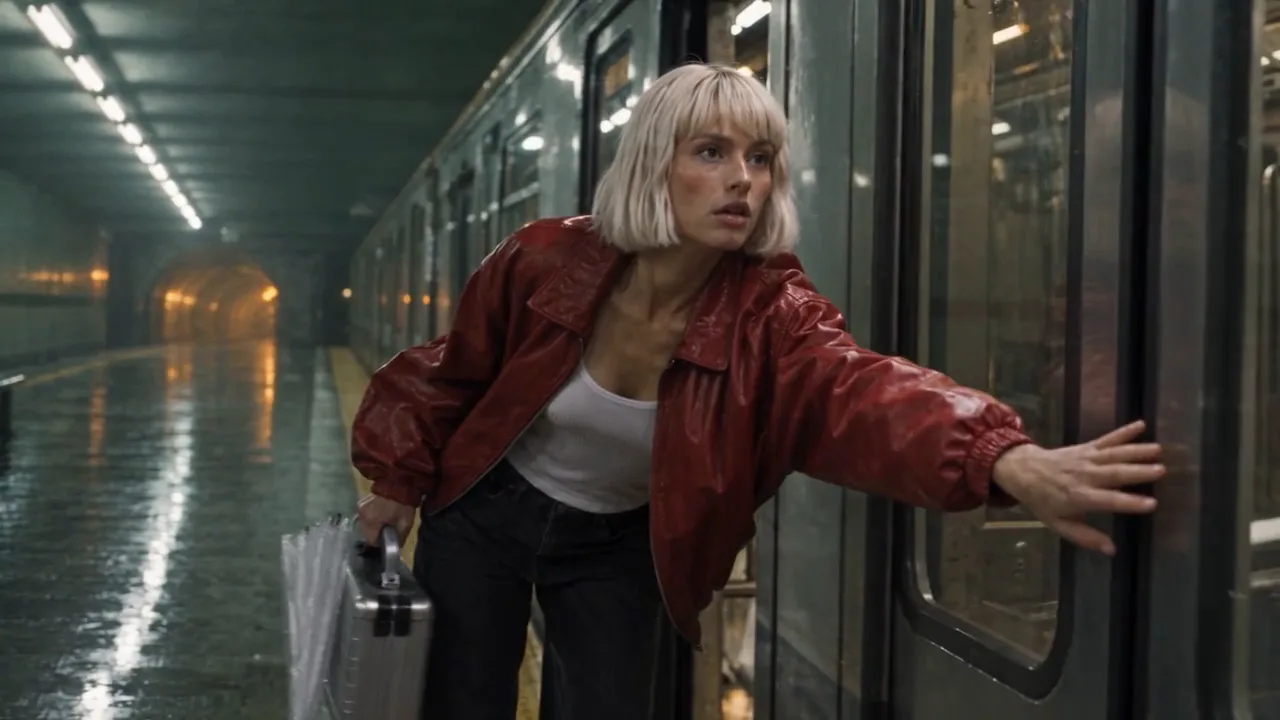
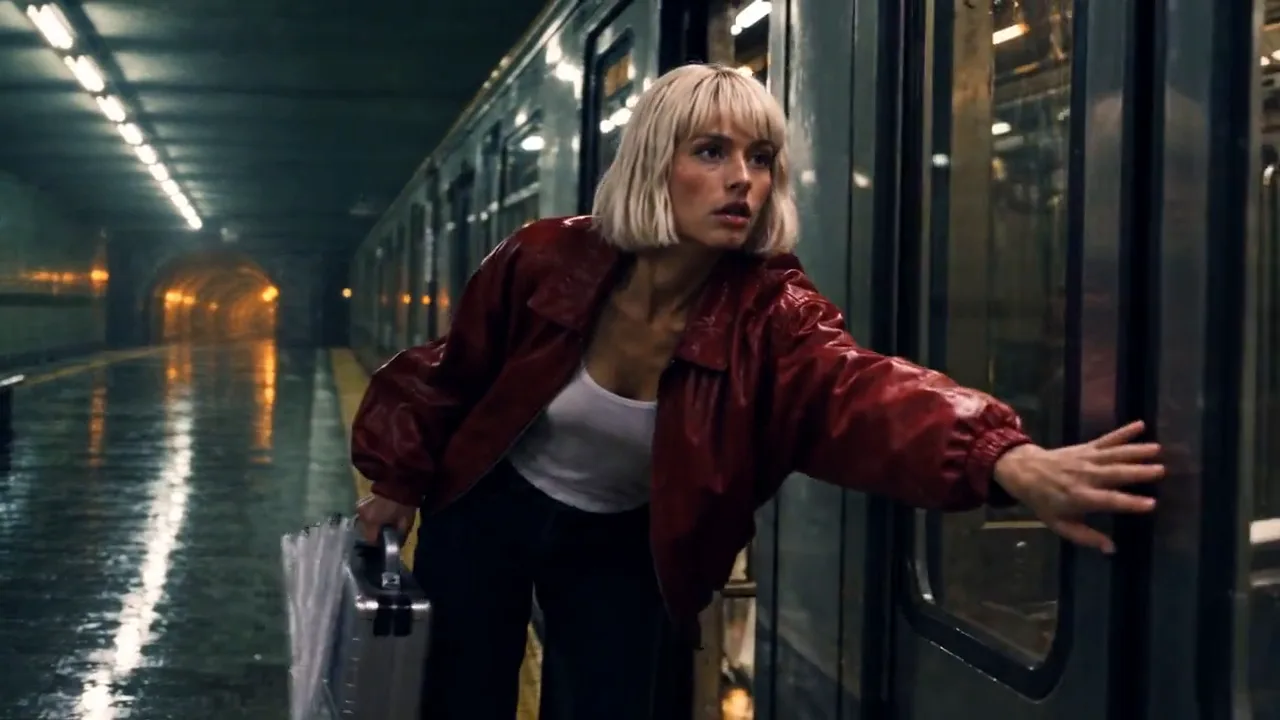 앞뒤
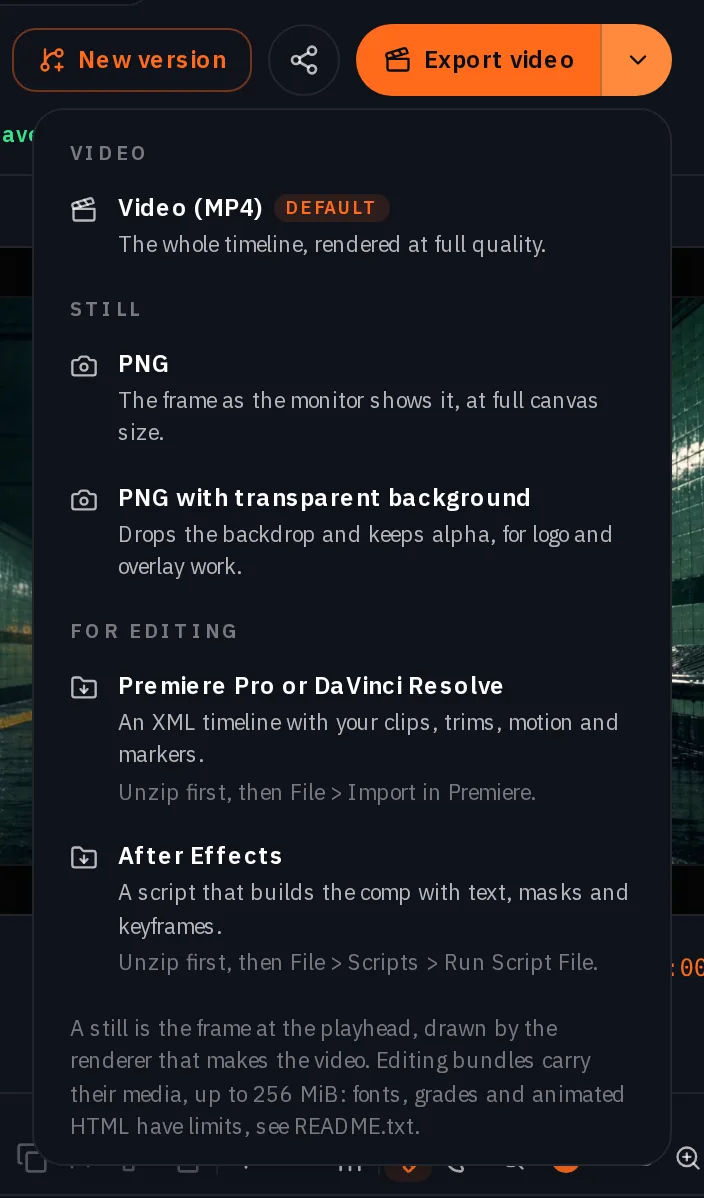
동영상 내보내기를 선택하면 MP4 파일이 렌더링되어 라이브러리에 무료로 저장됩니다. 옆의 화살표를 누르면 내보내기 메뉴가 열립니다. Premiere Pro 또는 DaVinci Resolve를 선택하면 ZIP 파일 하나를 다운로드합니다. 이 ZIP 안에는 sequence.xml, 타임라인에서 사용하는 클립이 담긴 media 폴더, luts/canvas.cube 형식의 그레이딩, 그리고 이어지지 않는 항목을 나열한 README.txt이 포함되어 있습니다. 먼저 압축을 푼 다음, Premiere에서 파일 > 가져오기를 선택하고 sequence.xml을 지정하세요. 내보내기 관련 글에서 이어지는 항목에 대한 자세한 내용을 확인할 수 있습니다.
작업별 도구 선택
| 단계 | 위치 | 사용한 모델 |
|---|---|---|
| 출연진 | 이미지 컴포저, 그 다음 출연진 | GPT Image 2.5 Flare |
| 세트 및 소품 정지 이미지 | 이미지 컴포저, 그 다음 장소 | Seedream 5.0 Pro |
| 프레임 | 캐릭터와 장소가 연결된 이미지 컴포저 | GPT Image 2.5 Flare |
| 샷 | 비디오 컴포저, 이미지 애니메이션화 | 스프린트에는 Kling v3, 나머지는 Seedance 2.5 |
| 소품을 사용하여 삽입 | 세트 위 소품의 프레임을 위한 이미지 컴포저, 그 다음 이미지 애니메이션화 | GPT Image 2.5 Flare, Seedance 2.5 |
| 음악 및 효과 | 오디오 컴포저 | Lyria 3.5, ElevenLabs Sound Effects v2 |
| 편집, 색보정, 내보내기 | Studio | 모델 없음, 비용 없음 |
다시 생성해야 하는 경우
- 모델이 출연진을 거부하는 경우. Seedance 2.0 Fast가 Vale의 참조를 거부했습니다. 프롬프트를 다시 작성하기보다 모델을 변경하세요. 거부는 검사기를 나타내는 것이지, 프롬프트의 문제가 아닙니다.
- 모델이 캐릭터를 유지할 수 없는 경우. Seedance 1.5 Pro는 비용이 청구되기 전에 캐릭터 참조를 거부하며, Seedance 2.5는 참조를 수락하지만 그녀 주위에 자체적인 세트를 만듭니다. 장소가 연결된 16:9 프레임으로 진행하세요.
- 카메라 칩이 흔들리는 경우. Shot 1은 고정(Locked off) 상태였지만, 카메라는 처음 몇 초 동안 그녀와 함께 뒤로 흔들렸습니다. 모든 테이크에서 움직임을 확인하세요.
- 요청하지 않은 소품. 3번째 프레임의 우산은 Vale의 저장된 설명에서 나온 것이지, 프롬프트에서 나온 것이 아닙니다. 장면을 작성하기 전에 캐릭터의 설명을 읽어보거나, 각 손이 무엇을 들고 있는지 명시하세요.
- 얼굴. 의상, 헤어스타일, 소품은 5개의 장면에서 일관되게 유지되지만, 얼굴이 한 사람으로 일관되는지는 여기서 측정되지 않습니다.
비용
프레임은 이미지당, 장면은 모델, 길이 및 품질에 따라 과금되며, 사운드트랙과 각 효과는 실행당 과금됩니다. Studio, 편집 및 내보내기는 무료입니다. 이 영상에 사용된 모델의 실시간 요금:
GPT Image 2.5 FlareEvery plan
Per image
Native 8 크레딧 · 2K 21 크레딧 · 4K 58 크레딧
Seedream 5.0 ProEvery plan
Per image
1K 5 크레딧 · 2K 9 크레딧
Kling v3Pro and up
Per 5s clip (audio on by default)
720p 35 크레딧 · 1080p 47 크레딧 · 4K 117 크레딧
Seedance 2.5Pro and up
Per 5s clip
480p 26 크레딧 · 720p 56 크레딧 · 1080p 137 크레딧
1080p renders at 16:9 and 9:16
Lyria 3.5Every plan
Per generation
Standard 5 크레딧
ElevenLabs SFXEvery plan
Per generation
Standard 4 크레딧
이 페이지를 열 때 카탈로그에서 실시간으로 불러옵니다. 모든 가격은 생성하기 전에 표시됩니다. 모든 요금 보기.
체크리스트
- 첫 번째 프레임을 생성하기 전에 캐릭터, 장소 및 소품을 저장하세요. 각각 한 문장으로 작성하고 그대로 재사용하세요.
- 장면당 16:9 비율의 프레임 하나를 생성하며, 출연진과 장소를 연결하세요. 의상과 소품을 전체 크기로 확인하세요.
- 각 프레임을 4~6초 길이로 애니메이션화하며, 하나의 동작과 하나의 카메라 무브만 사용하세요.
- 템포와 분위기에 따라 사운드트랙을 작성하고, 효과는 하나씩 추가하세요.
- 모델이 일관성을 잃는 부분을 잘라내고, 타임라인에서 한 번의 색보정을 적용한 후 한 번만 내보내세요.
직접 해보기
직접 캐릭터와 장소를 저장한 후, GPT Image 2.5 Flare에서 16:9 비율로 캐스트와 장소를 연결하여 프레임 1 프롬프트를 사용하고, Kling v3의 Animate an image에서 Locked off 칩을 사용하여 샷 1 프롬프트를 적용하세요. 프레임 1 레시피를 두 번째로 실행해 보았습니다. 같은 플랫폼에서 같은 재킷, 단발머리, 부츠, 우산, 케이스가 그대로 유지되었으며, 케이스는 지시대로 오른손에 들고 있었고, 걸음걸이와 벤치 위치는 반대편으로 달라졌습니다. 포즈와 세부 사항은 변할 수 있지만, 캐릭터와 장소는 참조 이미지가 유지하는 핵심입니다. 아래 이미지들은 우리의 캐스트, 세트, 소품이며, 프레임과 샷은 위에 있습니다.
재료
자주 묻는 질문
- 베일은 모든 샷에서 동일한 인물인가요?
- 재킷, 머리, 부츠, 우산, 케이스는 5개의 샷 전체에서 일관성을 유지하며, 일관성 가이드가 이를 측정합니다. 샷 간에 동일한 인물인지 여부는 우리가 측정하지 않았으므로 단정할 수 없습니다.
- 왜 모든 샷 전에 프레임을 만들어야 하나요?
- 한 프레임은 영상 촬영보다 훨씬 적은 비용이 들며, 의상, 소품, 구도를 확정하는 단계입니다. 또한 두 가지 문제를 피할 수 있습니다. 하나는 영상 모델이 캐릭터 참조를 거부하거나 누락하는 경우이고, 다른 하나는 모델을 사용하더라도 모델이 자체적으로 배경을 생성해 버리는 경우입니다.
- 어떤 영상 모델을 사용해야 하나요?
- 달리는 장면에는 Kling v3를 사용하세요. 달리기 동작과 손에 든 소품이 자연스럽게 유지됩니다. Seedance 2.0 Fast는 캐릭터 참조를 거부했고, Seedance 1.5 Pro는 이를 지원하지 않으므로, 조용한 장면들은 프레임 기반의 Seedance 2.5를 사용했습니다. 무게감이 필요한 모든 작업에는 Kling v3 또는 Seedance 2.5를 사용하세요.
- 영화는 얼마나 길게 만들 수 있나요?
- 샷 리스트에 따라 결정됩니다. 25초 분량은 4~6초 길이의 5개 샷으로 구성되었습니다. 샷은 짧게 유지하세요. 모델은 약 5초를 넘기면 품질이 떨어지거나 반복적인 동작을 생성합니다.
- 캐릭터가 말을 할 수 있나요?
- 이 영화에는 대사가 없습니다. 대사가 필요한 경우 오디오 컴포저에서 녹음한 후 편집본에 깔아 넣거나, 단일 샷에 한해 네이티브 음성 생성 기능을 지원하는 모델을 사용하세요.
- Premiere나 Resolve에서 마무리할 수 있나요?
- 네, 가능합니다. Studio의 내보내기 메뉴에서 시퀀스, 미디어, 그리고 LUT 형식의 색보정 데이터를 포함한 ZIP 파일을 다운로드할 수 있습니다. 먼저 압축을 푼 다음 시퀀스를 가져오세요.
출연진부터 시작하세요
캐릭터 열기관련 가이드
영상 제작
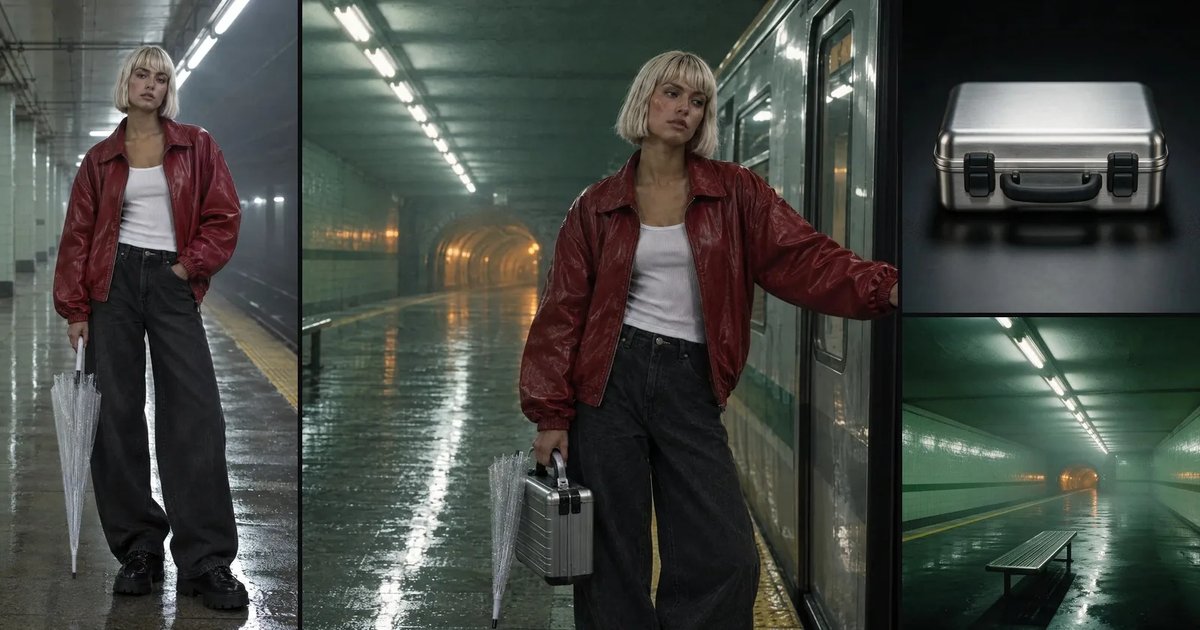
장면 간 캐릭터와 장소의 일관성 유지하기
저장된 캐릭터, 저장된 장소, 그리고 소품마다 반복되는 한 문장: 한 편의 영화 5개 장면에서 실제로 유지된 요소들을 객체별 및 색상별로 측정하고, 유지되지 않은 두 가지 공백을 살펴봅니다.
· 11분 분량
영상 제작
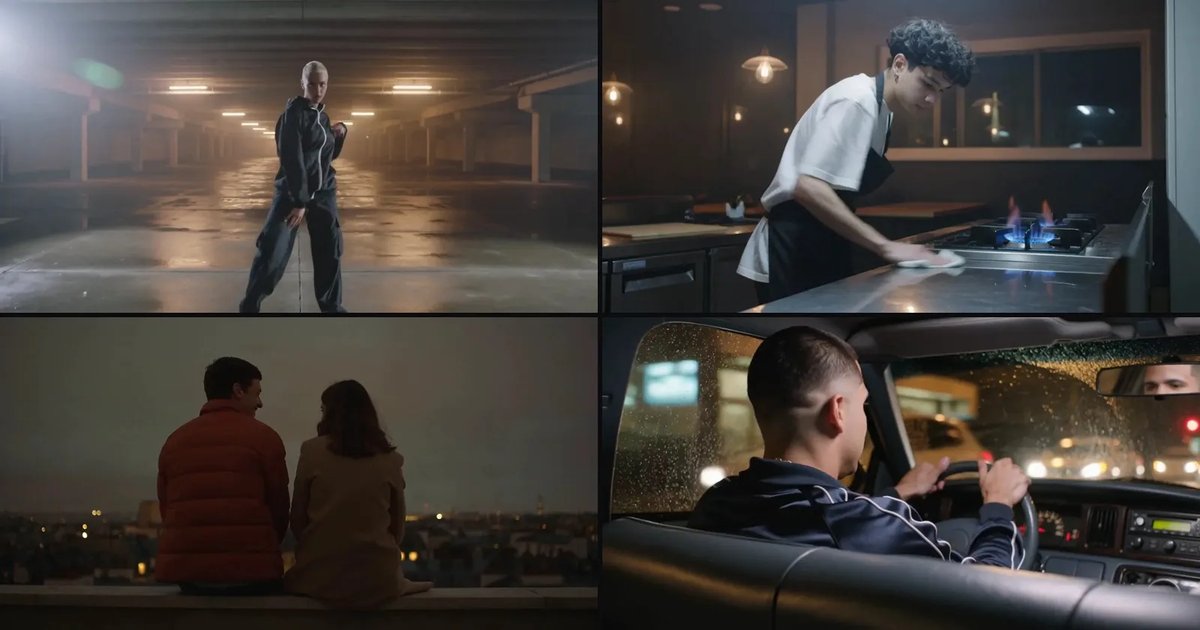
대본으로 영상 만들기, 단계별 가이드
60~90 단어의 대본을 컷으로 나누고, 비디오 컴포저에서 카메라 무브를 적용해 각 컷을 생성하고, 내레이션을 녹음한 뒤, Studio에서 편집하고 내보냅니다. 모든 단계를 실제로 수행합니다.
· 13분 분량
영상 제작
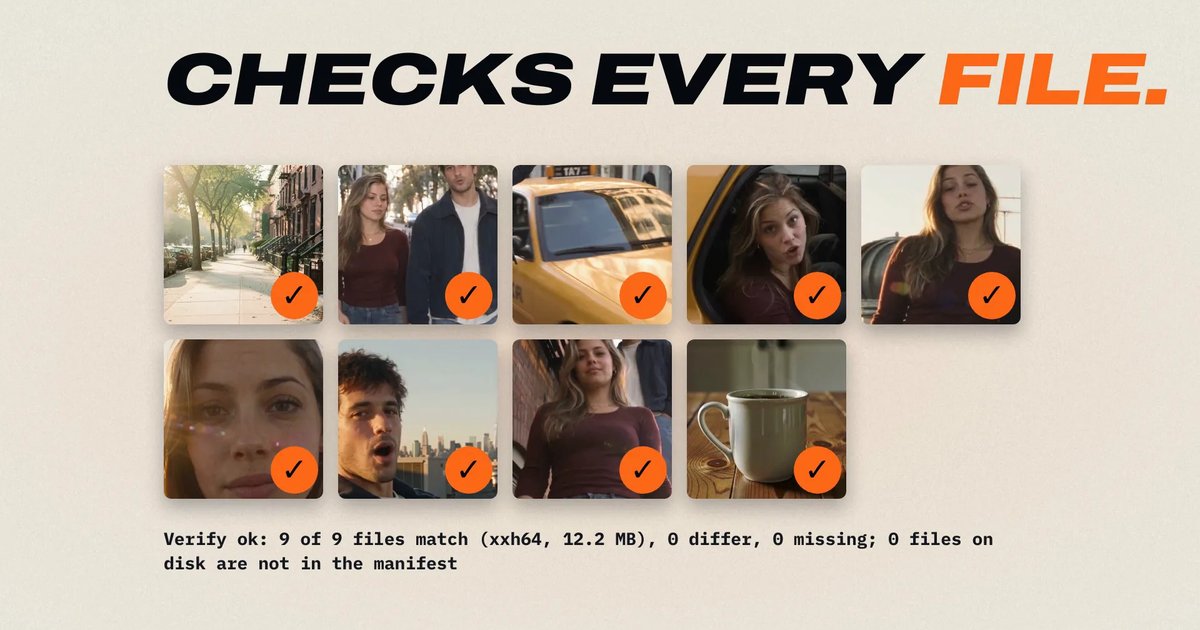
NOLGIA가 DIT 역할을 대신합니다: 카메라 카드 복사, 검증 및 파일 이름 지정
카메라 카드를 두 개의 드라이브에 복사하고, 모든 복사본을 원본 카드와 대조하여 검증하며, ASC MHL 매니페스트, DIT 보고서 및 이름이 지정된 파일을 생성합니다. 무료이며, 사용자의 컴퓨터에서 실행됩니다.
· 8분 분량