

Mantieni personaggi e location coerenti tra le inquadrature
La coerenza su NOLGIA si basa su due elementi: immagini di riferimento e le stesse parole ogni volta. Questa guida analizza le cinque inquadrature di Last Train e verifica cosa è rimasto stabile: il guardaroba, gli oggetti di scena, il set e la palette. Lo conta. Non afferma che il volto appartenga a una sola persona, perché non lo abbiamo misurato.
- 11 min di lettura
Tradotto automaticamente dall'inglese. Leggi l'originale
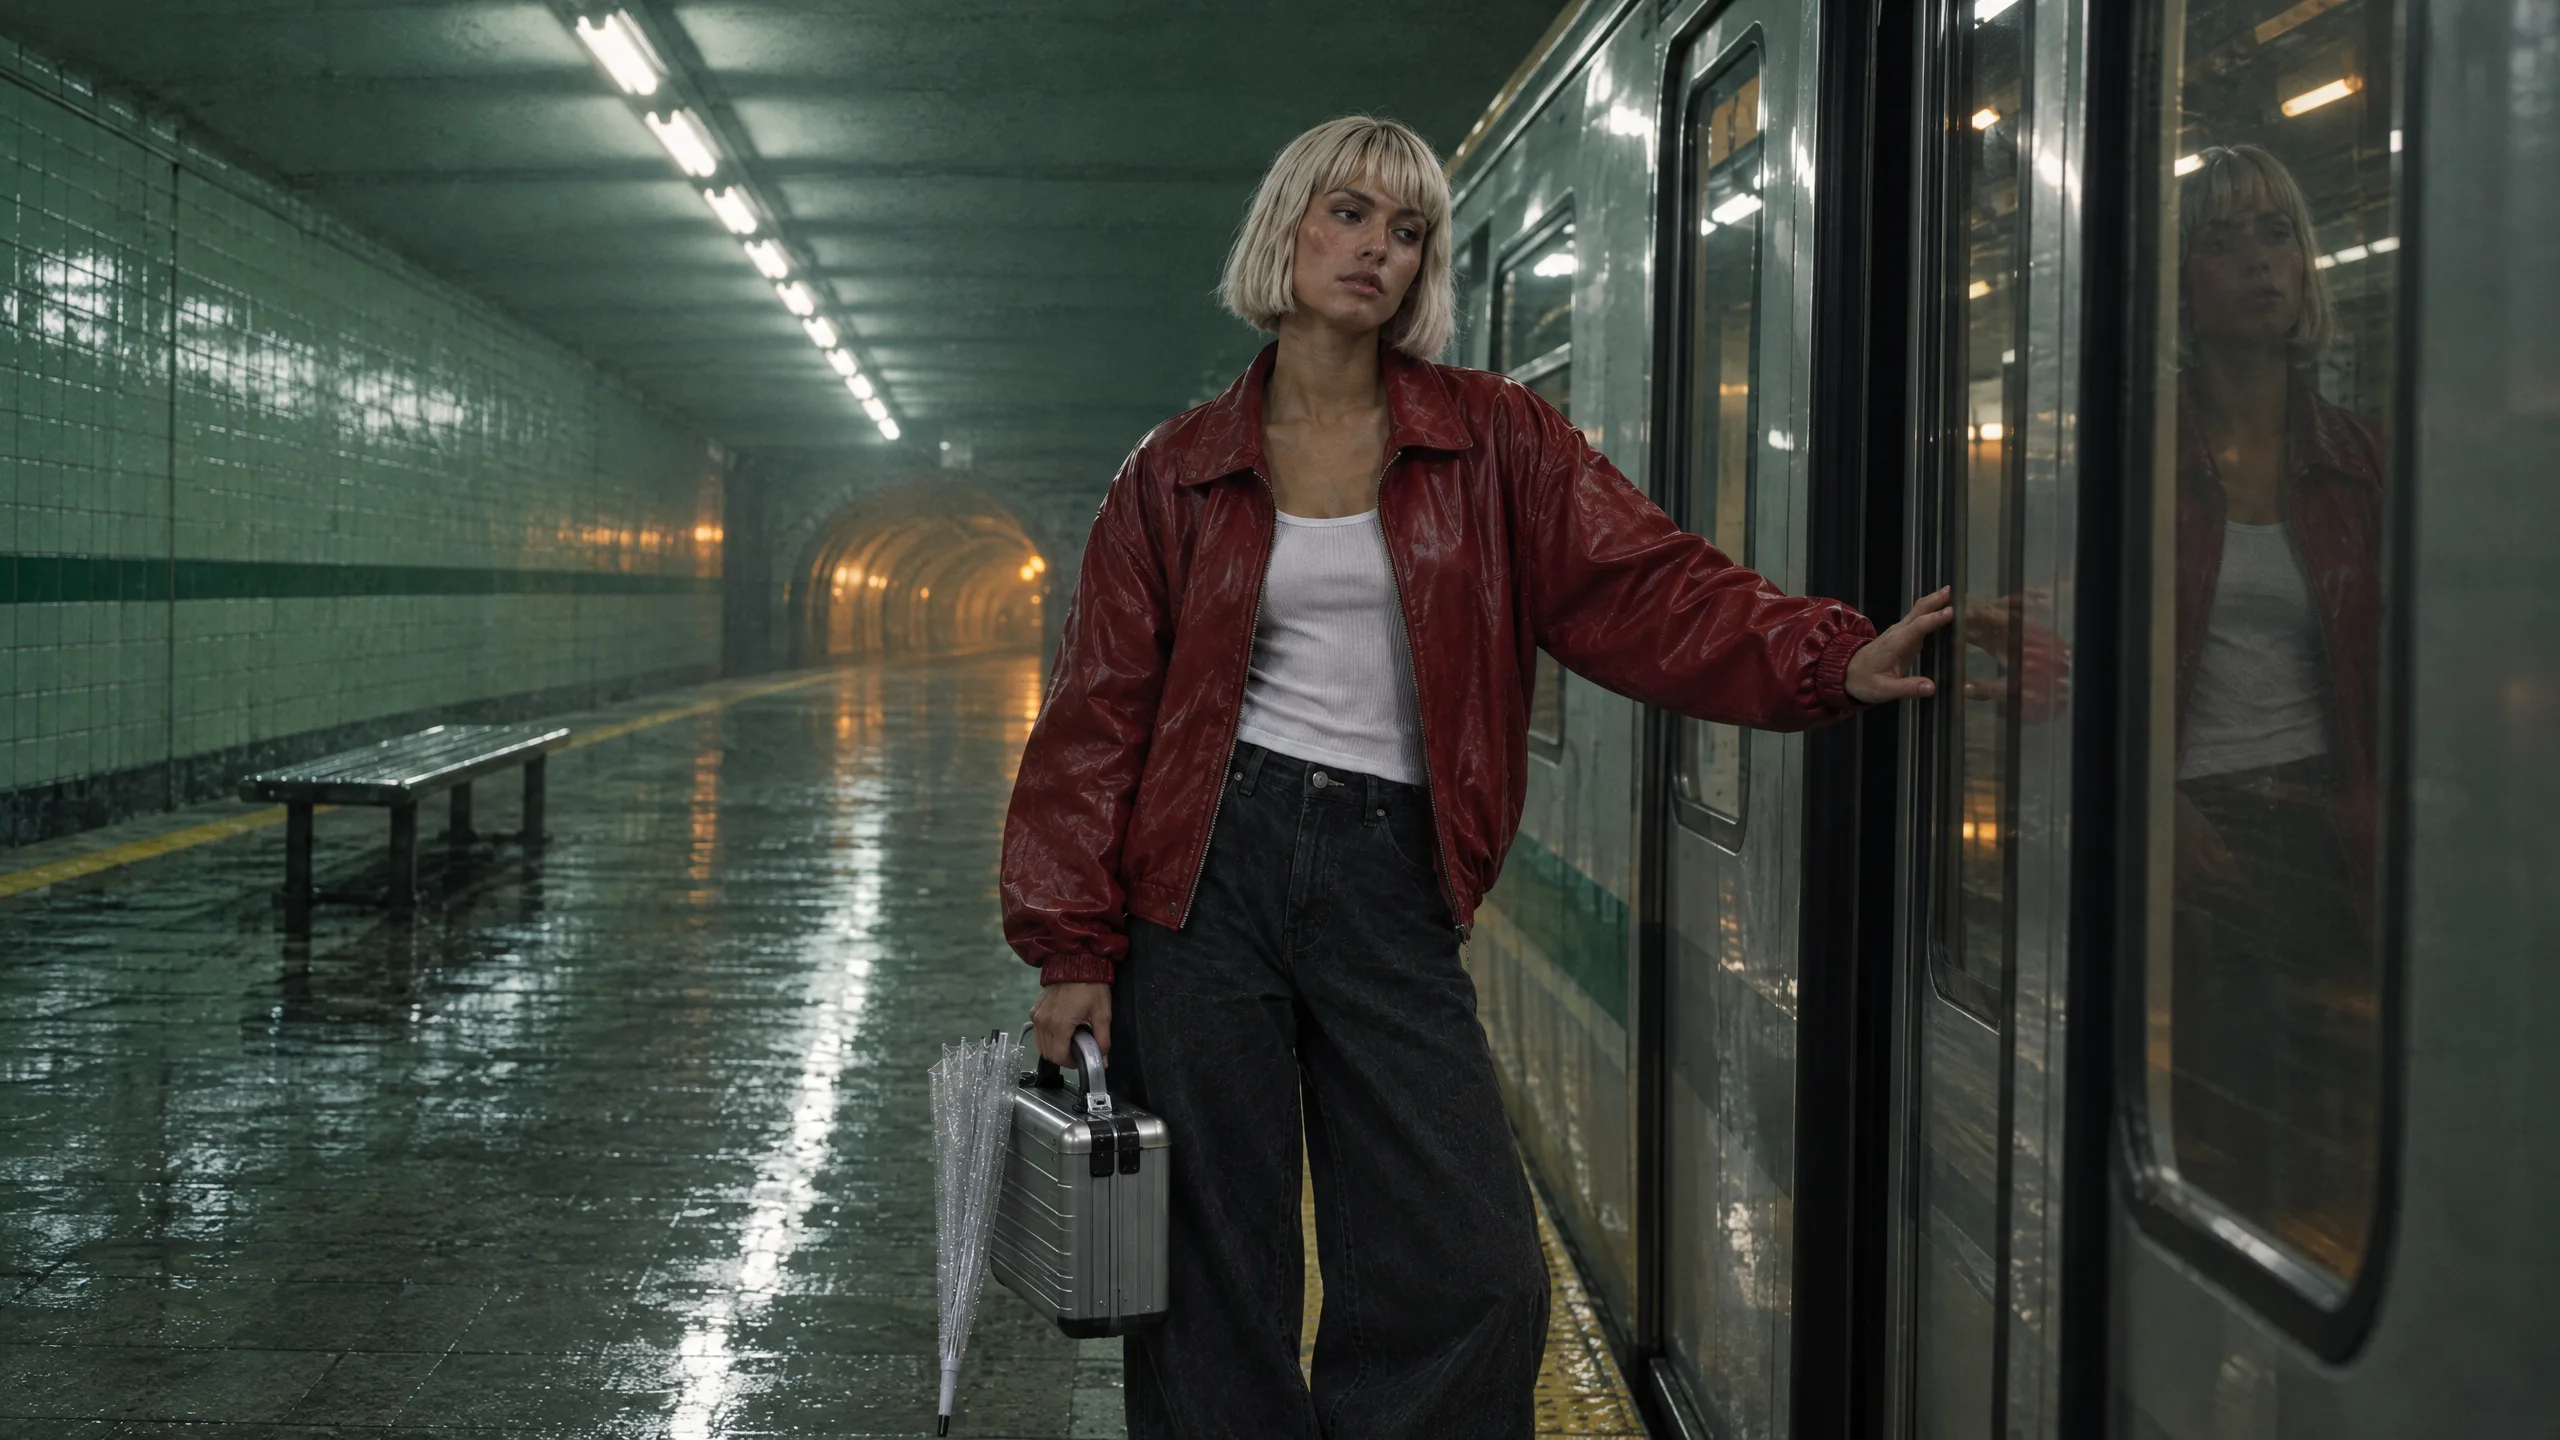
Le inquadrature di questa guida sono le cinque inquadrature di Last Train, un film di 25 secondi realizzato per queste guide sull'account aziendale. Vale è un personaggio salvato, la stazione di Halcyon Street è una location salvata, la valigetta cromata è un'immagine statica e una frase. Ogni inquadratura è stata creata come frame 16:9 nel compositore di immagini con il personaggio e la location allegati, poi animata nel compositore video. Ogni persona presente è fittizia.
Abbiamo poi analizzato le inquadrature con una lista e un metro a nastro: quali capi, quali oggetti di scena e quali parti del set appaiono in ciascuna, e quanto spazio occupano il verde del set, l'ambra del tunnel e il rosso della giacca in ogni fotogramma. Ecco il risultato di quella verifica, inclusi i due punti in cui fallisce.
Cosa va storto
| Errore | Perché fallisce | Correggi |
|---|---|---|
| Descrivere il personaggio da zero in ogni prompt | Ogni prompt è una richiesta a sé stante; un cappotto diventa una giacca, un caschetto diventa una coda di cavallo | Salva un personaggio con un'immagine di riferimento e una descrizione, allegalo e scrivi @Name |
| Descrivere il luogo in una sola inquadratura e dare per scontato che resti | Il modello inventa una nuova piattaforma ogni volta | Salva una location con un fermo immagine e una frase; allegala a ogni inquadratura |
| Omettere un oggetto di scena da un prompt | L'oggetto scompare da quell'inquadratura, indipendentemente da quanto mostrato nella precedente | Una frase per ogni oggetto di scena, incollata in ogni prompt in cui deve apparire |
| Inviare il personaggio direttamente a un modello video | Un modello rifiuta un riferimento fotorealistico, un altro non può gestirlo, e quello che accetta la sua immagine inventa un proprio set | Crea prima un fotogramma 16:9 con il Cast allegato, poi animarlo |
| Fidarsi del buon primo secondo | I set si ripetono e gli oggetti migrano mentre la clip prosegue | Mantieni le inquadrature tra 4 e 6 secondi e taglia dove c'è deriva |
Cosa è un anchor qui
Non esiste un'identità addestrata su NOLGIA. Ci sono tre tipi di anchor e questa guida li usa tutti:
- Un personaggio, dalla pagina Personaggi: fino a otto foto di riferimento con una principale e una descrizione che viene inserita in ogni prompt a cui è collegato. Selezionalo sotto Personaggi in entrambi i composer e scrivi @Vale nel prompt. Il composer mette la foto principale in uno slot di riferimento e riscrive @Vale con quello slot.
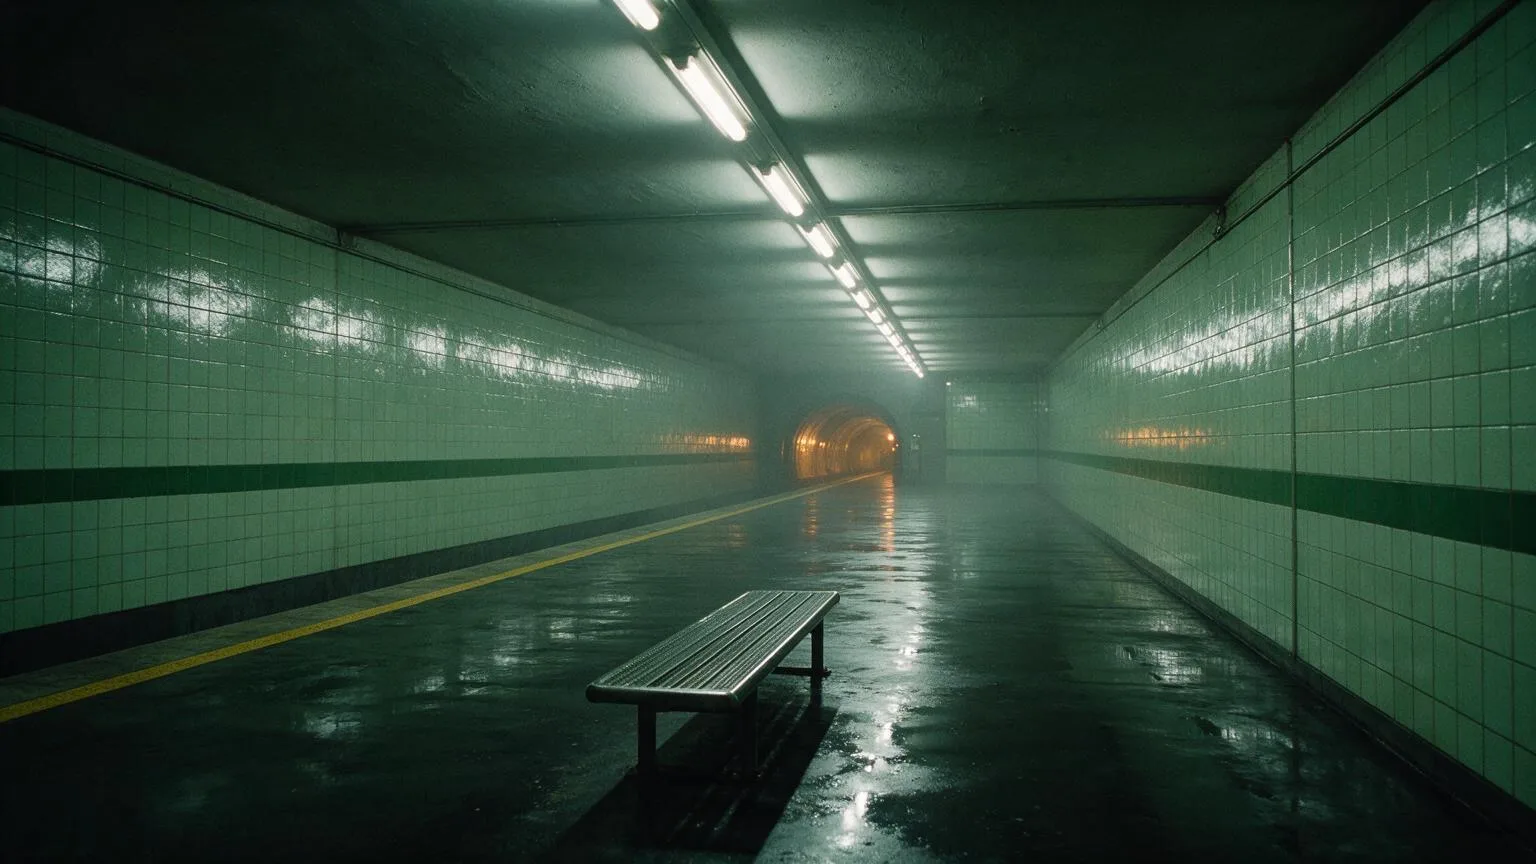
- Una location, dalla pagina Location: un'immagine fissa e una descrizione canonica. Selezionala sotto Location e l'immagine viene inserita come riferimento con la frase.
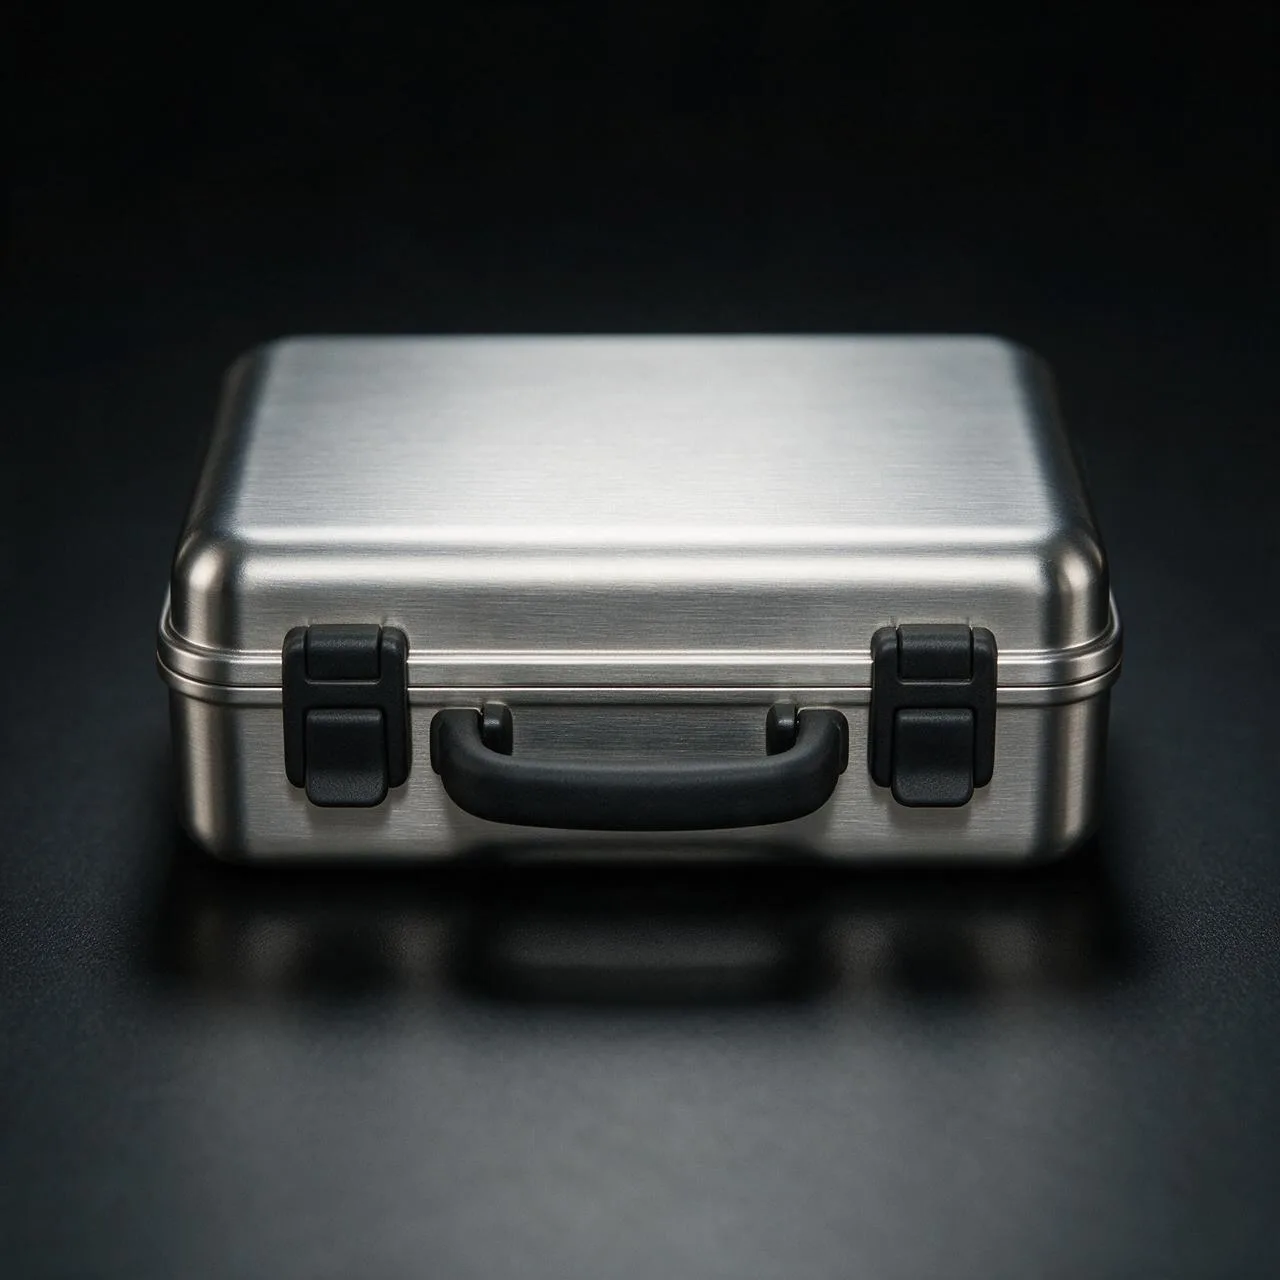
- Una frase, per tutto il resto. Il caso della custodia cromata è una frase, incollata invariata in ogni prompt a cui appartiene, più la sua immagine fissa come riferimento per l'inserimento.
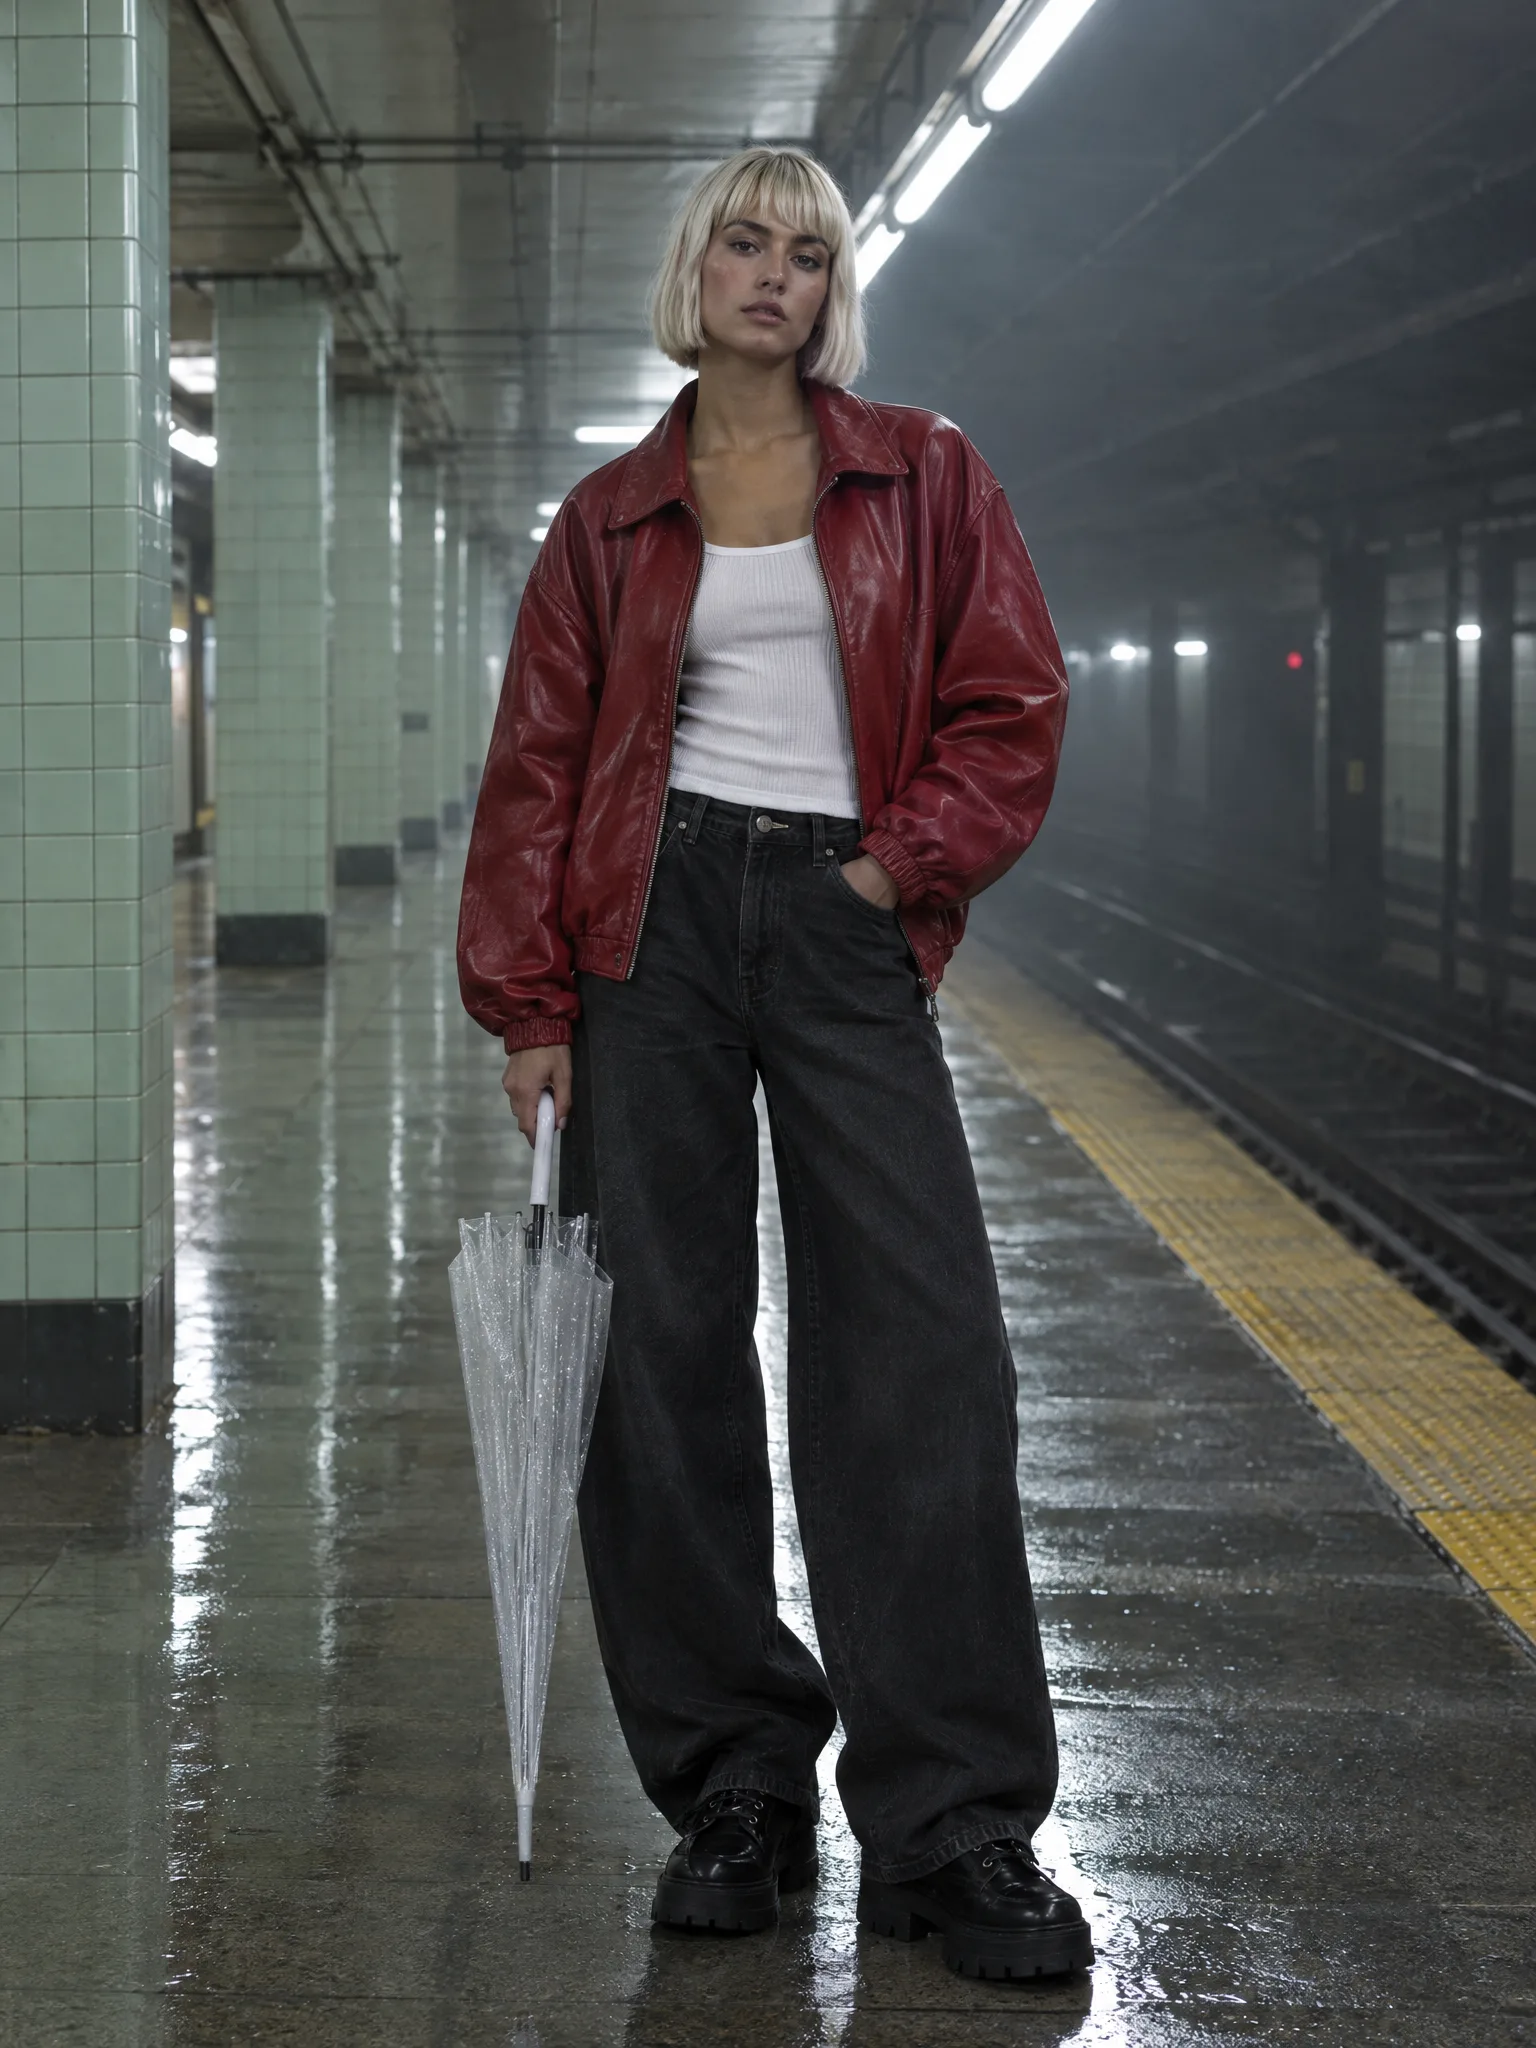
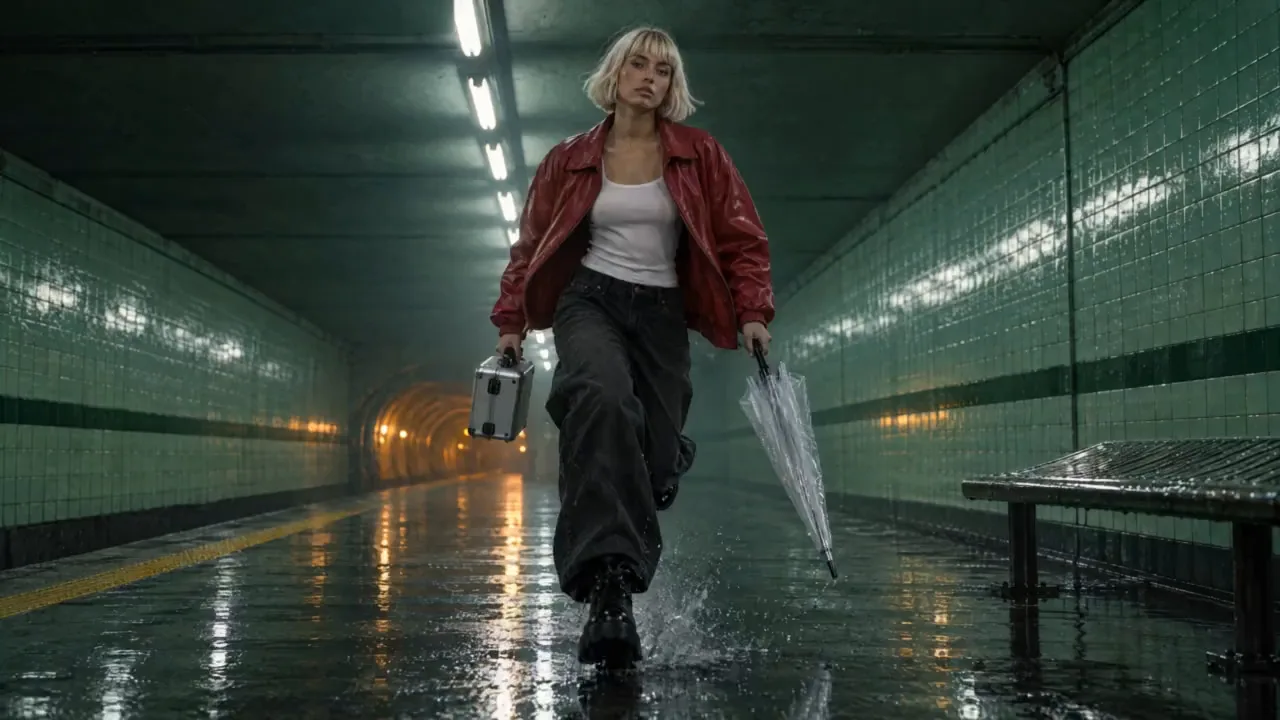
The lead of Last Train: a woman in her early twenties with a platinum blonde sleek chin-length bob and a straight fringe, an oversized cherry-red leather bomber jacket over a white ribbed tank, wide black jeans, chunky black platform lace-up boots, a folded transparent bubble umbrella in one hand.Le cinque inquadrature
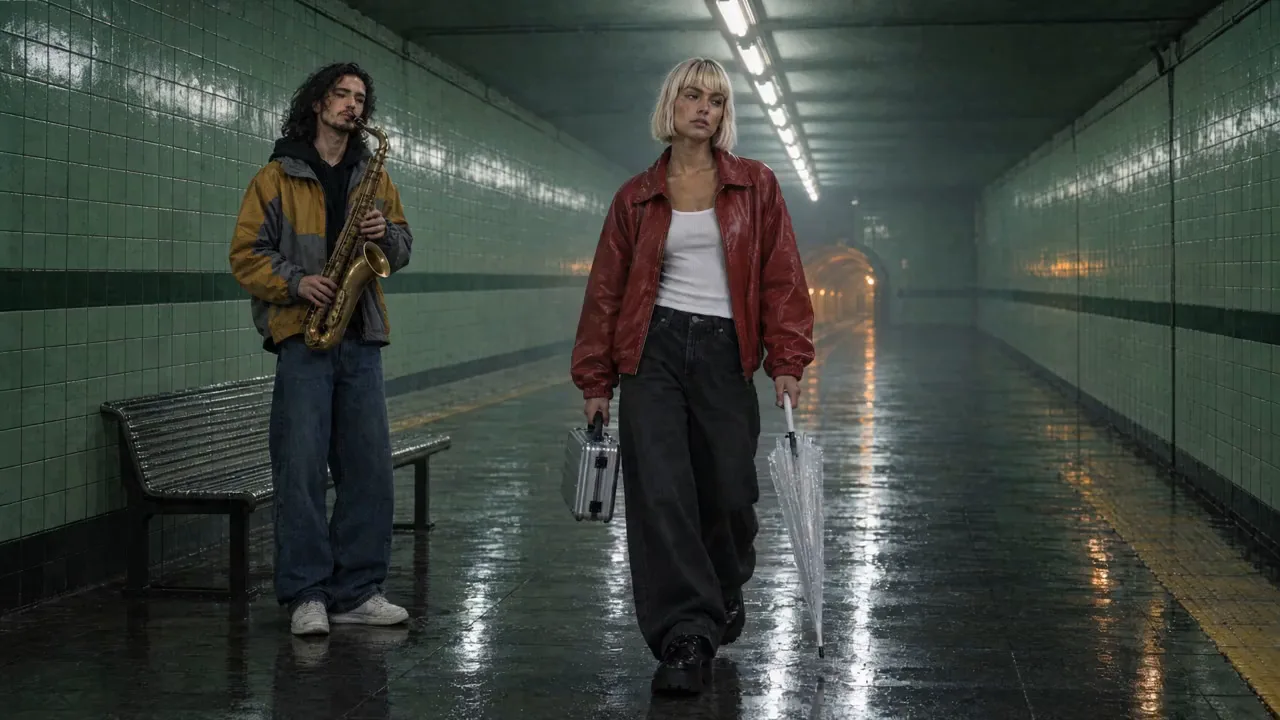
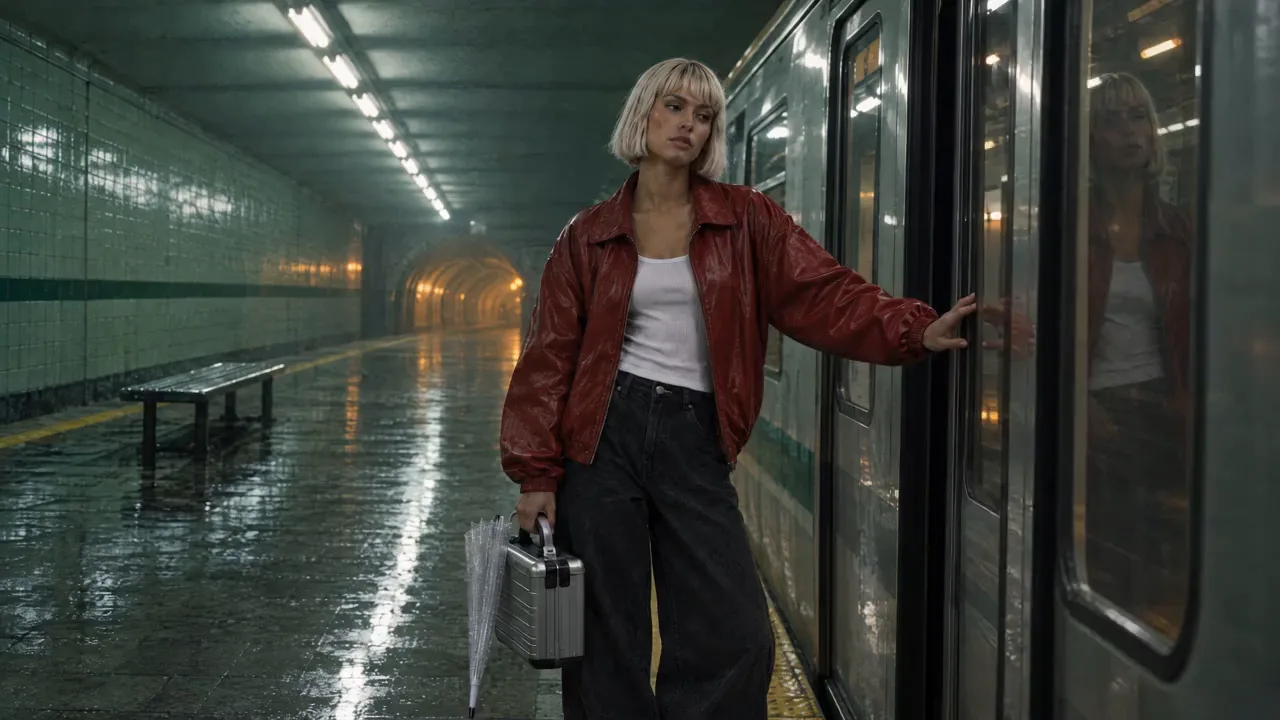
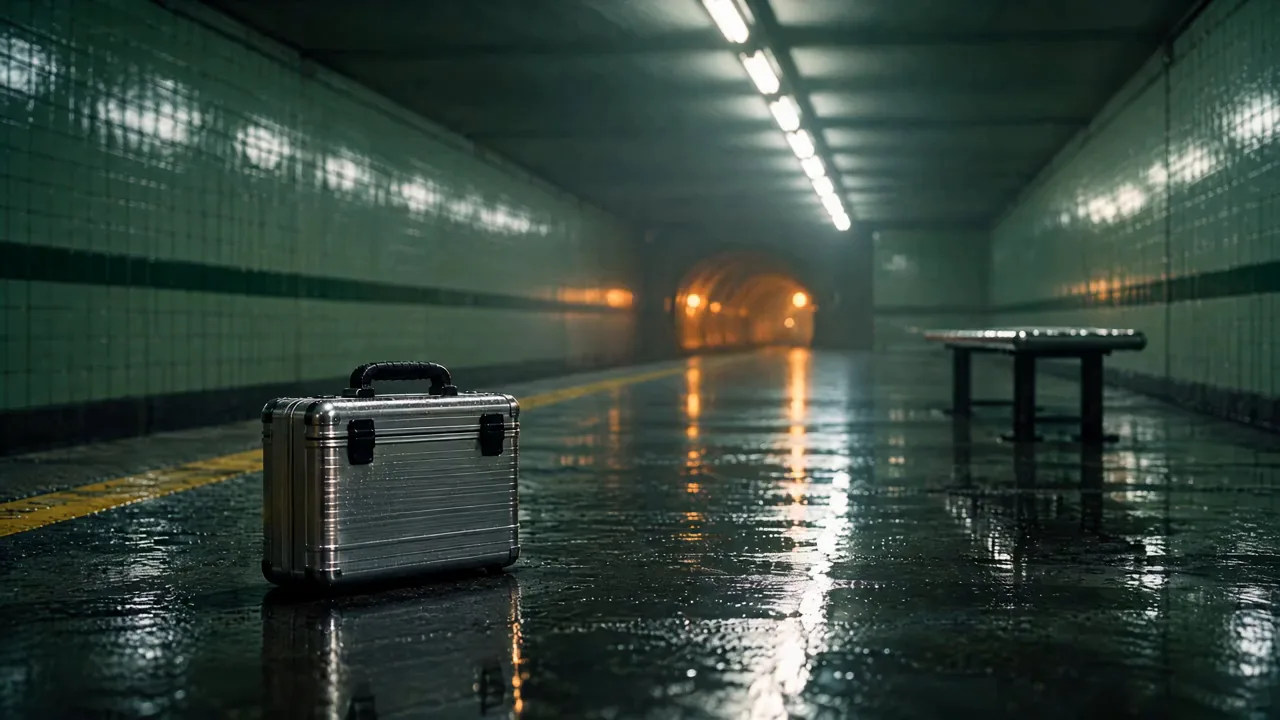
Ogni inquadratura qui sotto era prima un frame, creato nel compositore di immagini su GPT Image 2.5 Flare con Vale e la stazione allegati, poi animato da quel frame: la corsa su Kling v3, le altre quattro nel compositore video su Seedance 2.5. Il frame dell'inserimento non aveva personaggi: la stazione allegata e il prop dalla sua descrizione.
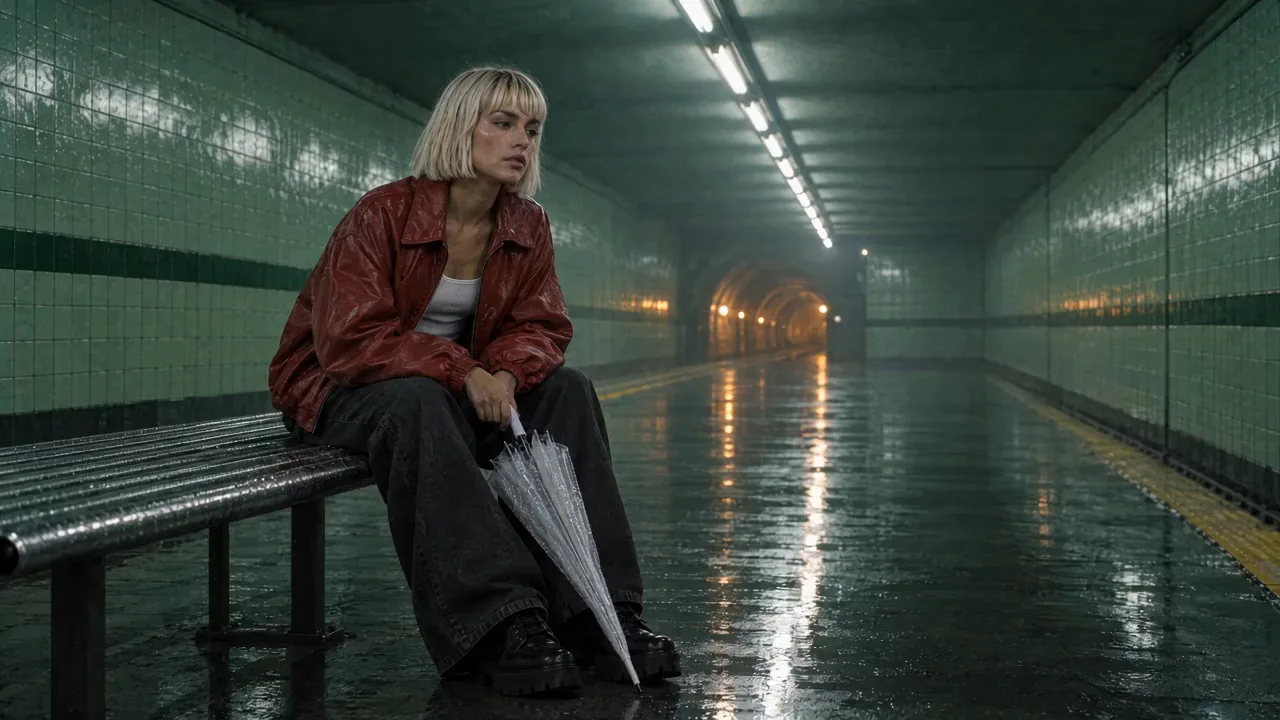
Cosa è rimasto coerente: guardaroba, oggetti di scena e set, inquadratura per inquadratura
Abbiamo esaminato ogni inquadratura a due fotogrammi al secondo e spuntato una lista: cinque capi di guardaroba (il bomber in pelle rosso ciliegia, la canotta bianca a coste, i jeans neri larghi, gli stivali neri con plateau, il caschetto platino), due oggetti di scena (l'ombrello trasparente, la valigetta cromata) e sei elementi del set (piastrelle verde pallido, la striscia verde scuro, i tubi fluorescenti, la panca d'acciaio, la linea gialla, l'imboccatura del tunnel ambrata).
| Inquadratura | Guardaroba | Ombrello | Valigetta | Set |
|---|---|---|---|---|
| 1 La corsa | 5 su 5, giacca aperta | Sì | Sì | 6 su 6 |
| 2 Il musicista di strada | 5 su 5, più la giacca a vento, la felpa con cappuccio e il sassofono di Ozzy | Sì | Sì | 6 su 6 |
| 3 Le porte | 4 su 5: gli stivali sono fuori campo | Sì, anche se non in questo prompt | Sì | 6 su 6, più il treno |
| 4 L'inserto | Nessuna persona | No | Sì, fermo immagine dal primo fotogramma | 6 su 6, più il treno |
| 5 La panchina | 5 su 5 | Sì | No: posato nel piano 4 | 6 su 6 |
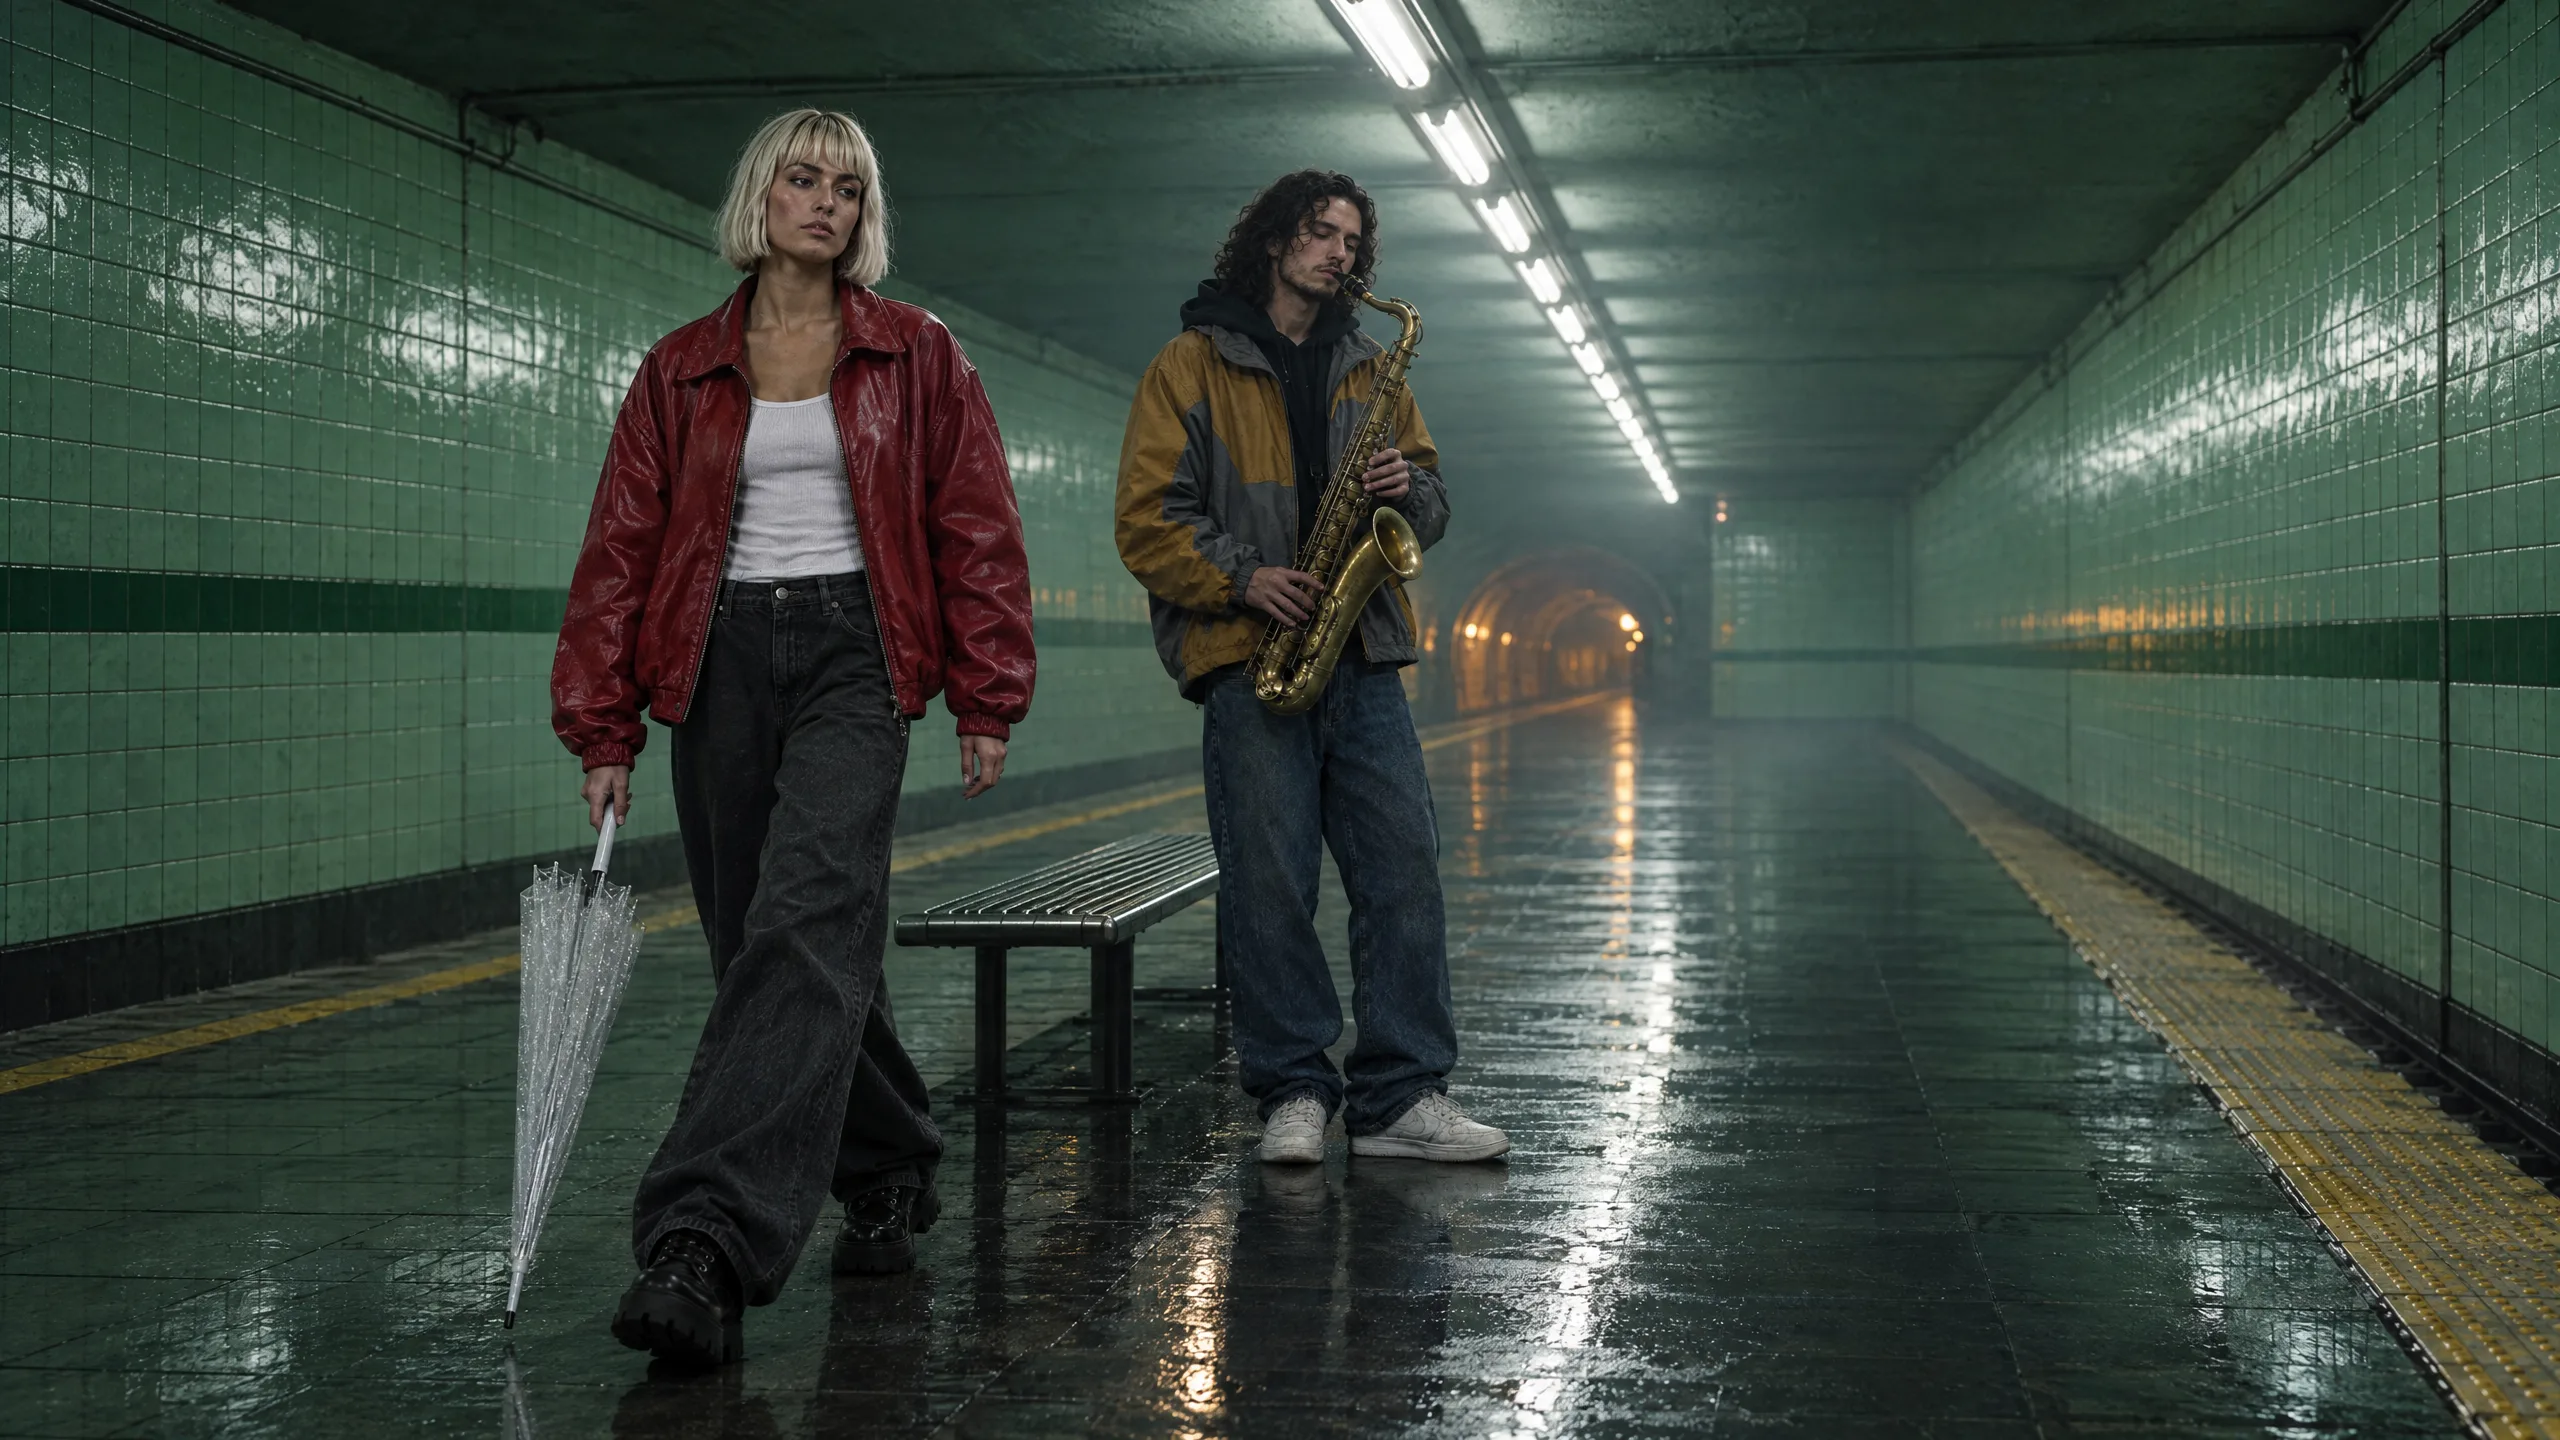
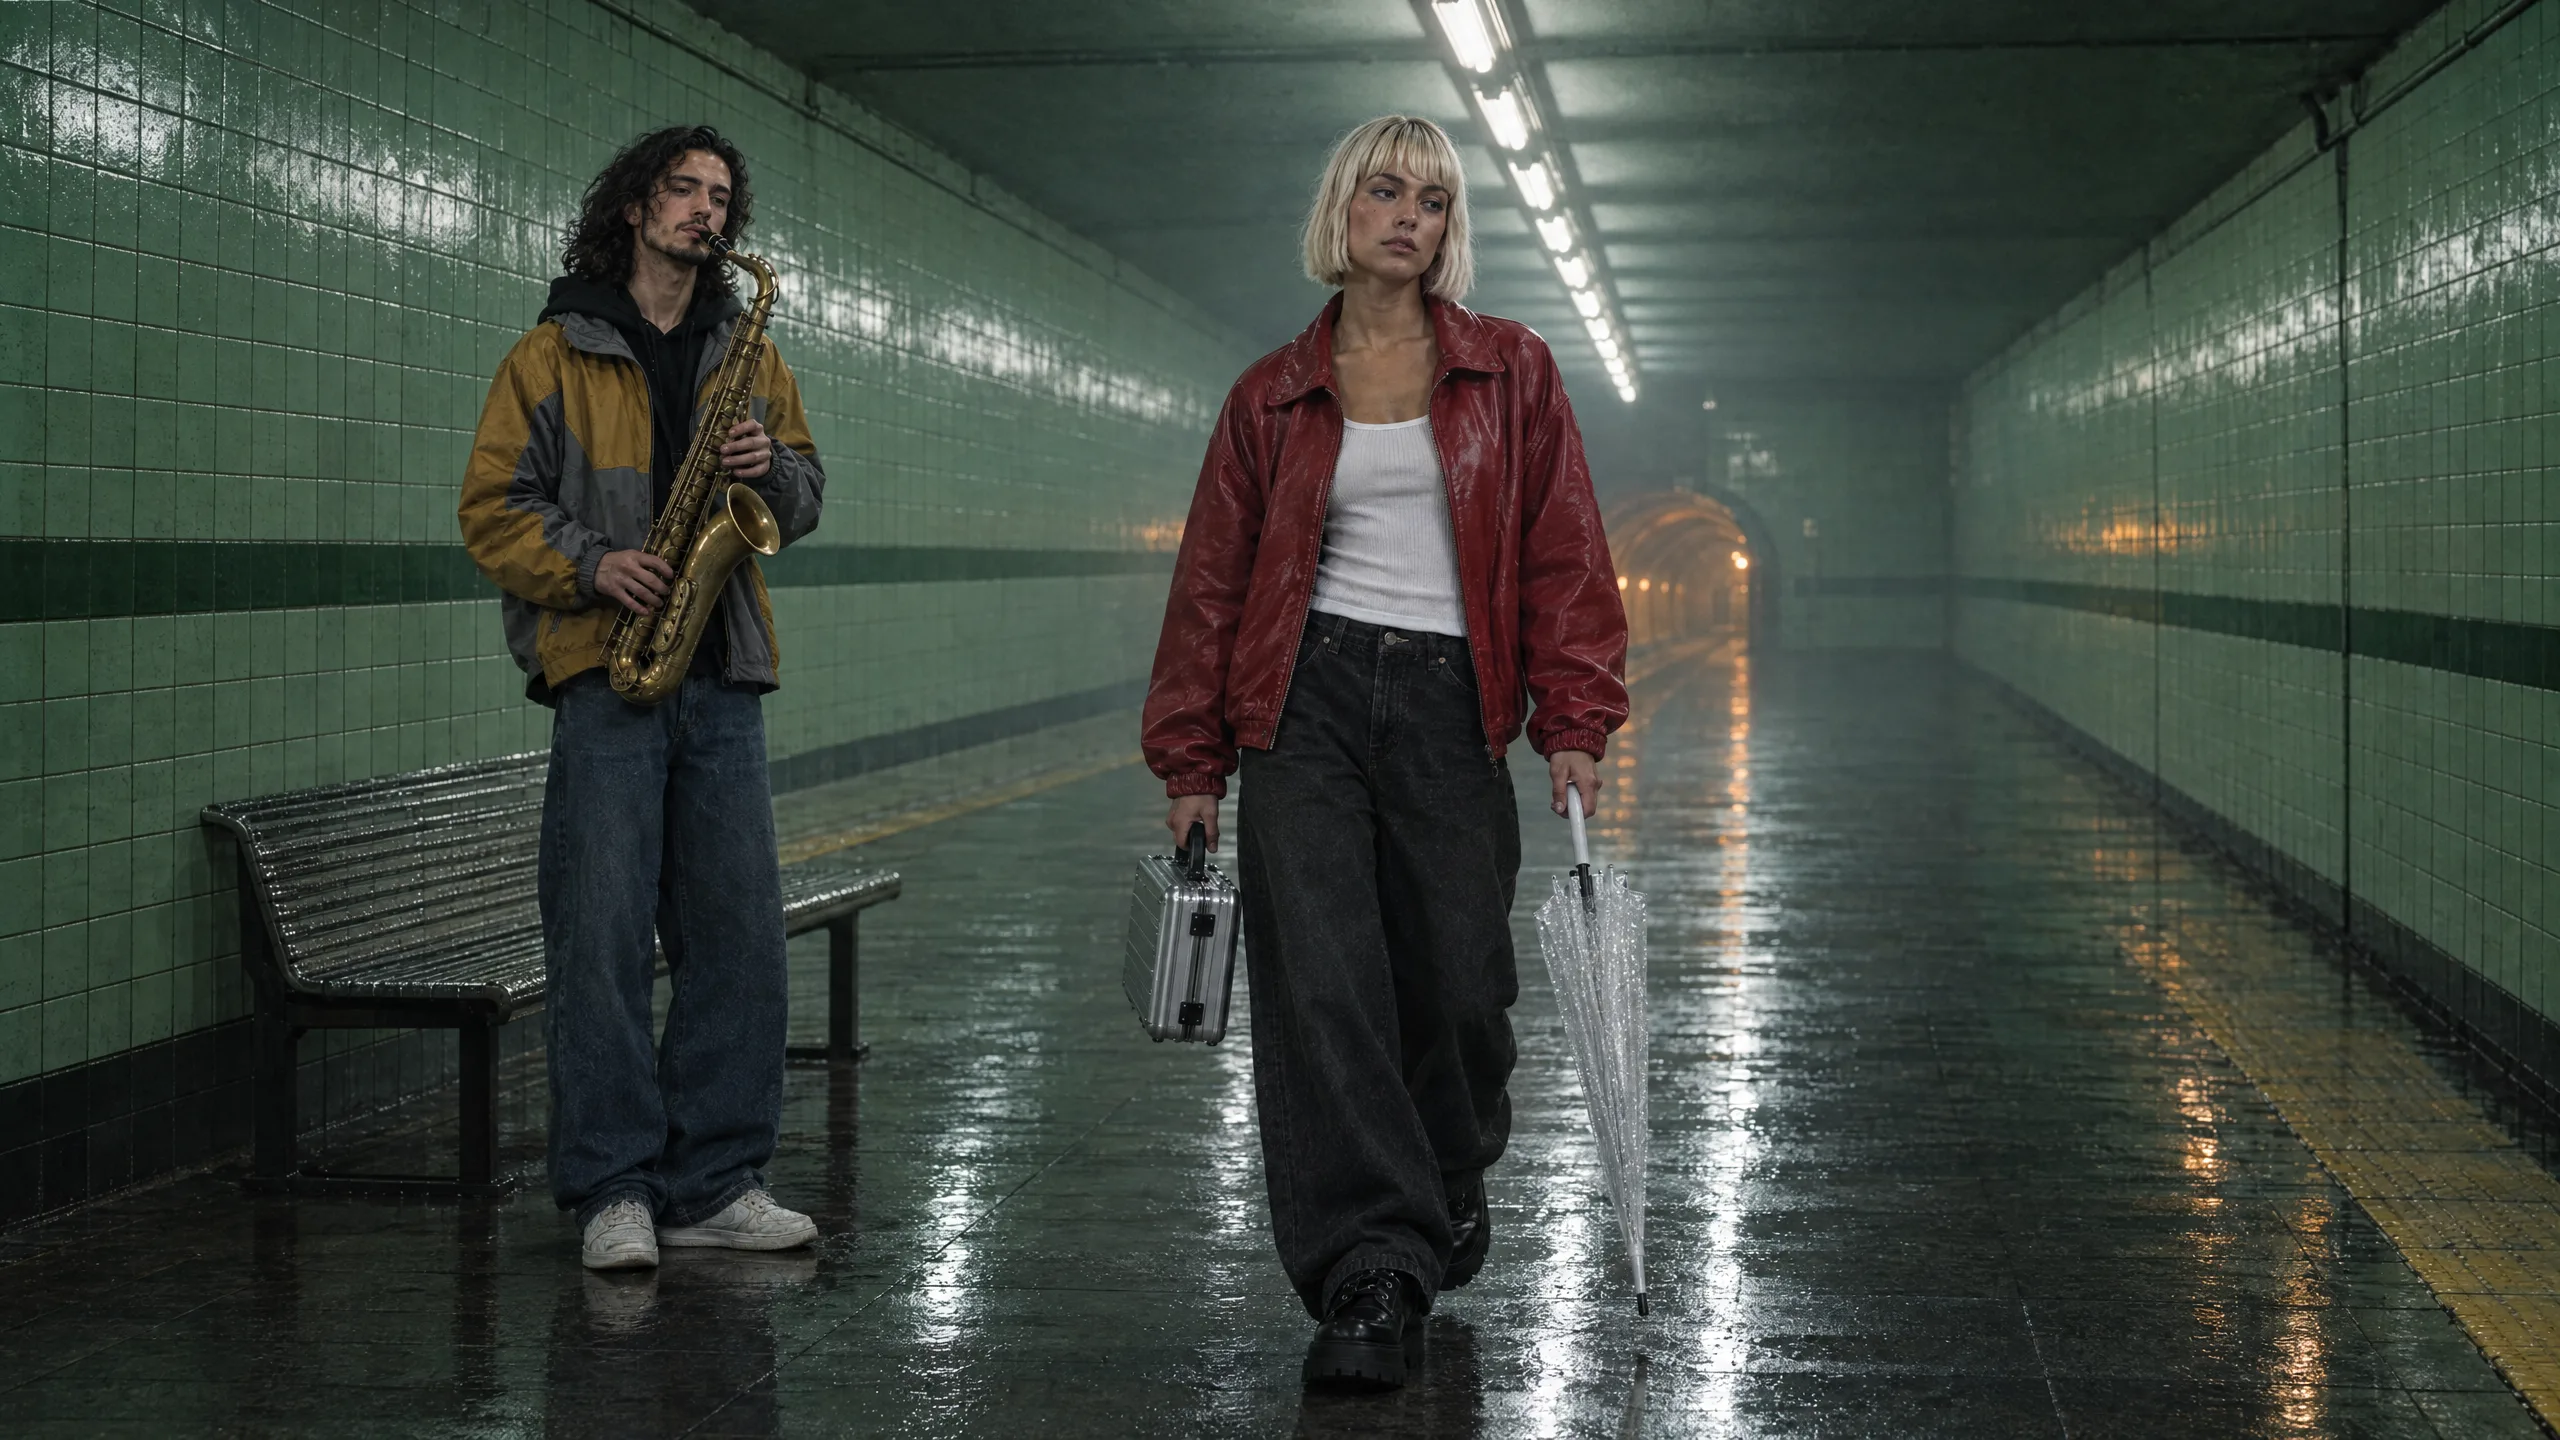
Attenzione:Il problema: la valigetta è scomparsa dal primo fotogramma 2. La nostra prima versione del fotogramma 2 nominava Ozzy, la panchina, il sassofono e l'ombrello, ma non la valigetta. Quindi non c'era la valigetta, anche se Vale la porta nei fotogrammi 1 e 3. Niente porta avanti un oggetto per te. La soluzione è stata banale: aggiungere la frase sulla valigetta al prompt e rifare il fotogramma.
Prima versione: la frase omessa
Seconda versione: la frase nel prompt
Attenzione:Il caso inverso: un oggetto che il prompt non ha mai nominato. Succede anche il contrario. Il prompt del Frame 3 nomina la valigia e non l'ombrello, eppure l'ombrello è arrivato comunque, perché la descrizione salvata di Vale ne mette uno nella sua mano. La descrizione di un personaggio viene applicata a ogni inquadratura a cui è collegato.
Cosa ha funzionato: la palette
Un set è anche un colore. Abbiamo misurato ogni fotogramma di ogni inquadratura a due fotogrammi al secondo: la percentuale di pixel saturi la cui tonalità rientra nella banda verde del set, nella banda ambra del tunnel e nella banda rossa della giacca, e la luminosità media. L'immagine statica della Location è la riga di riferimento.
| Inquadratura | Verde | Ambra | Rosso giacca | Luminosità |
|---|---|---|---|---|
| Immagine statica Location (riferimento) | 69% | 1% | 0% | 0.26 |
| 1 La corsa | 65% | 3% | 3% | 0.28 |
| 2 Il musicista di strada | 33% | 6% | 9% | 0.28 |
| 3 Le porte | 19% | 12% | 8% | 0.25 |
| 4 L'inserto | 37% | 17% | 0% | 0.35 |
| 5 La panchina | 45% | 13% | 11% | 0.28 |
La sequenza è quella più vicina all'immagine fissa: un'inquadratura larga lungo la banchina è per lo più muro. L'inquadratura delle porte ha meno verde perché il treno riempie la destra del fotogramma, e l'inserto è il più luminoso perché i fari del treno escono dal tunnel dietro la valigetta. Non è la palette a cambiare; sono semplicemente ciò che l'inquadratura mostra.
Cosa non ha retto e cosa non affermiamo
- Il volto. Non abbiamo misurato se il volto di Vale appartenga alla stessa persona da un'inquadratura all'altra, quindi questa guida non lo afferma. Il conteggio sopra copre l'abbigliamento, i capelli e gli oggetti di scena.
- Un oggetto di scena senza la sua frase. La valigetta mancava dal primo fotogramma 2 perché la sua frase non era in quel prompt.
- Un oggetto di scena dalla descrizione. L'ombrello è apparso nell'inquadratura 3 senza essere nel prompt, perché la descrizione salvata di Vale lo mette nella sua mano. Scrivi l'inquadratura attorno alla descrizione, o specifica cosa tiene ogni mano.
- Una sola ripresa ciascuna, questa volta. Nessuna delle cinque inquadrature ha richiesto una seconda ripresa. In un'altra esecuzione un oggetto di scena può ancora spostarsi o apparire gradualmente, quindi controlla ogni ripresa a dimensione intera.
Quale ancoraggio per quale lavoro
| Vuoi mantenere | Usa | Cosa mantiene qui |
|---|---|---|
| Il guardaroba e i capelli di una persona tra le inquadrature | Un personaggio, allegato, @Nome nel prompt | Ogni elemento nel frame, in 4 su 4 inquadrature con lei (gli stivali fuori campo in una) |
| Un luogo tra le inquadrature | Una location, allegata | 6 su 6 elementi in 5 su 5 inquadrature; il verde del set in ogni inquadratura, la sua quota segue quanto muro è nel frame |
| Un oggetto di scena tra le inquadrature | Una frase in ogni prompt, e un frame con l'oggetto di scena per un inserto statico | Presente ovunque fosse la frase, assente dall'unico frame dove non c'era |
| Due persone in un'inquadratura | Entrambi nel cast, in ordine, nominati con @ nel prompt | Vale e Ozzy, inquadratura 2 |
| Un volto | Niente misurato qui | Non dichiarato |
Quanto costa
Salvare un personaggio o una location non costa nulla. Un frame ha un prezzo per immagine, uno shot dipende dal modello e dalla durata. Tariffe in tempo reale per i modelli usati in questi cinque shot:
GPT Image 2.5 FlareEvery plan
Per image
Native 8 crediti · 2K 21 crediti · 4K 58 crediti
Kling v3Pro and up
Per 5s clip (audio on by default)
720p 35 crediti · 1080p 47 crediti · 4K 117 crediti
Seedance 2.5Pro and up
Per 5s clip
480p 26 crediti · 720p 56 crediti · 1080p 137 crediti
1080p renders at 16:9 and 9:16
Seedream 5.0 ProEvery plan
Per image
1K 5 crediti · 2K 9 crediti
Letto in tempo reale dal catalogo quando la pagina si carica. Ogni prezzo viene mostrato prima che tu generi. Vedi tutte le tariffe.
Checklist
- Un personaggio per ogni persona ricorrente, salvato con un'immagine di riferimento principale e una descrizione.
- Una location per ogni luogo, salvata con un'immagine fissa e una frase.
- Una frase per ogni oggetto di scena, in ogni prompt dove l'oggetto deve essere visibile.
- Frame in 16:9 con il Cast e la Location allegati; shot animati a partire dai frame.
- Ogni shot controllato rispetto alla lista a grandezza naturale prima del montaggio; un errore richiede la rifacimento di un solo prompt, non di tutto il film.
Provalo tu stesso
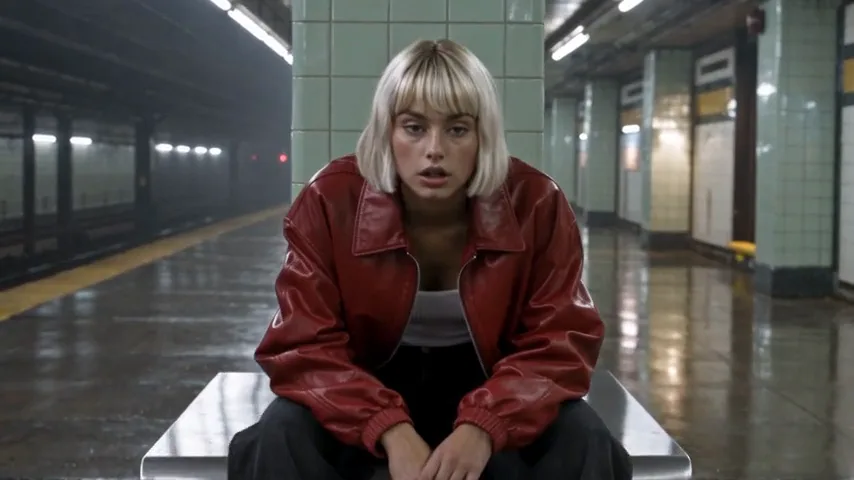
Salva il ritratto qui sotto come riferimento di un personaggio e la stazione come riferimento di una location, allega entrambi nel compositore di immagini in 16:9 e usa il prompt del frame 1 dalla guida al cortometraggio. Poi fai il tuo conteggio: cinque capi di abbigliamento, due oggetti di scena, sei elementi di set, shot per shot.
Domande e risposte
- È lo stesso volto di persona in shot diversi?
- Non lo abbiamo misurato, quindi non lo affermiamo. Ciò che abbiamo misurato e che possiamo dire sia rimasto coerente sono l'abbigliamento, i capelli, gli oggetti di scena e il set.
- Come fa un personaggio a mantenere il suo abbigliamento?
- Il suo riferimento visivo principale viene inviato come immagine di riferimento con ogni prompt a cui è allegato, e la sua descrizione viene inviata come testo. Entrambi indicano la stessa giacca, gli stessi stivali e lo stesso caschetto, e il modello li renderizza. La descrizione può anche introdurre elementi che il prompt non richiedeva: l'ombrello nella inquadratura 3 proviene da essa.
- Perché la valigetta è scomparsa da un'inquadratura?
- Perché la sua frase non era nel prompt di quell'inquadratura. Un oggetto di scena è coerente solo quanto le parole che lo descrivono in ogni prompt, quindi incolla la stessa frase in tutti; la seconda versione di quell'inquadratura, con la frase, mostra la valigetta.
- La location deve ancora essere una foto?
- No. La nostra è un'immagine statica creata con Seedream 5.0 Pro. Qualsiasi immagine statica del luogo, caricata o generata, funziona come riferimento per la location.
- Posso allegare il personaggio direttamente al modello video?
- Sui modelli che abbiamo provato, non bene: Seedance 2.0 Fast ha rifiutato il suo riferimento, Seedance 1.5 Pro non può gestirne uno, e Seedance 2.5 l'ha accettata ma ha inventato una propria piattaforma. Un'inquadratura 16:9 dal compositore di immagini con la location allegata, poi Animate an image, ha portato entrambi.
- Come è stata misurata la palette?
- Ogni fotogramma a due fotogrammi al secondo, la percentuale di pixel saturi in tre bande di tonalità, mediata per inquadratura, rispetto alla stessa misura sull'immagine statica della location.
Salva il cast e la location una sola volta
Apri PersonaggiGuide correlate
Cinema
Un cortometraggio con l'AI: la pipeline dallo script al montaggio finale
Un film di 25 secondi, Last Train, da uno script di cinque righe a un montaggio colorizzato: un personaggio salvato, una location salvata, un oggetto di scena, prima i frame, poi le inquadrature, l'audio, Studio e l'esportazione in Premiere o Resolve.
· 13 min di lettura
Montaggio video
Metti il tuo personaggio e il tuo cane in qualsiasi video
Scegli un video, aggiungi una foto di una persona e una di un cane, e Miroge ricastà la clip con loro: stessi movimenti, stesso set, stessa camera. Ogni passaggio, su computer e telefono.
· 10 min di lettura
Cinema
NOLGIA fa il tuo DIT: copia, verifica e rinomina le tue schede di memoria
Copia le schede di memoria su due unità, verifica ogni copia rispetto alla scheda e ottieni i manifest ASC MHL, un report DIT e file rinominati. Gratis, sul tuo computer.
· 8 min di lettura