

保持镜头间角色和地点的一致性
在 NOLGIA 上,一致性取决于两点:参考图像,以及每次使用相同的措辞。本指南以《Last Train》的五个镜头为例,检查哪些元素保持稳定:服装、道具、布景和色调。我们对此进行了统计。我们并未声称面孔属于同一个人,因为我们尚未对此进行测量。
- 11 分钟阅读
本文由英文自动翻译。阅读原文
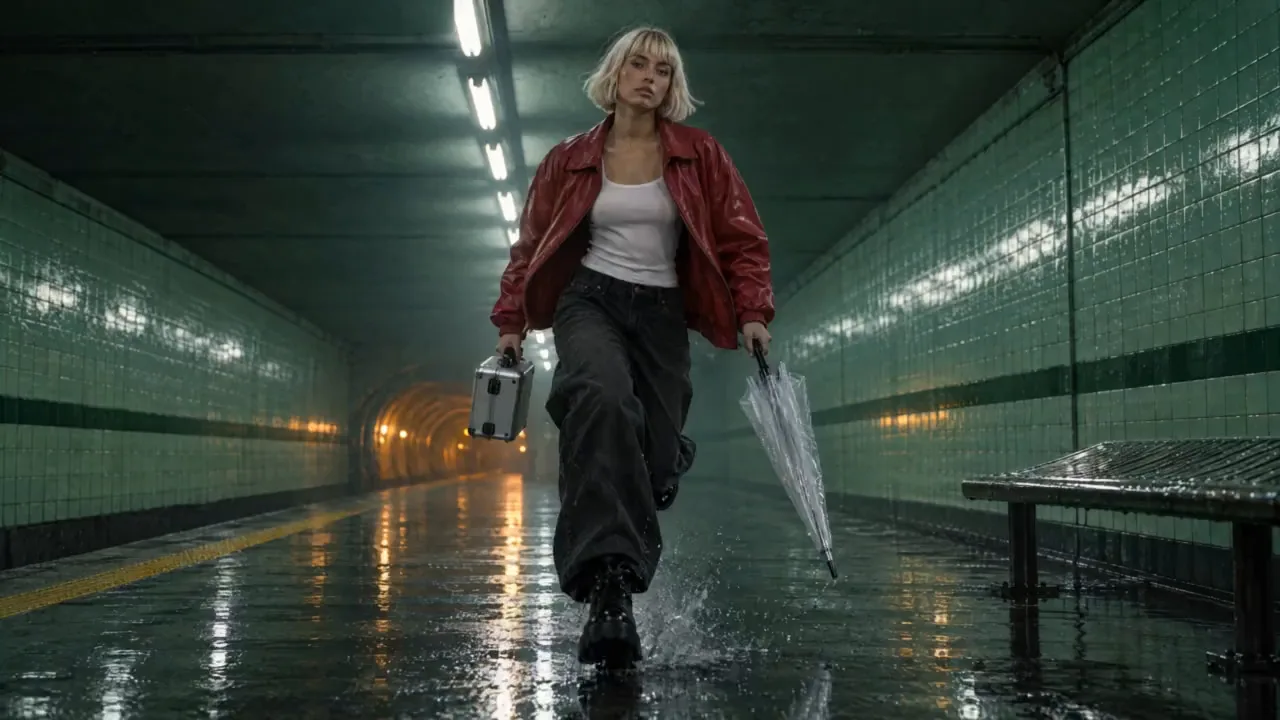
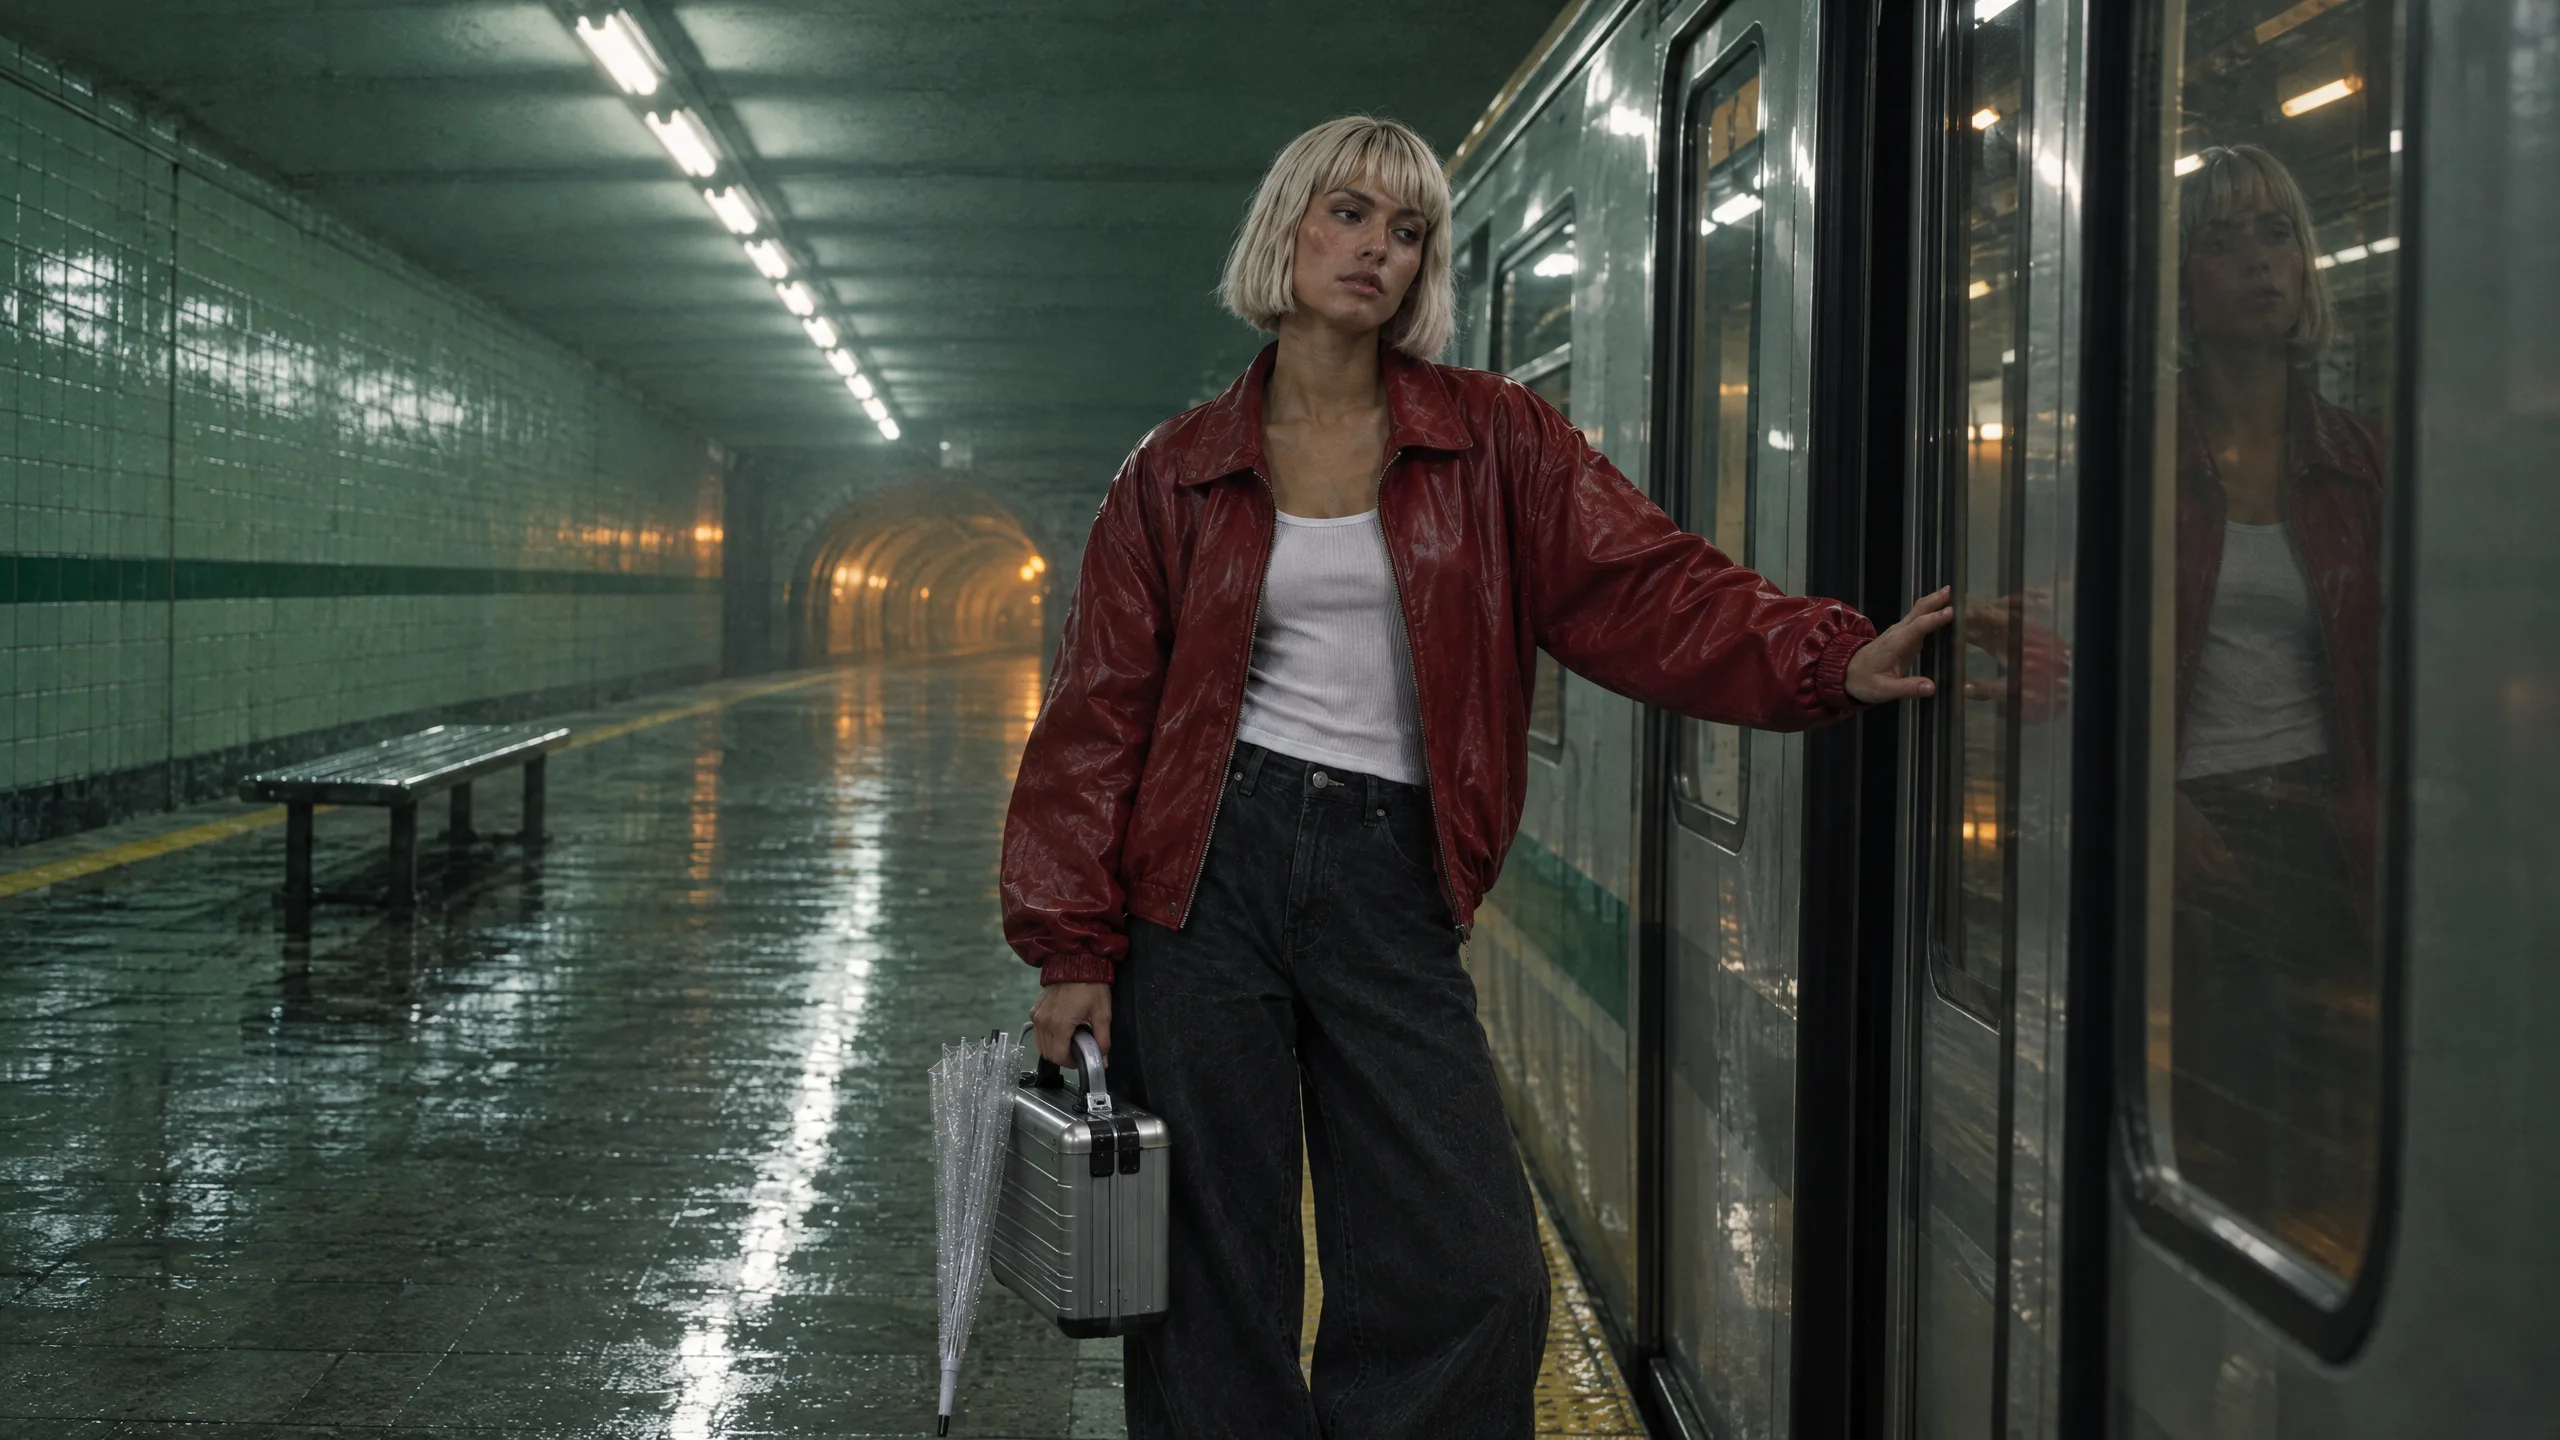
本指南中的镜头来自 Last Train,这是一部为这些指南制作的 25 秒短片,发布在公司的官方账号上。Vale 是一个保存的角色,Halcyon Street 车站是一个保存的地点,镀铬手提箱则是一张静帧图片和一句描述。每个镜头都是在图像编辑器中作为 16:9 画幅制作的,并附加了角色和地点,然后在视频编辑器中进行动画处理。其中所有人物均为虚构。
随后,我们对照清单和卷尺逐一检查镜头:每件服装、每个道具以及布景的哪些部分出现在哪个镜头中,以及画面中布景的绿色、隧道的琥珀色和夹克的红色各占多少比例。以下是统计结果,包括两处失败的情况。
常见错误
| 错误 | 失败原因 | 修正 |
|---|---|---|
| 在每个提示词中重新描述角色 | 每个提示词都是独立的请求;外套可能变成夹克,波波头可能变成马尾辫 | 保存带有参考图片和单一描述的角色,将其附加,并输入 @Name |
| 在一个镜头中描述地点,然后假设其他镜头也如此 | 模型每次都会凭空创造一个新的站台 | 保存带有静态图片和一句话描述的地点,并将其附加到每个镜头 |
| 在某个提示词中遗漏道具 | 无论上一个镜头显示了什么,该道具在这个镜头中消失了 | 为每个道具写一句话,粘贴到它应该出现的每个提示词中 |
| 直接将角色发送给视频模型 | 一个模型拒绝照片级真实感的参考图,另一个无法承载参考图,而接受参考图的模型则会自行创造布景 | 首先使用附加的演员阵容制作一个 16:9 的画面,然后对其进行动画处理 |
| 信任良好的第一秒 | 随着片段播放,布景会重复,道具会发生位移 | 将镜头时长保持在 4 到 6 秒,并在画面出现偏差时进行剪辑 |
这里的锚点是什么
NOLGIA 上没有经过训练的特定身份。这里有三类锚点,本指南将全部使用:
- 一个角色,来自 角色 页面:最多包含八张参考照片(其中一张为主图),以及一段会随每次提示词一同发送的描述。在任一编辑器中的 角色 下选择它,并在提示词中输入 @Vale。编辑器会将主图放入参考槽位,并将 @Vale 重写为该槽位。
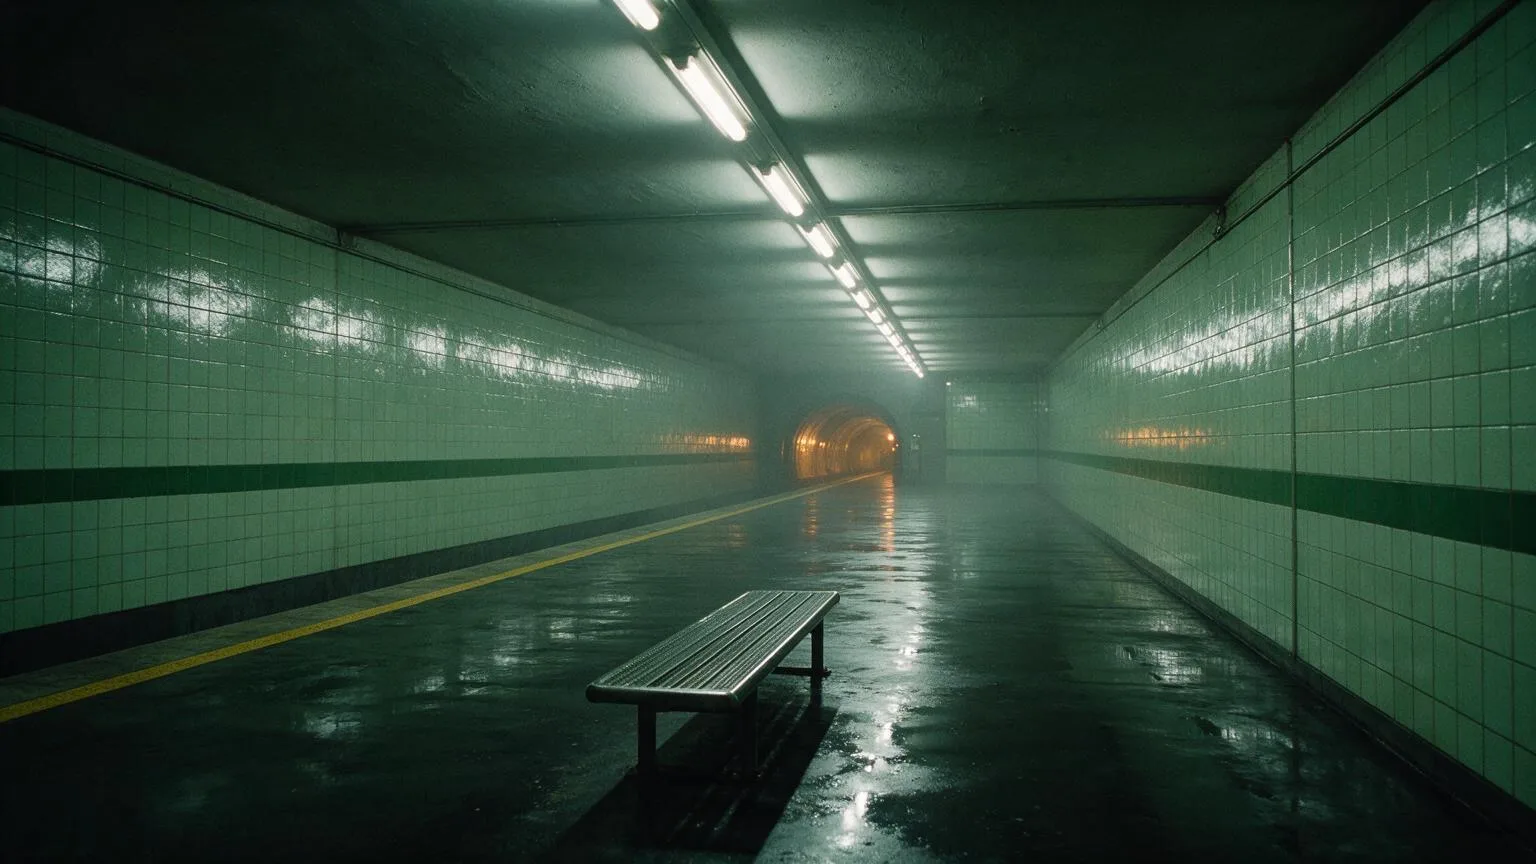
- 一个地点,来自 地点 页面:一张静帧图像和一段标准描述。在 地点 下选择它,静帧图像将作为参考图随该描述一同发送。
- 一句话,用于其他任何内容。例如镀铬箱子这个案例,就是一句话,原样粘贴到每个适用的提示词中,并为其插入镜头单独使用一张静帧图像作为参考。
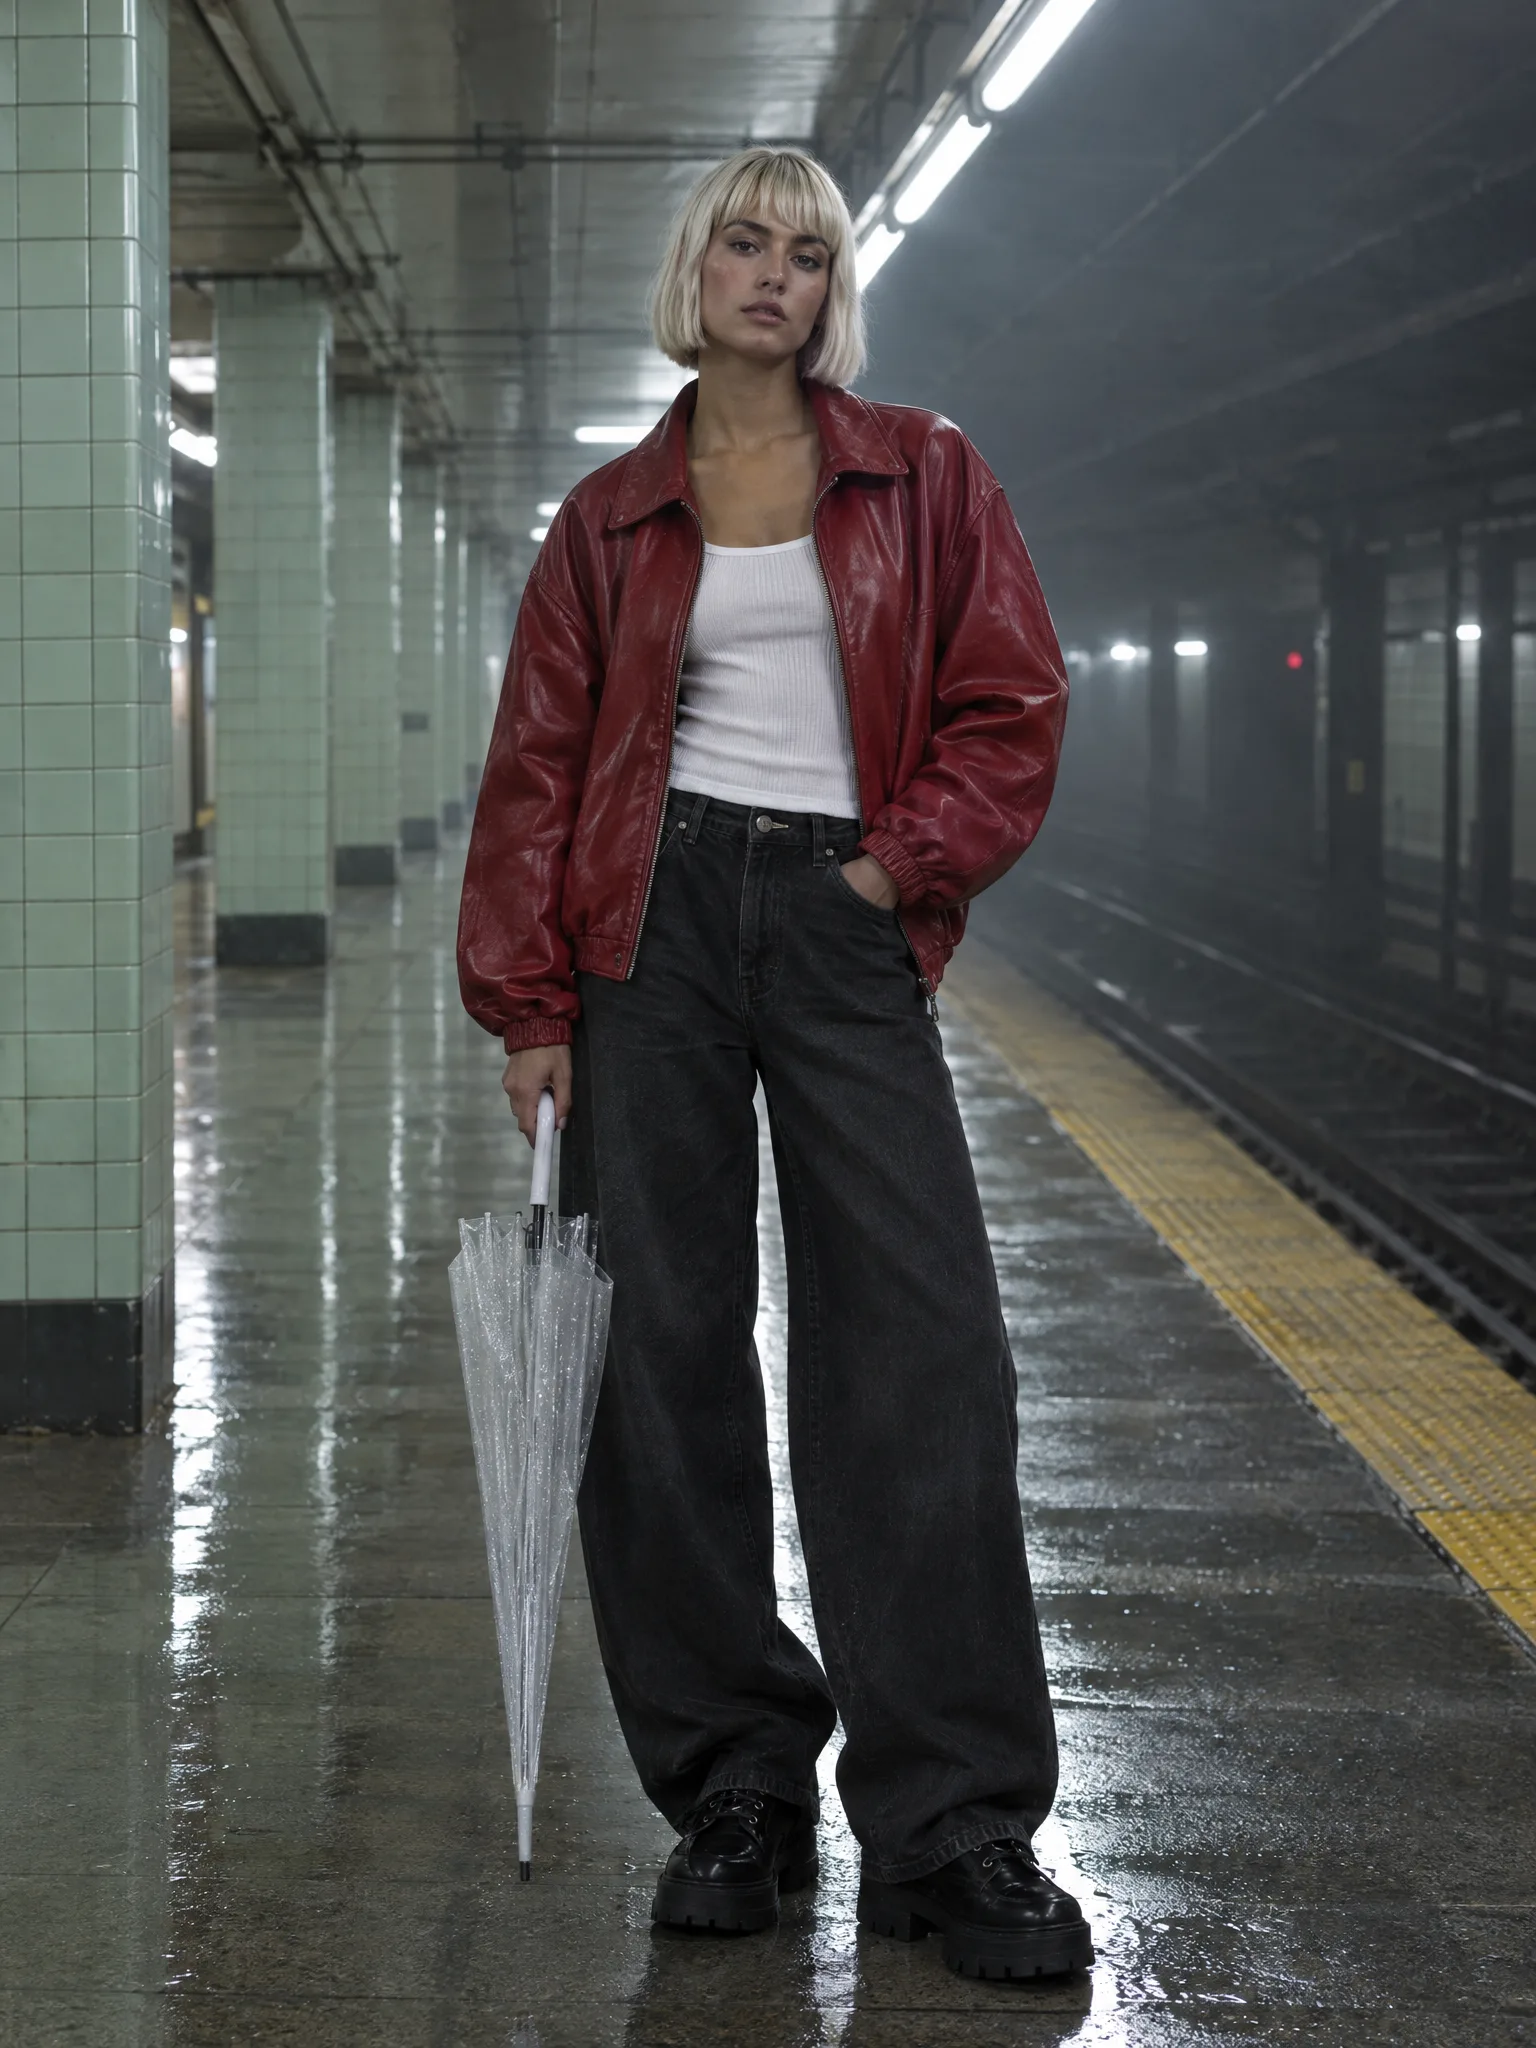
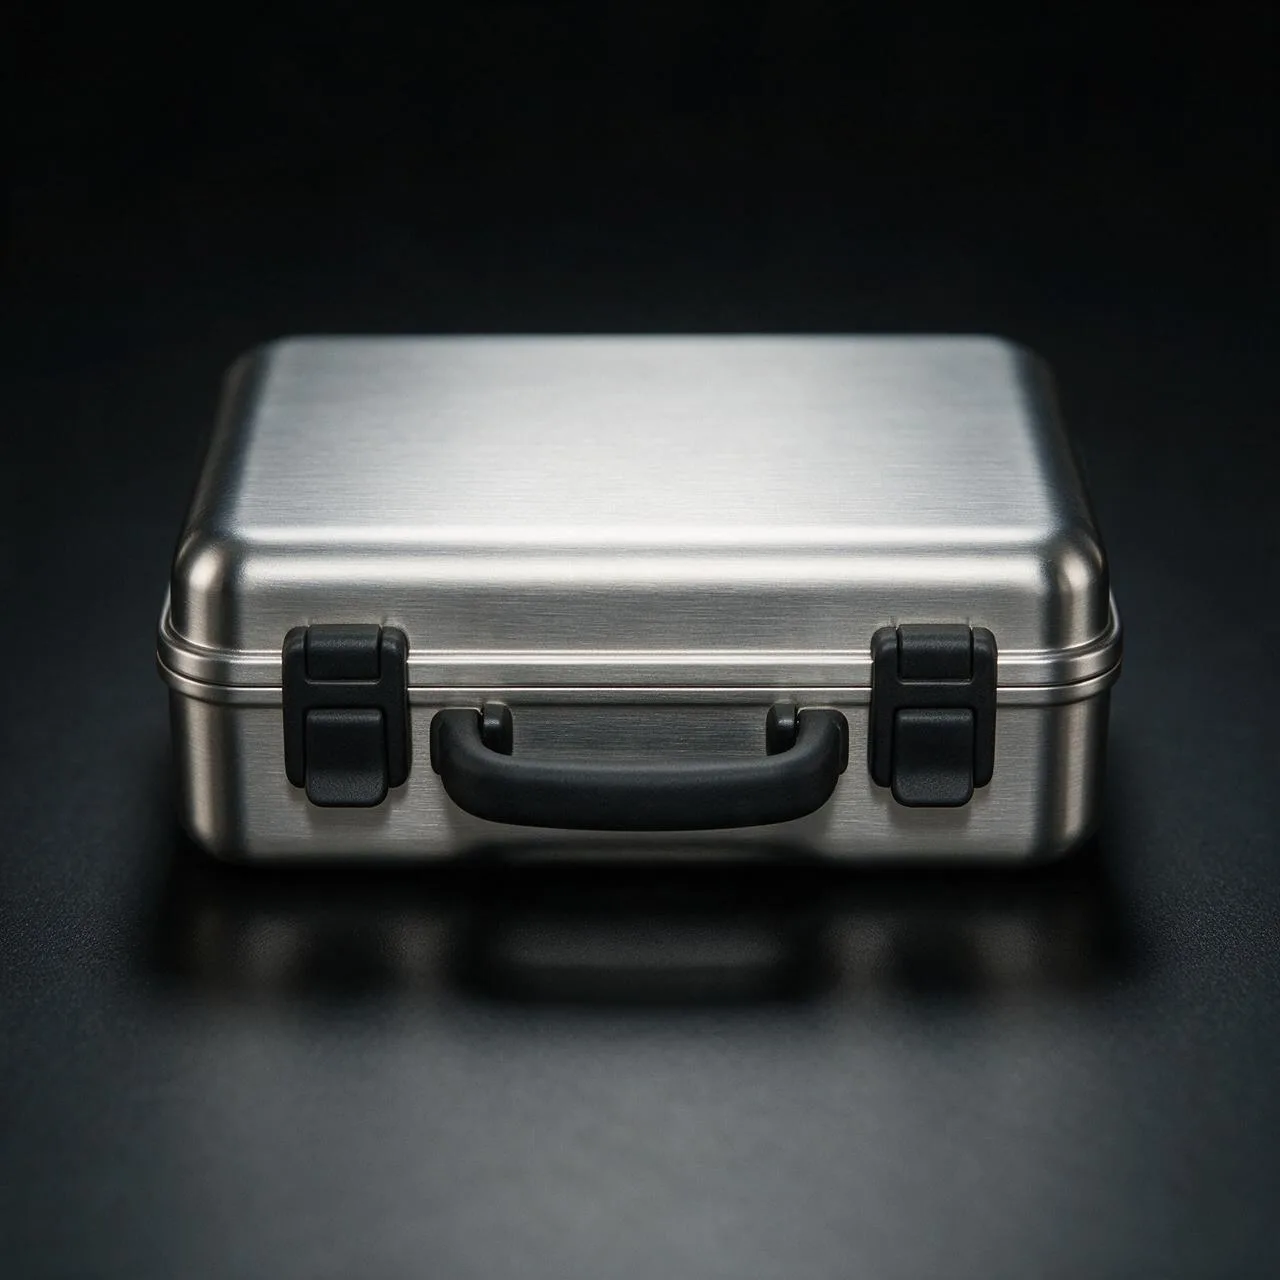
The lead of Last Train: a woman in her early twenties with a platinum blonde sleek chin-length bob and a straight fringe, an oversized cherry-red leather bomber jacket over a white ribbed tank, wide black jeans, chunky black platform lace-up boots, a folded transparent bubble umbrella in one hand.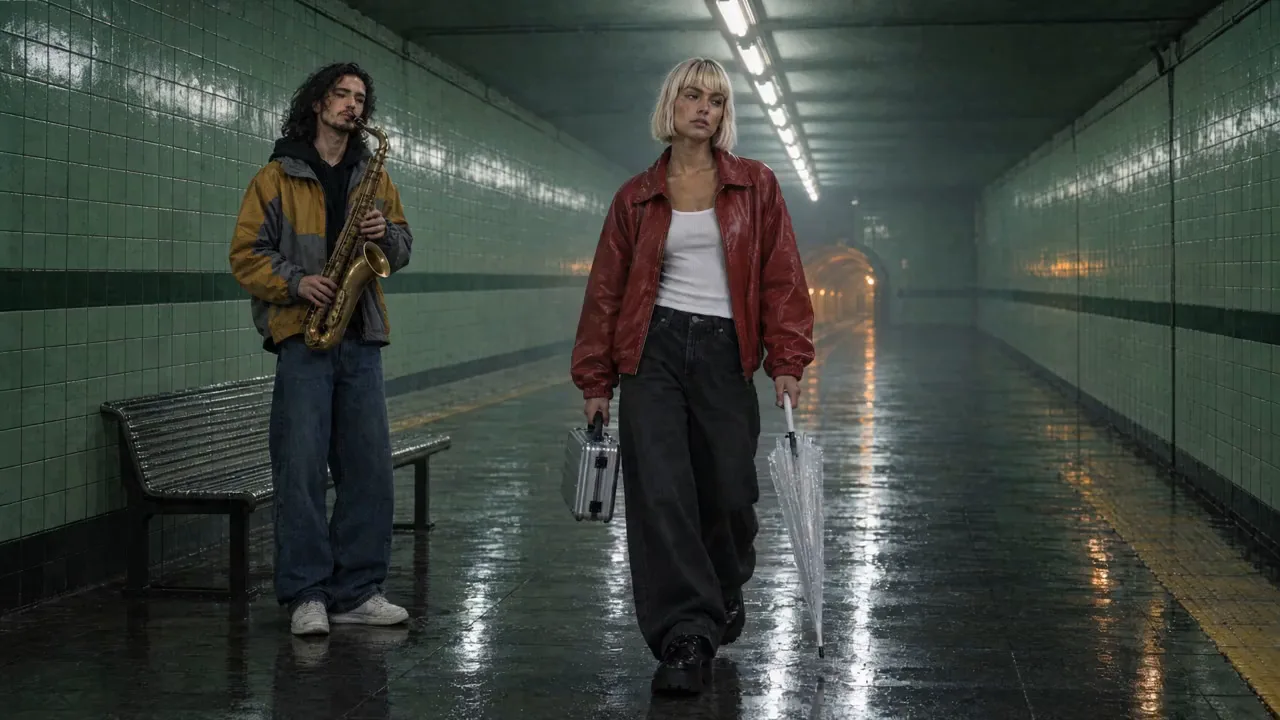
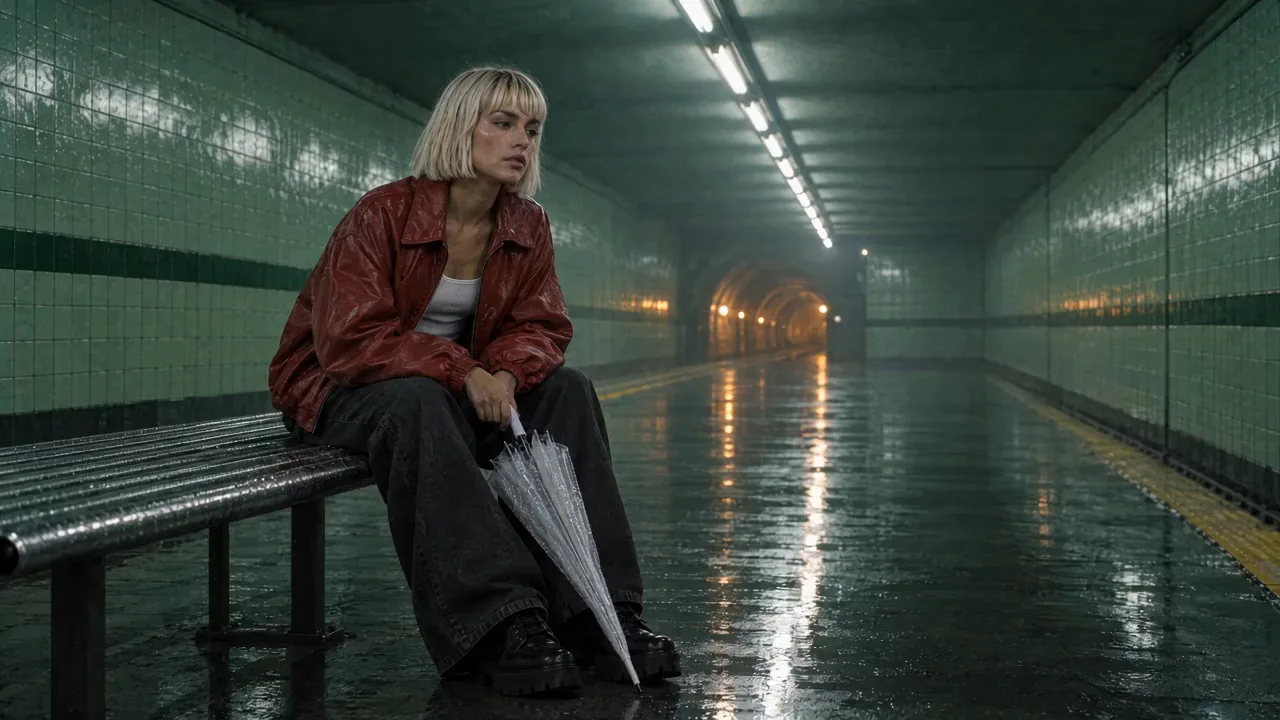
逐镜头检查:服装、道具和布景的一致性
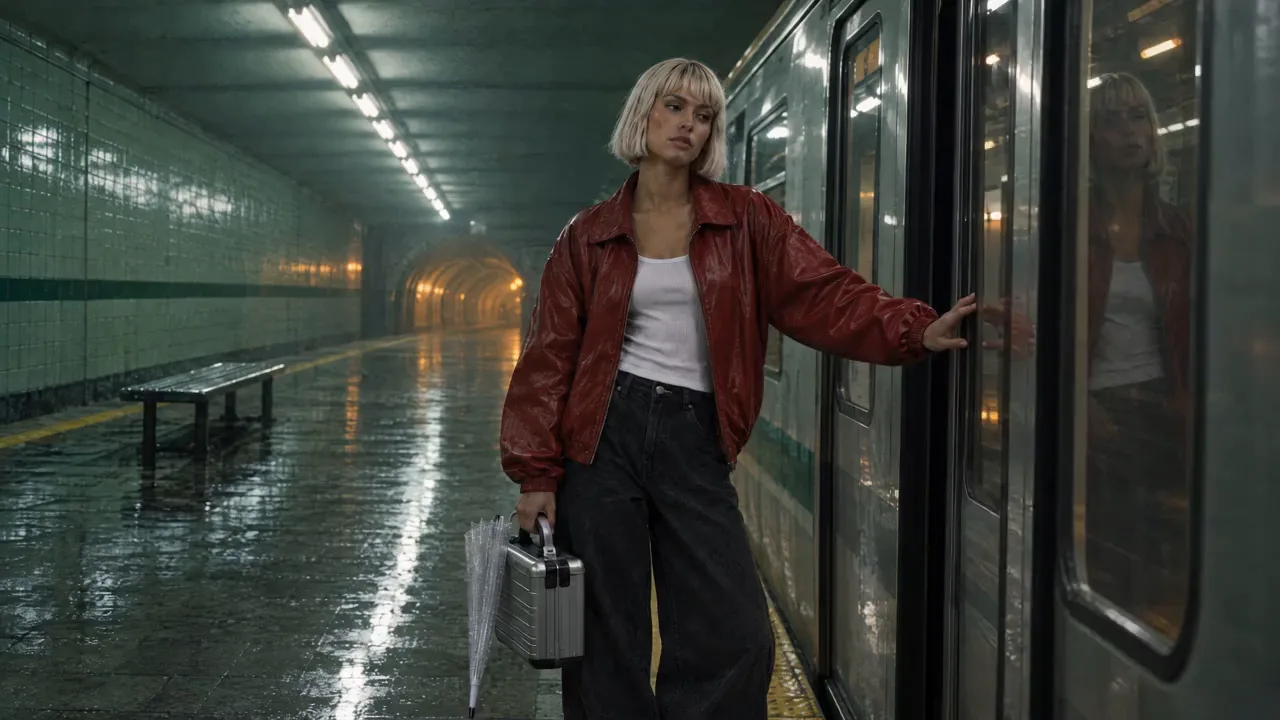
我们以每秒两帧的速度检查了每个镜头,并核对了一份清单:五件服装(樱桃红皮夹克、白色罗纹背心、宽版黑色牛仔裤、黑色厚底靴、铂金色波波头)、两件道具(透明雨伞、铬色箱子)以及六个布景元素(浅绿色瓷砖、深绿色条纹、荧光灯管、钢制长椅、黄色标线、琥珀色隧道口)。
| 镜头 | 衣橱 | 雨伞 | 箱子 | 布景 |
|---|---|---|---|---|
| 1 奔跑 | 5/5,夹克敞开 | 是 | 是 | 6/6 |
| 2 街头艺人 | 5/5,加上 Ozzy 的防风夹克、连帽衫和萨克斯 | 是 | 是 | 6/6 |
| 3 车门 | 4/5:靴子在画面外 | 是,尽管此提示词中未包含 | 是 | 6/6,加上火车 |
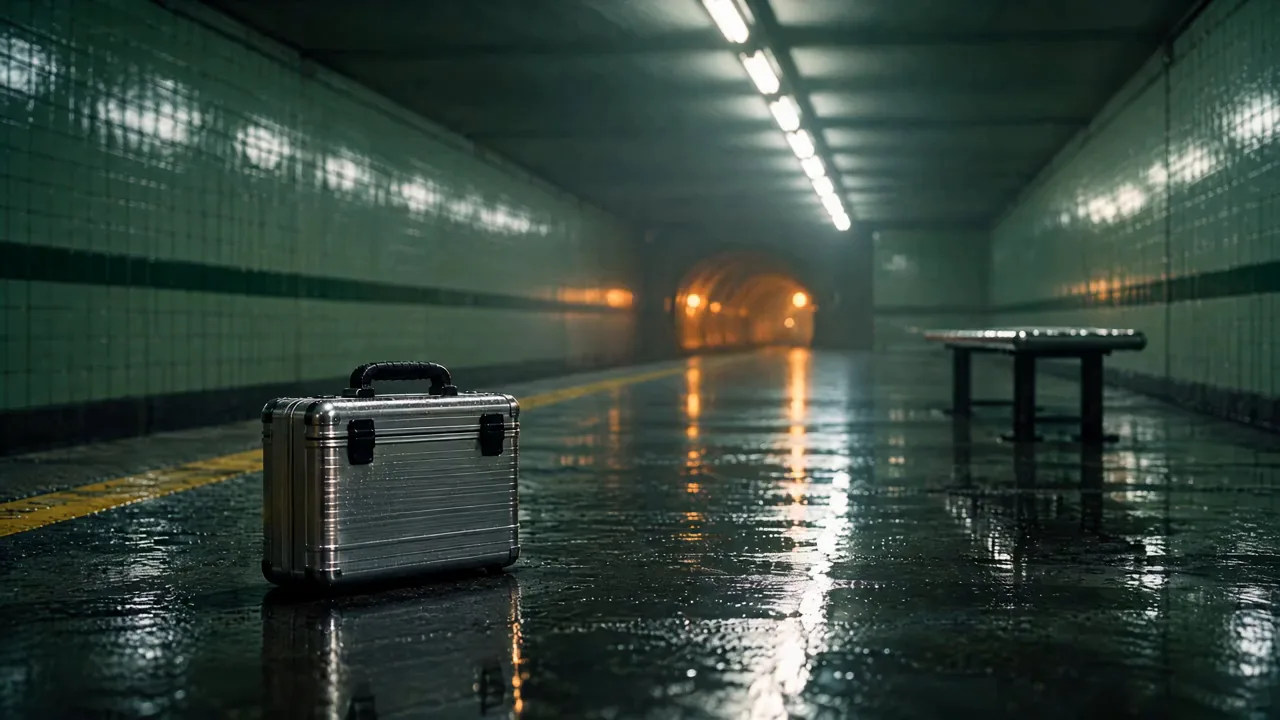
| 4 插入镜头 | 无人物 | 否 | 是,来自第一帧的静帧 | 6/6,加上火车 |
| 5 长椅 | 5/5 | 是 | 否:在第 4 个镜头中放下 | 6/6 |
注意:差距:手提箱从第一帧 2 中消失. 我们第一版帧 2 的提示词提到了 Ozzy、长椅、萨克斯和雨伞,但没有提到手提箱。因此画面中没有手提箱,尽管她在帧 1 和帧 3 中都提着它。没有任何机制会自动为你延续道具。解决方法很平淡:在提示词中加入关于手提箱的描述,然后重新生成该帧。
第一版:遗漏了描述
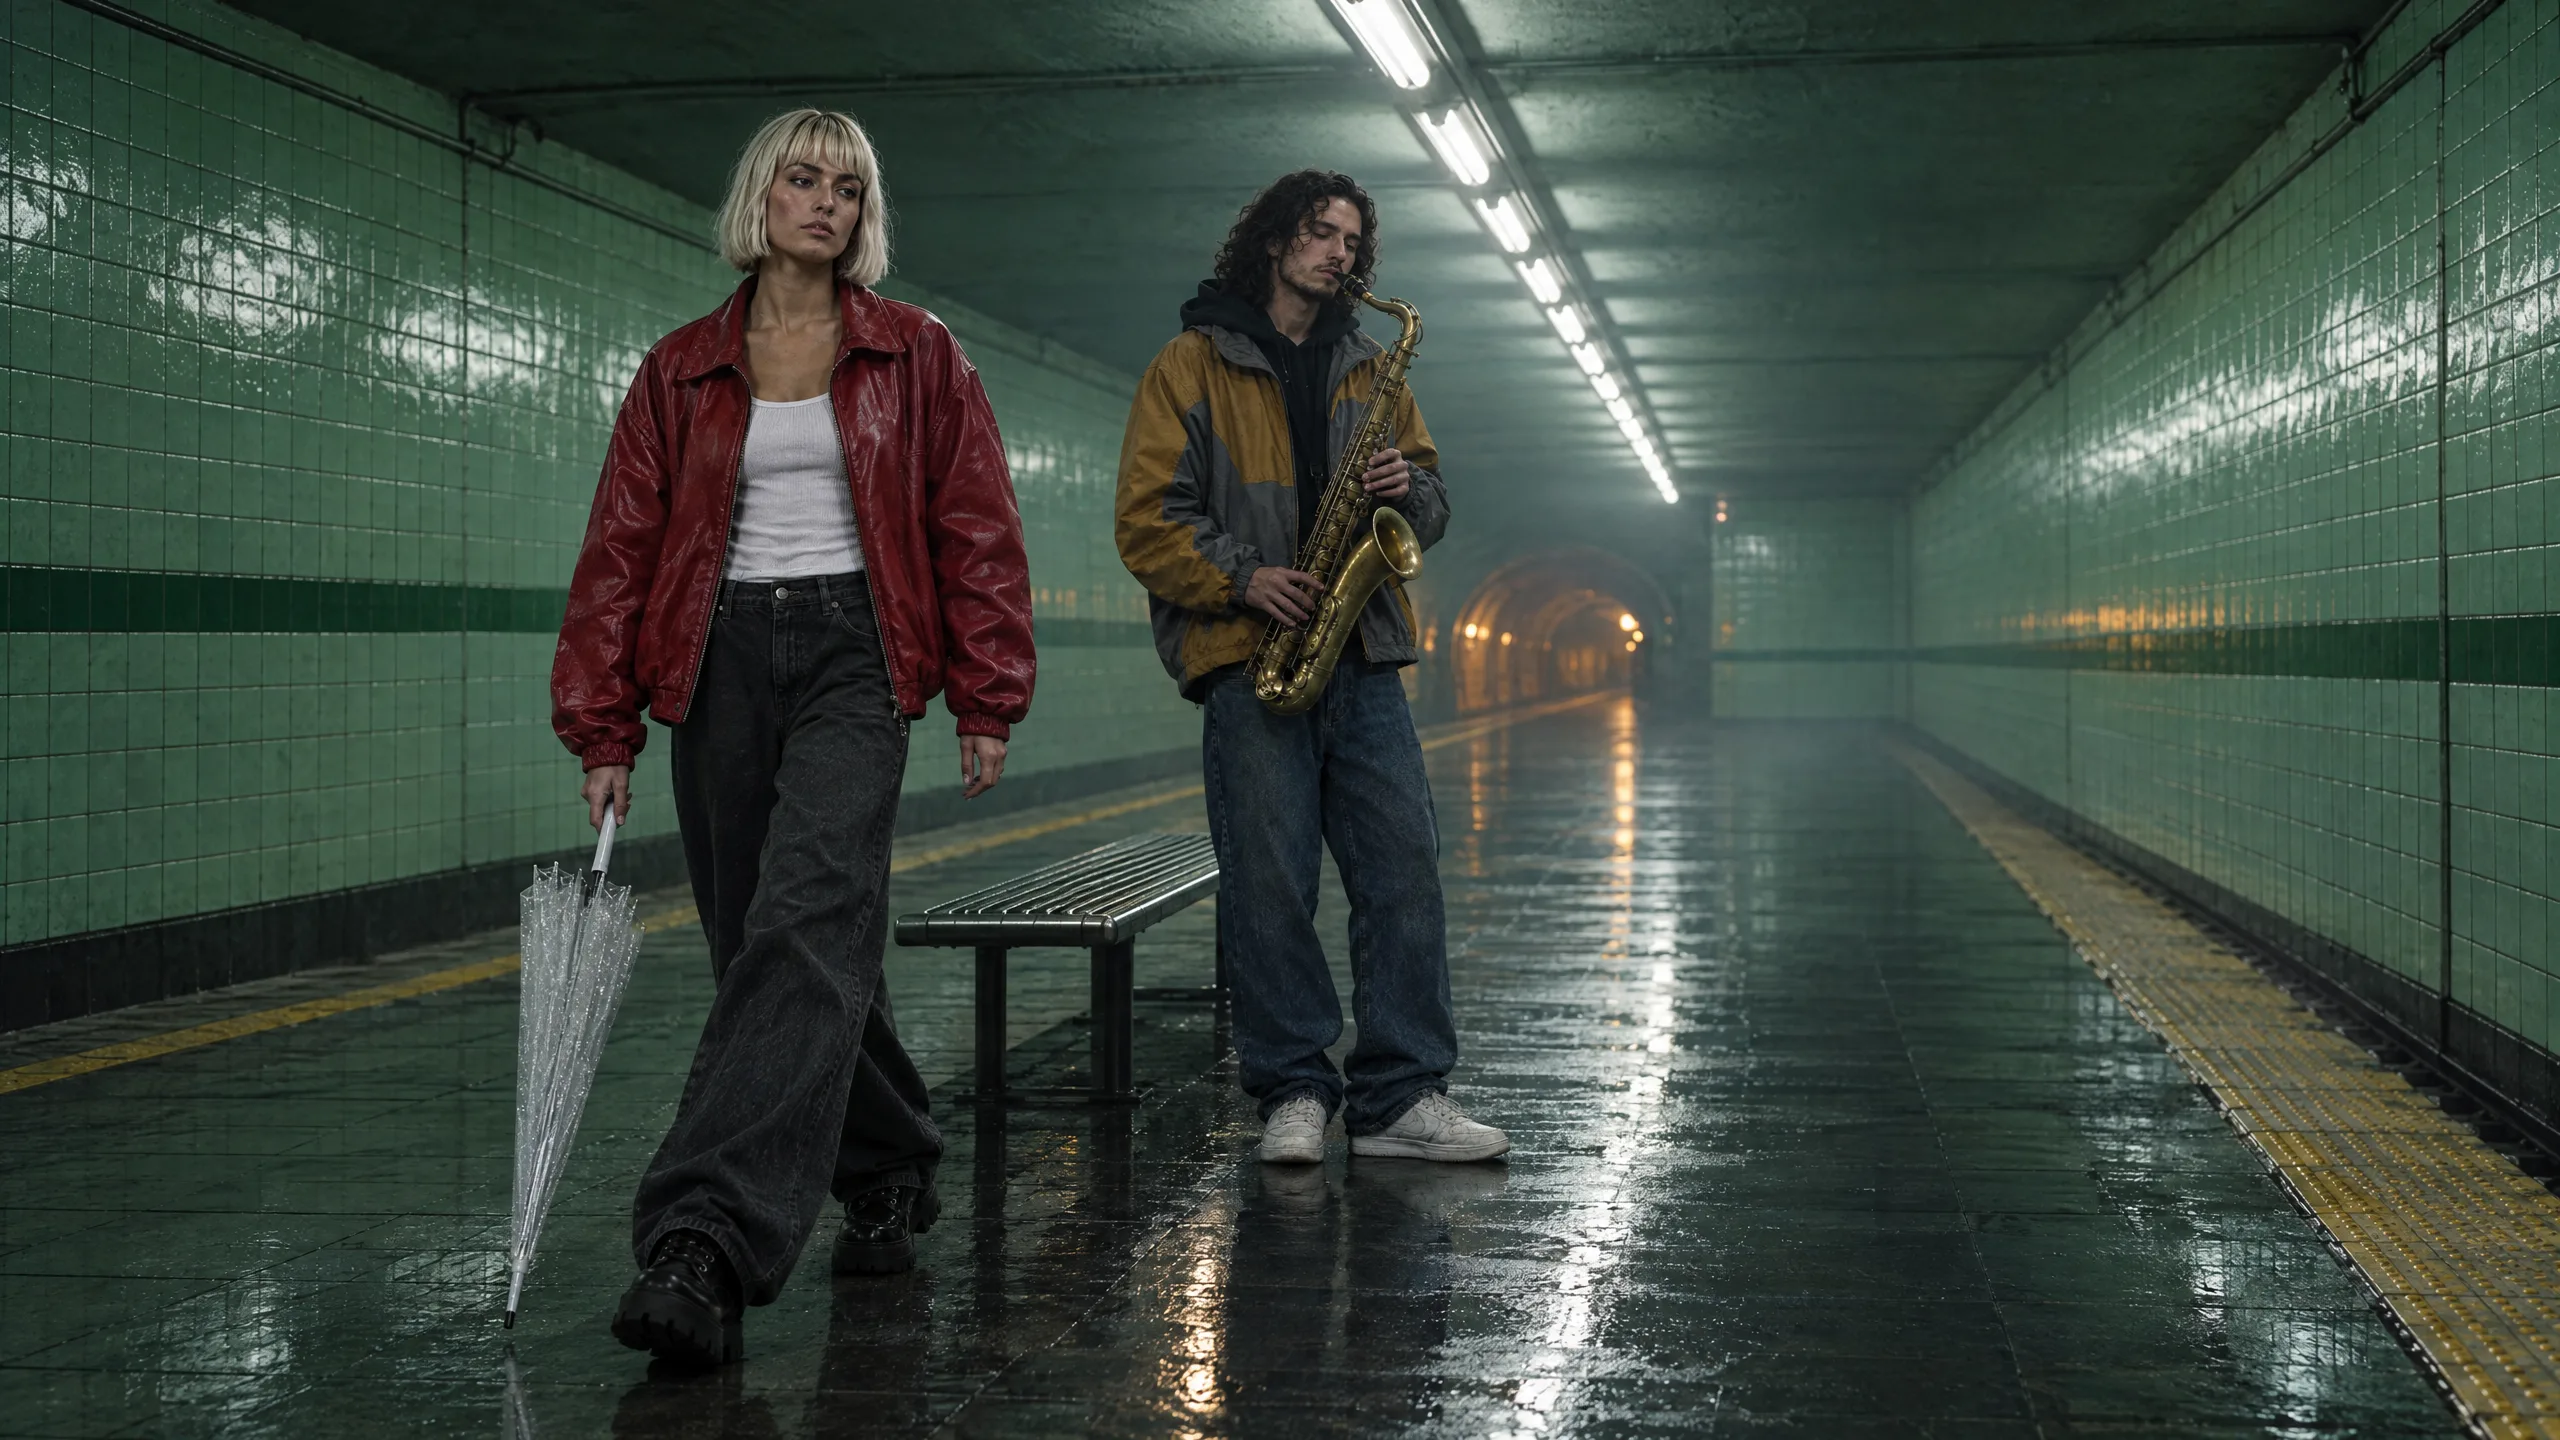
第二版:描述已加入提示词
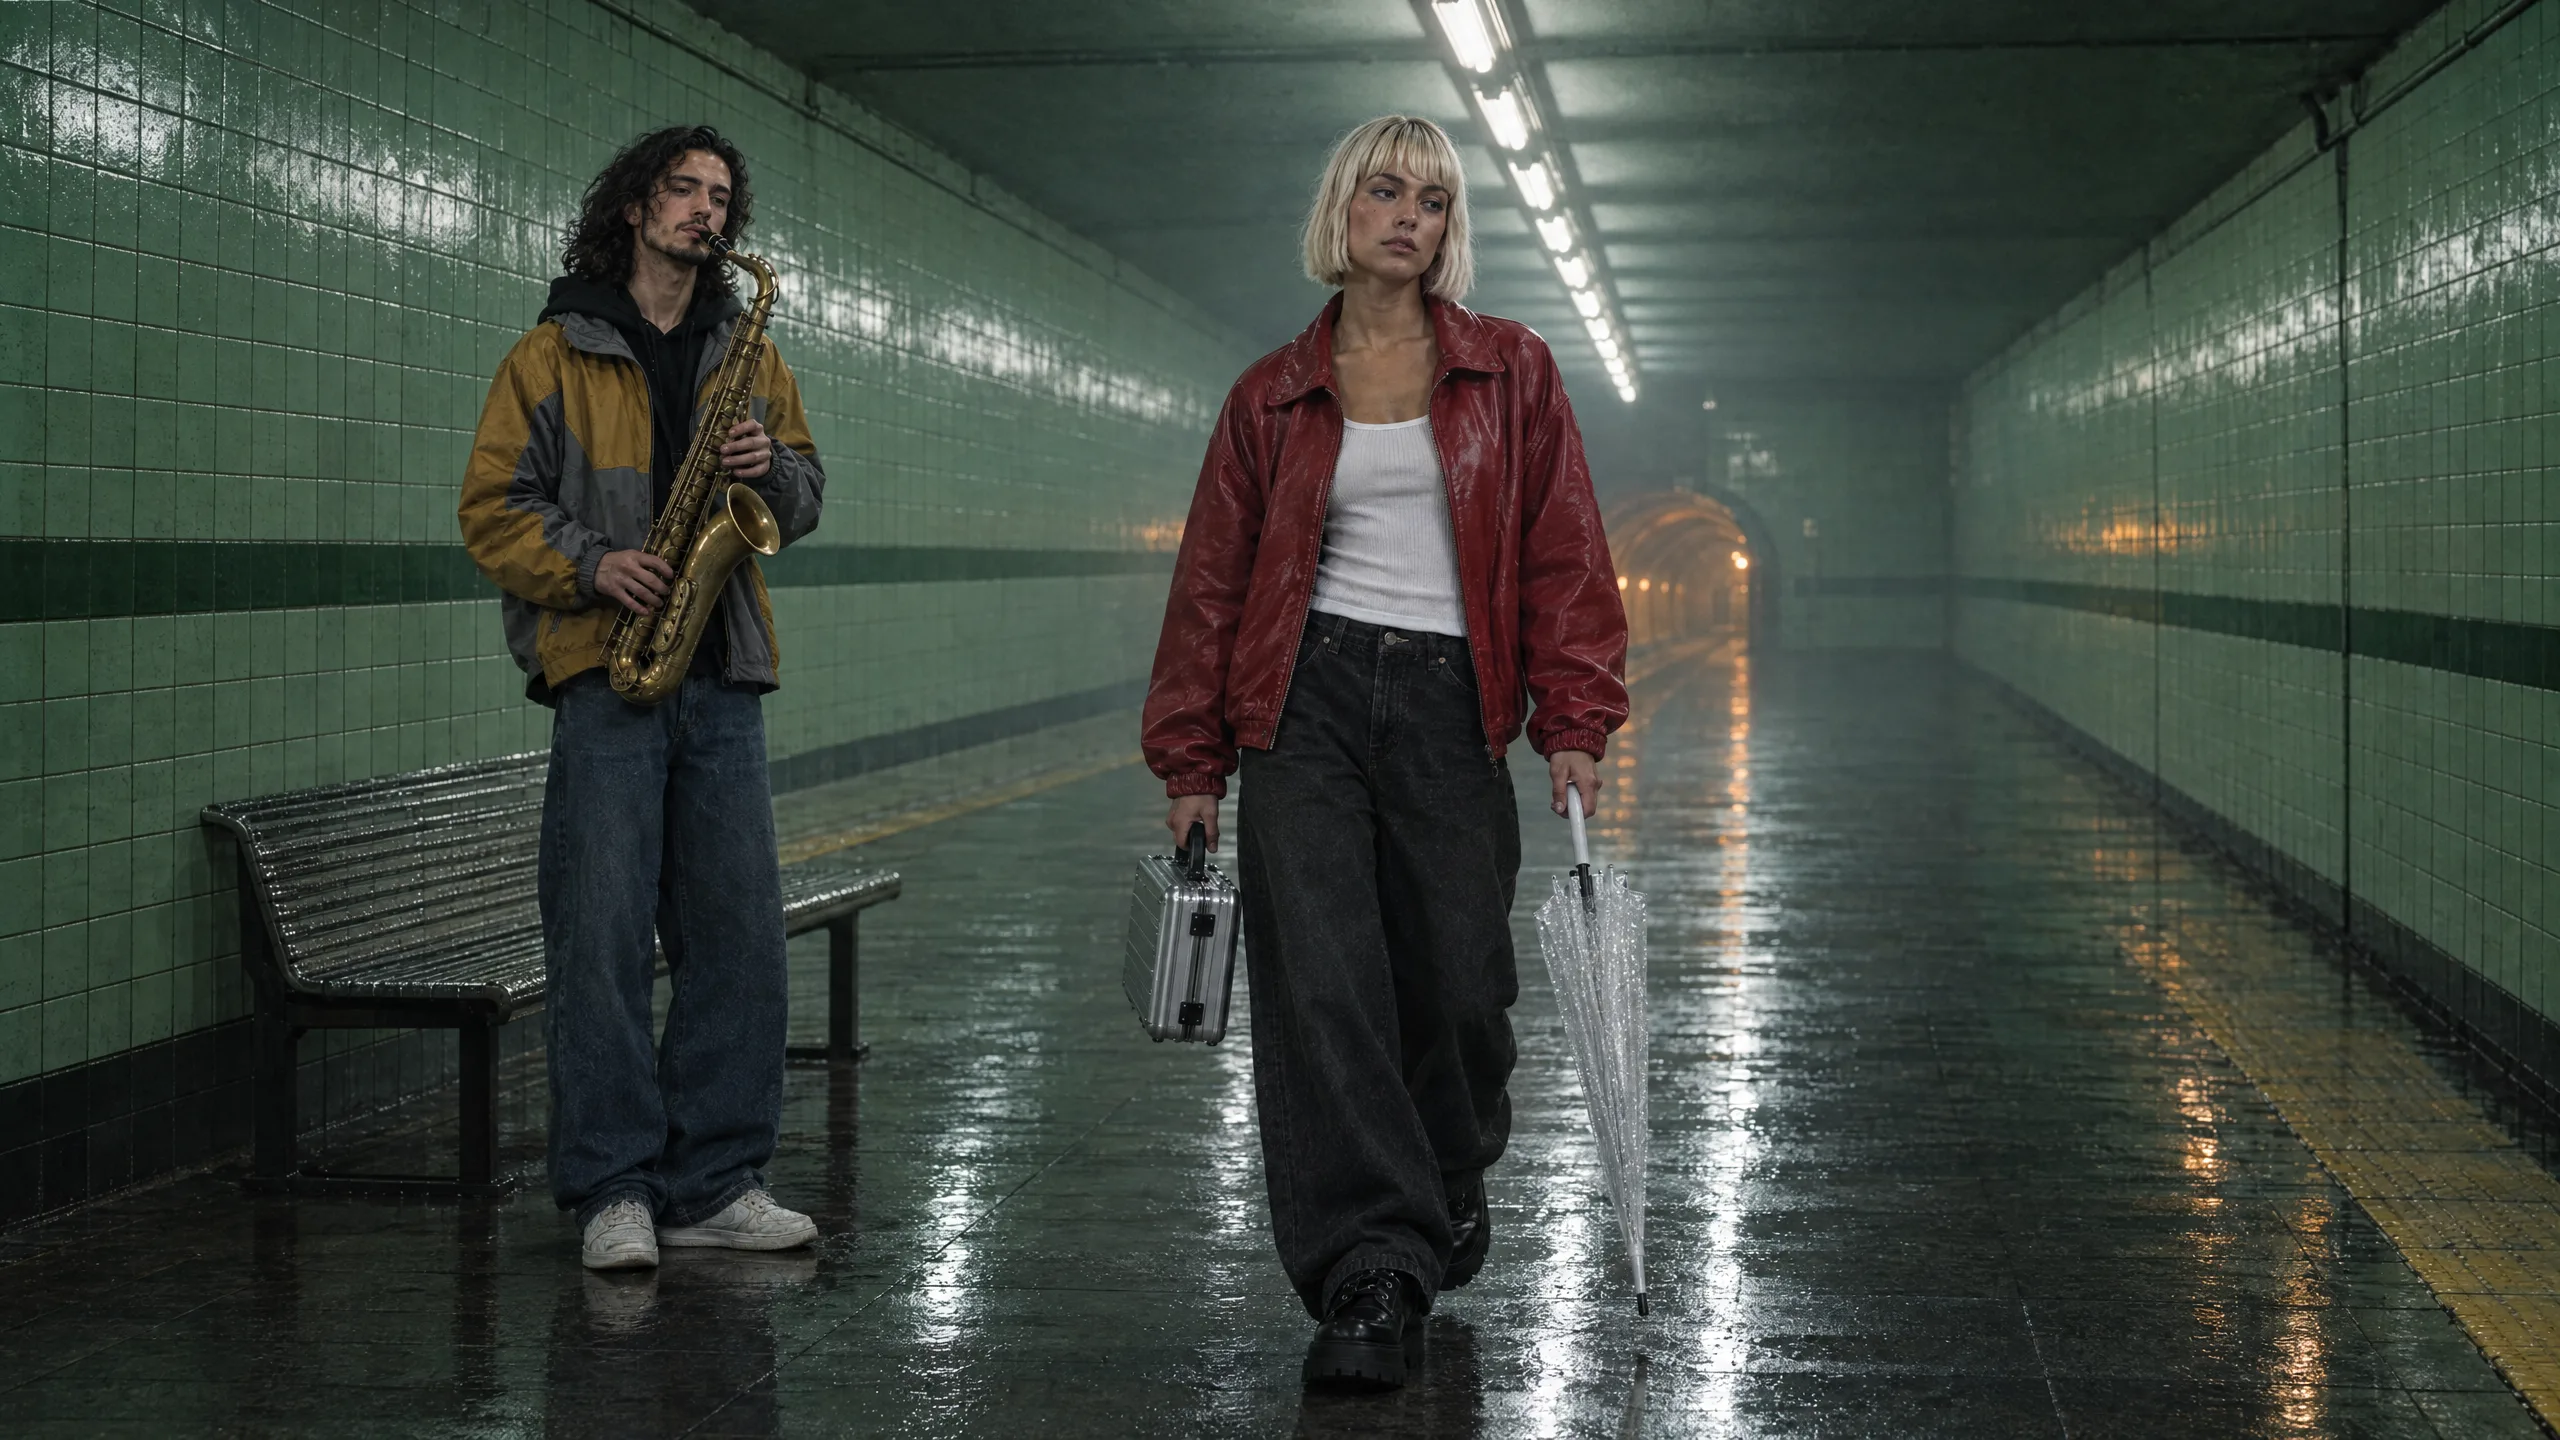
注意:反向情况:提示词从未提及的道具. 这种情况也会反过来发生。第 3 帧的提示词只提到了箱子,没提到雨伞,但雨伞还是出现了,因为 Vale 保存的描述里说她手里拿着一把。角色的描述会跟随它关联的每一个镜头。
保持稳定的部分:色调
场景也是一种颜色。我们以每秒两帧的频率测量了每个镜头的每一帧:计算落在场景的绿色色带、隧道的琥珀色色带以及夹克的红色色带中的饱和像素占比,以及平均亮度。地点的静帧是参考行。
| 镜头 | 绿色 | 琥珀色 | 夹克红 | 亮度 |
|---|---|---|---|---|
| 地点静帧(参考) | 69% | 1% | 0% | 0.26 |
| 1 奔跑 | 65% | 3% | 3% | 0.28 |
| 2 街头艺人 | 33% | 6% | 9% | 0.28 |
| 3 车门 | 19% | 12% | 8% | 0.25 |
| 4 插入镜头 | 37% | 17% | 0% | 0.35 |
| 5 长椅 | 45% | 13% | 11% | 0.28 |
最接近静帧的是这段连续镜头:一个沿站台延伸的广角镜头,画面大部分是墙壁。车门镜头的绿色最少,因为火车占据了画面右侧;而特写镜头最亮,因为火车的前灯从箱子后面的隧道中射出。这两种情况都不是色调漂移,而是镜头本身呈现的内容。
哪些没有保持一致,以及我们未作声明的内容
- 面部。 我们没有测量 Vale 的面部在不同镜头之间是否属于同一个人,因此本指南不声称这一点。上述统计涵盖的是服装、发型和道具。
- 缺少上下文的道具。 第一个镜头的第 2 帧中缺少箱子,因为该帧的提示词中没有包含关于它的描述。
- 来自描述的道具。 第 3 个镜头中出现了雨伞,尽管提示词中未提及,因为 Vale 的保存描述中将其握在手中。请围绕描述编写镜头,或明确说明每只手拿着什么。
- 每个镜头只拍一次。 这五个镜头都不需要重拍。但在另一次生成中,道具仍可能发生位移或淡入,因此请以全尺寸检查每个镜头。
哪种锚点适合哪种任务
成本是多少
保存角色或地点不花费任何积分。单帧按图片计费,镜头按模型和时长计费。这五个镜头所用模型的实时费率如下:
GPT Image 2.5 FlareEvery plan
Per image
Native 8 积分 · 2K 21 积分 · 4K 58 积分
Kling v3Pro and up
Per 5s clip (audio on by default)
720p 35 积分 · 1080p 47 积分 · 4K 117 积分
Seedance 2.5Pro and up
Per 5s clip
480p 26 积分 · 720p 56 积分 · 1080p 137 积分
1080p renders at 16:9 and 9:16
Seedream 5.0 ProEvery plan
Per image
1K 5 积分 · 2K 9 积分
页面加载时从目录实时读取。 所有价格都会在生成前显示。 查看所有费率.
检查清单
- 每个反复出现的角色对应一个条目,保存一张主参考图和一段描述。
- 每个地点对应一个条目,保存一张静帧和一句话。
- 每个道具对应一句话,出现在所有需要展示该道具的提示词中。
- 以 16:9 比例生成帧,并关联演员阵容和地点;从这些帧生成动画镜头。
- 在剪辑前以全尺寸对照清单检查每个镜头;发现遗漏只需重做一条提示词,无需重做整部影片。
常见问题
- 从镜头到镜头,是否是同一个人的脸?
- 我们尚未对此进行测量,因此不作断言。我们测量过并确认稳定的是服装、发型、道具和场景。
- 角色如何保持服装一致?
- 它的主要参考照片会作为参考图像随每个附加的提示词一起发送,而它的描述则以文字形式包含在内。两者都描述了同样的夹克、靴子和波波头,模型会据此进行渲染。描述还能带来提示词未要求的内容:第 3 个镜头中的雨伞就来自描述。
- 为什么手提箱在某个镜头中消失了?
- 因为该镜头的提示词中没有包含关于它的句子。道具的一致性完全取决于每个提示词中描述它的文字,因此请将相同的句子粘贴到每个提示词中;包含该句子的第二个版本镜头中就有手提箱。
- 地点仍然必须是一张照片吗?
- 不必。我们使用的是由 Seedream 5.0 Pro 生成的静态图像。任何该地点的静态图像,无论是上传的还是生成的,都可以作为地点的参考。
- 我能直接将角色附加到视频模型吗?
- 在我们测试的模型中,效果不佳:Seedance 2.0 Fast 拒绝使用她的参考图,Seedance 1.5 Pro 无法携带参考图,而 Seedance 2.5 虽然接受了参考图,却自行构建了平台。使用图像合成器生成附加了地点的 16:9 画面,然后使用“图像动画化”功能,可以同时保留两者。
- 调色板是如何测量的?
- 每秒两帧,对每个镜头中三个色相带的饱和像素占比取平均值,并与该地点静帧的相同指标进行对比。
一次保存演员阵容和场景
打开角色相关教程
影视制作
用 AI 制作短片:从剧本到最终剪辑的流程
一部 25 秒的短片《末班车》,从五行剧本到调色完成的剪辑:一个保存的角色、一个保存的地点、一个道具,先做帧,再做镜头、声音、Studio,最后导出到 Premiere 或 Resolve。
· 13 分钟阅读
视频剪辑
把你的人物和你的狗放进任何视频
选择一个视频,添加一张人物照片和一张狗的照片,Miroge 就会用它们重新演绎这个片段:动作不变,场景不变,镜头不变。电脑和手机都能操作。
· 10 分钟阅读
影视制作
NOLGIA 代劳 DIT:复制、校验并命名你的相机存储卡
将相机存储卡复制到两个驱动器,逐一校验副本与原始卡是否一致,并生成 ASC MHL 清单、DIT 报告和命名文件。免费,在你的本地电脑上运行。
· 8 分钟阅读