

讓角色和地點在不同鏡頭間保持一致
在 NOLGIA 上保持一致性有兩個關鍵:參考圖片,以及每次使用相同的文字。本指南檢視《Last Train》的五個鏡頭,確認哪些元素保持不變:服裝、道具、場景與色調。我們會進行統計。我們不會宣稱面孔屬於同一個人,因為我們尚未對此進行測量。
- 閱讀時間 11 分鐘
本文由英文自動翻譯。閱讀原文
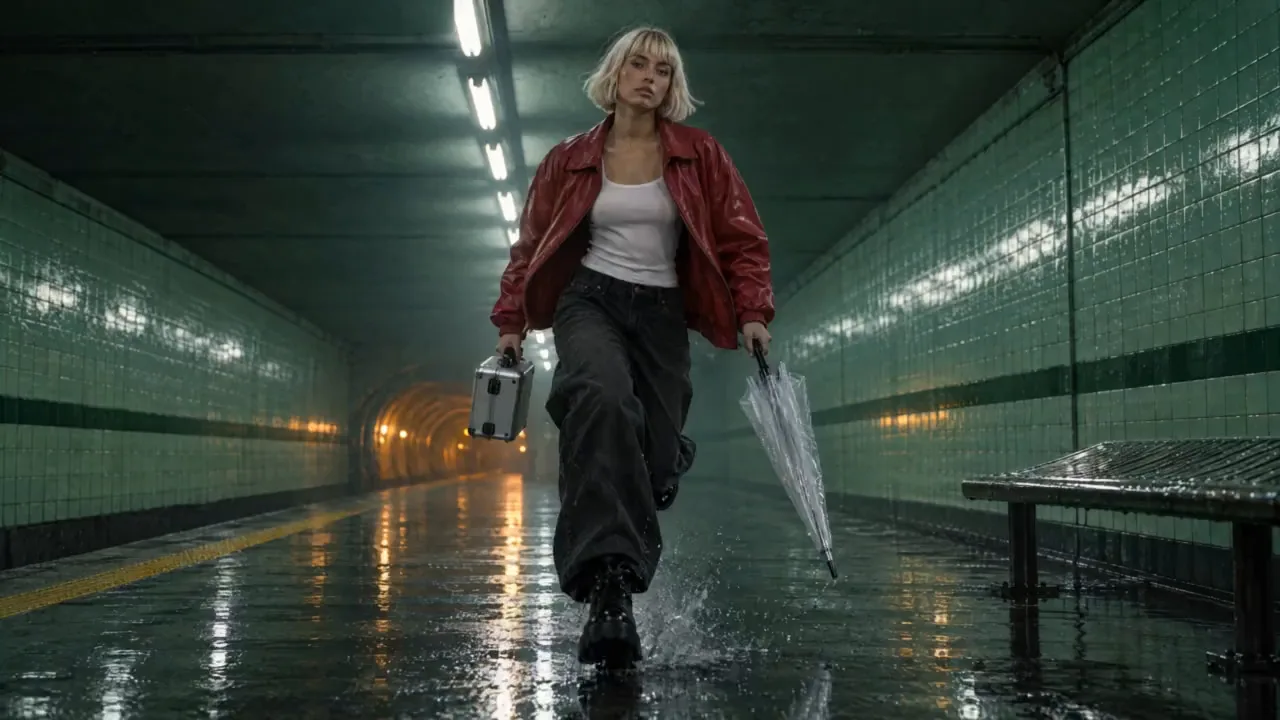
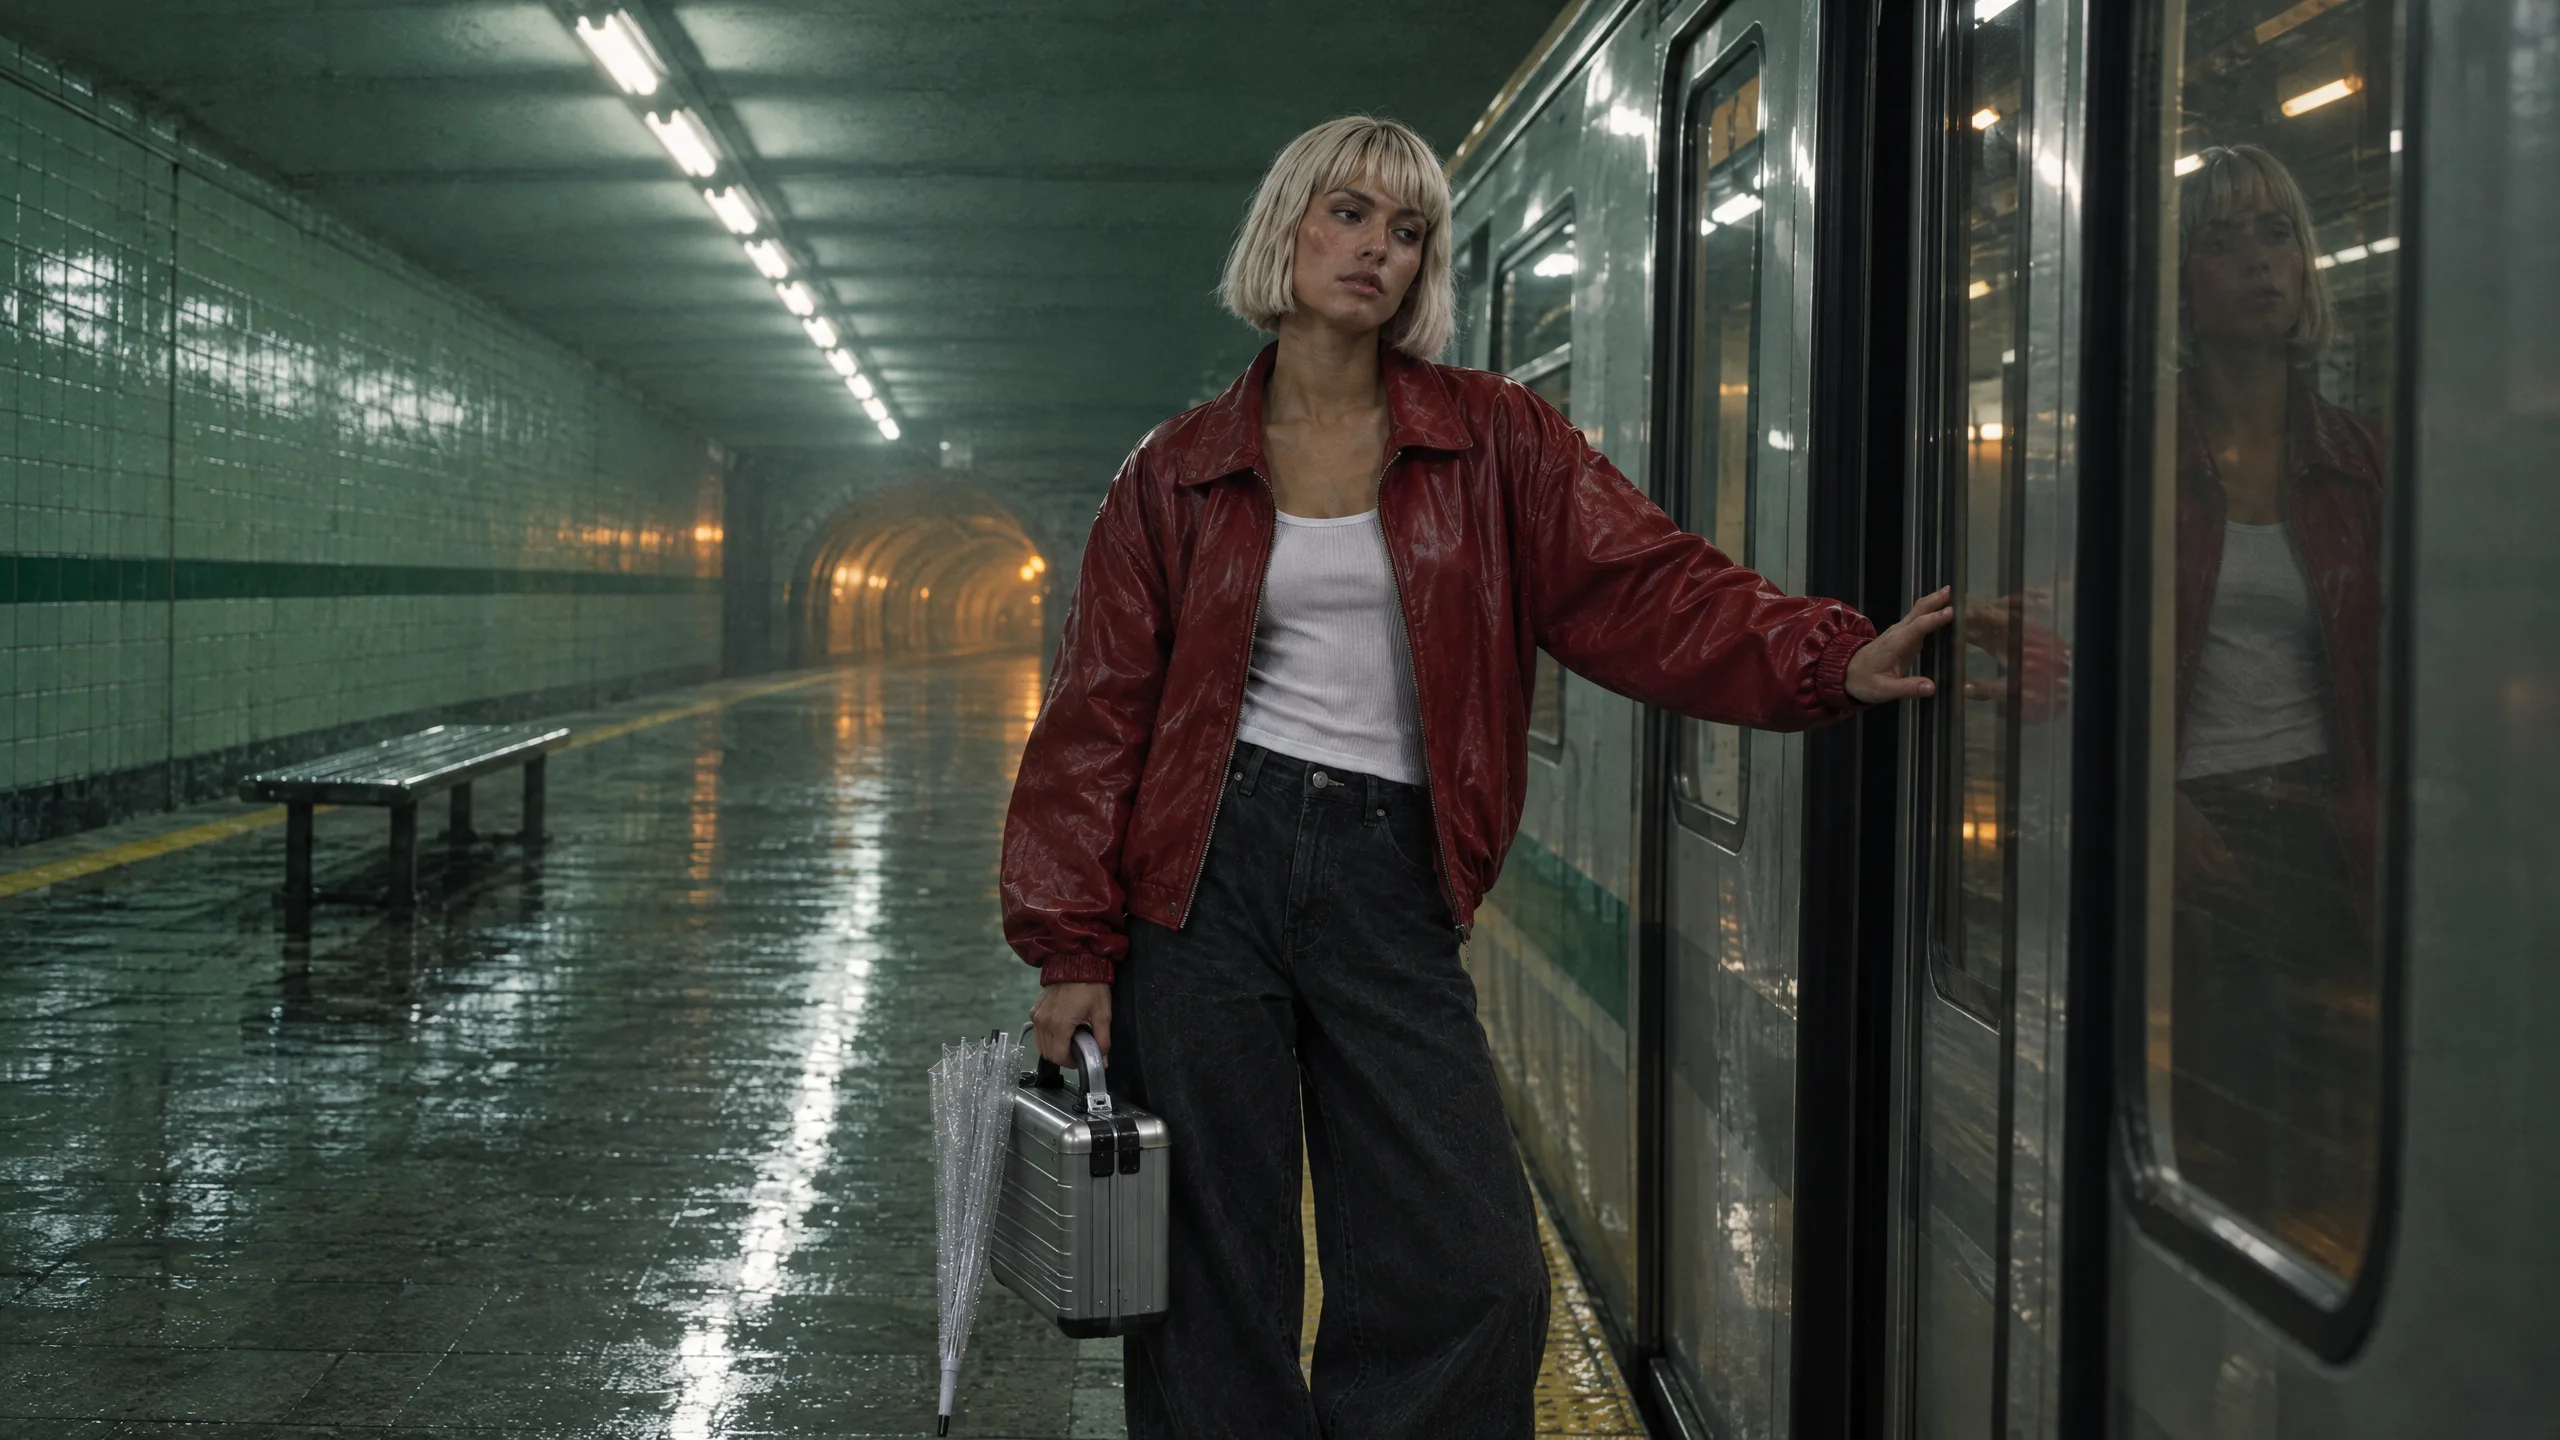
本指南中的鏡頭來自 Last Train,這是一部為這些指南製作、時長 25 秒的影片,發布於公司官方帳號。Vale 是一個儲存的虛擬角色,Halcyon Street 車站是一個儲存的地點,鉻金屬手提箱則是一張靜態圖與一句描述。每個鏡頭都在影像合成器中以 16:9 比例製作,並附加了該角色與地點,接著在影片合成器中進行動畫處理。片中所有人物皆為虛構。
接著,我們用清單和捲尺逐一檢查鏡頭:每個鏡頭中出現哪些服裝、哪些道具和哪些佈景部分,以及畫面中有多少比例是佈景的綠色、隧道的琥珀色和夾克的紅色。以下是統計結果,包括兩個出錯的地方。
常見錯誤
| 錯誤 | 失敗原因 | 修正 |
|---|---|---|
| 在每個提示詞中重新描述角色 | 每個提示詞都是獨立的要求;外套可能變成夾克,短髮可能變成馬尾 | 使用參考圖片和一段描述儲存角色,附加該角色,並輸入 @Name |
| 只在一个鏡頭中描述地點,然後就假設它會保持一致 | 模型每次都會創造一個新的月台 | 使用一張靜態圖片和一句話儲存地點;將其附加到每個鏡頭 |
| 在某个提示詞中漏掉道具 | 無論上一個鏡頭顯示了什麼,該道具在該鏡頭中都會消失 | 為每個道具寫一句話,並貼到應該出現該道具的每個提示詞中 |
| 直接將角色傳送到影片模型 | 一個模型拒絕寫實參考圖,另一個無法處理參考圖,而接受參考圖的模型則會自行創造佈景 | 先使用附加的演員陣容製作 16:9 畫面,然後再進行動畫製作 |
| 信任良好的第一秒 | 隨著片段播放,佈景會重複,道具會移動 | 將鏡頭保持在 4 到 6 秒,並在出現偏差時進行剪輯 |
這裡的錨點是什麼
NOLGIA 沒有經過訓練的身份模型。這裡有三種錨點,本指南會全部使用:
- 一個角色,來自 角色 頁面:最多八張參考照片(包含一張主要照片),以及一段會自動附加到每個相關提示詞的描述。在任一編輯器中的 角色 下選取它,並在提示詞中輸入 @Vale。編輯器會將主要照片放入參考欄位,並將 @Vale 重寫為該欄位。
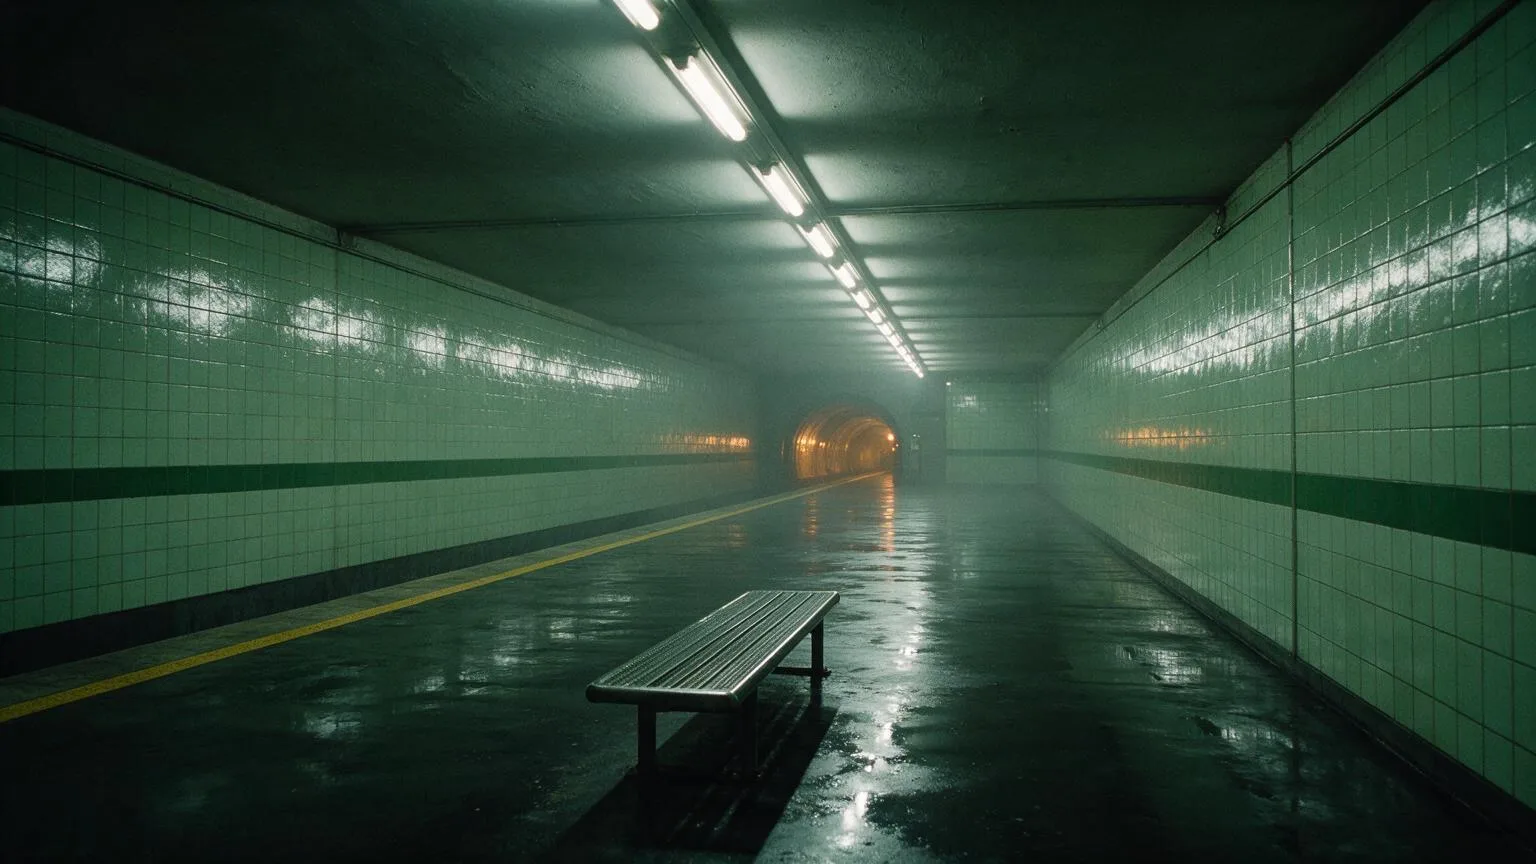
- 一個地點,來自 地點 頁面:一張靜態圖像和一段標準描述。在 地點 下選取它,靜態圖像會與該句子一起作為參考資料。
- 一個句子,用於其他任何內容。例如,鉻合金外殼的案例就是一句話,直接複製貼上到每個相關的提示詞中,並搭配一張專屬的靜態圖像作為插入畫面的參考圖片。
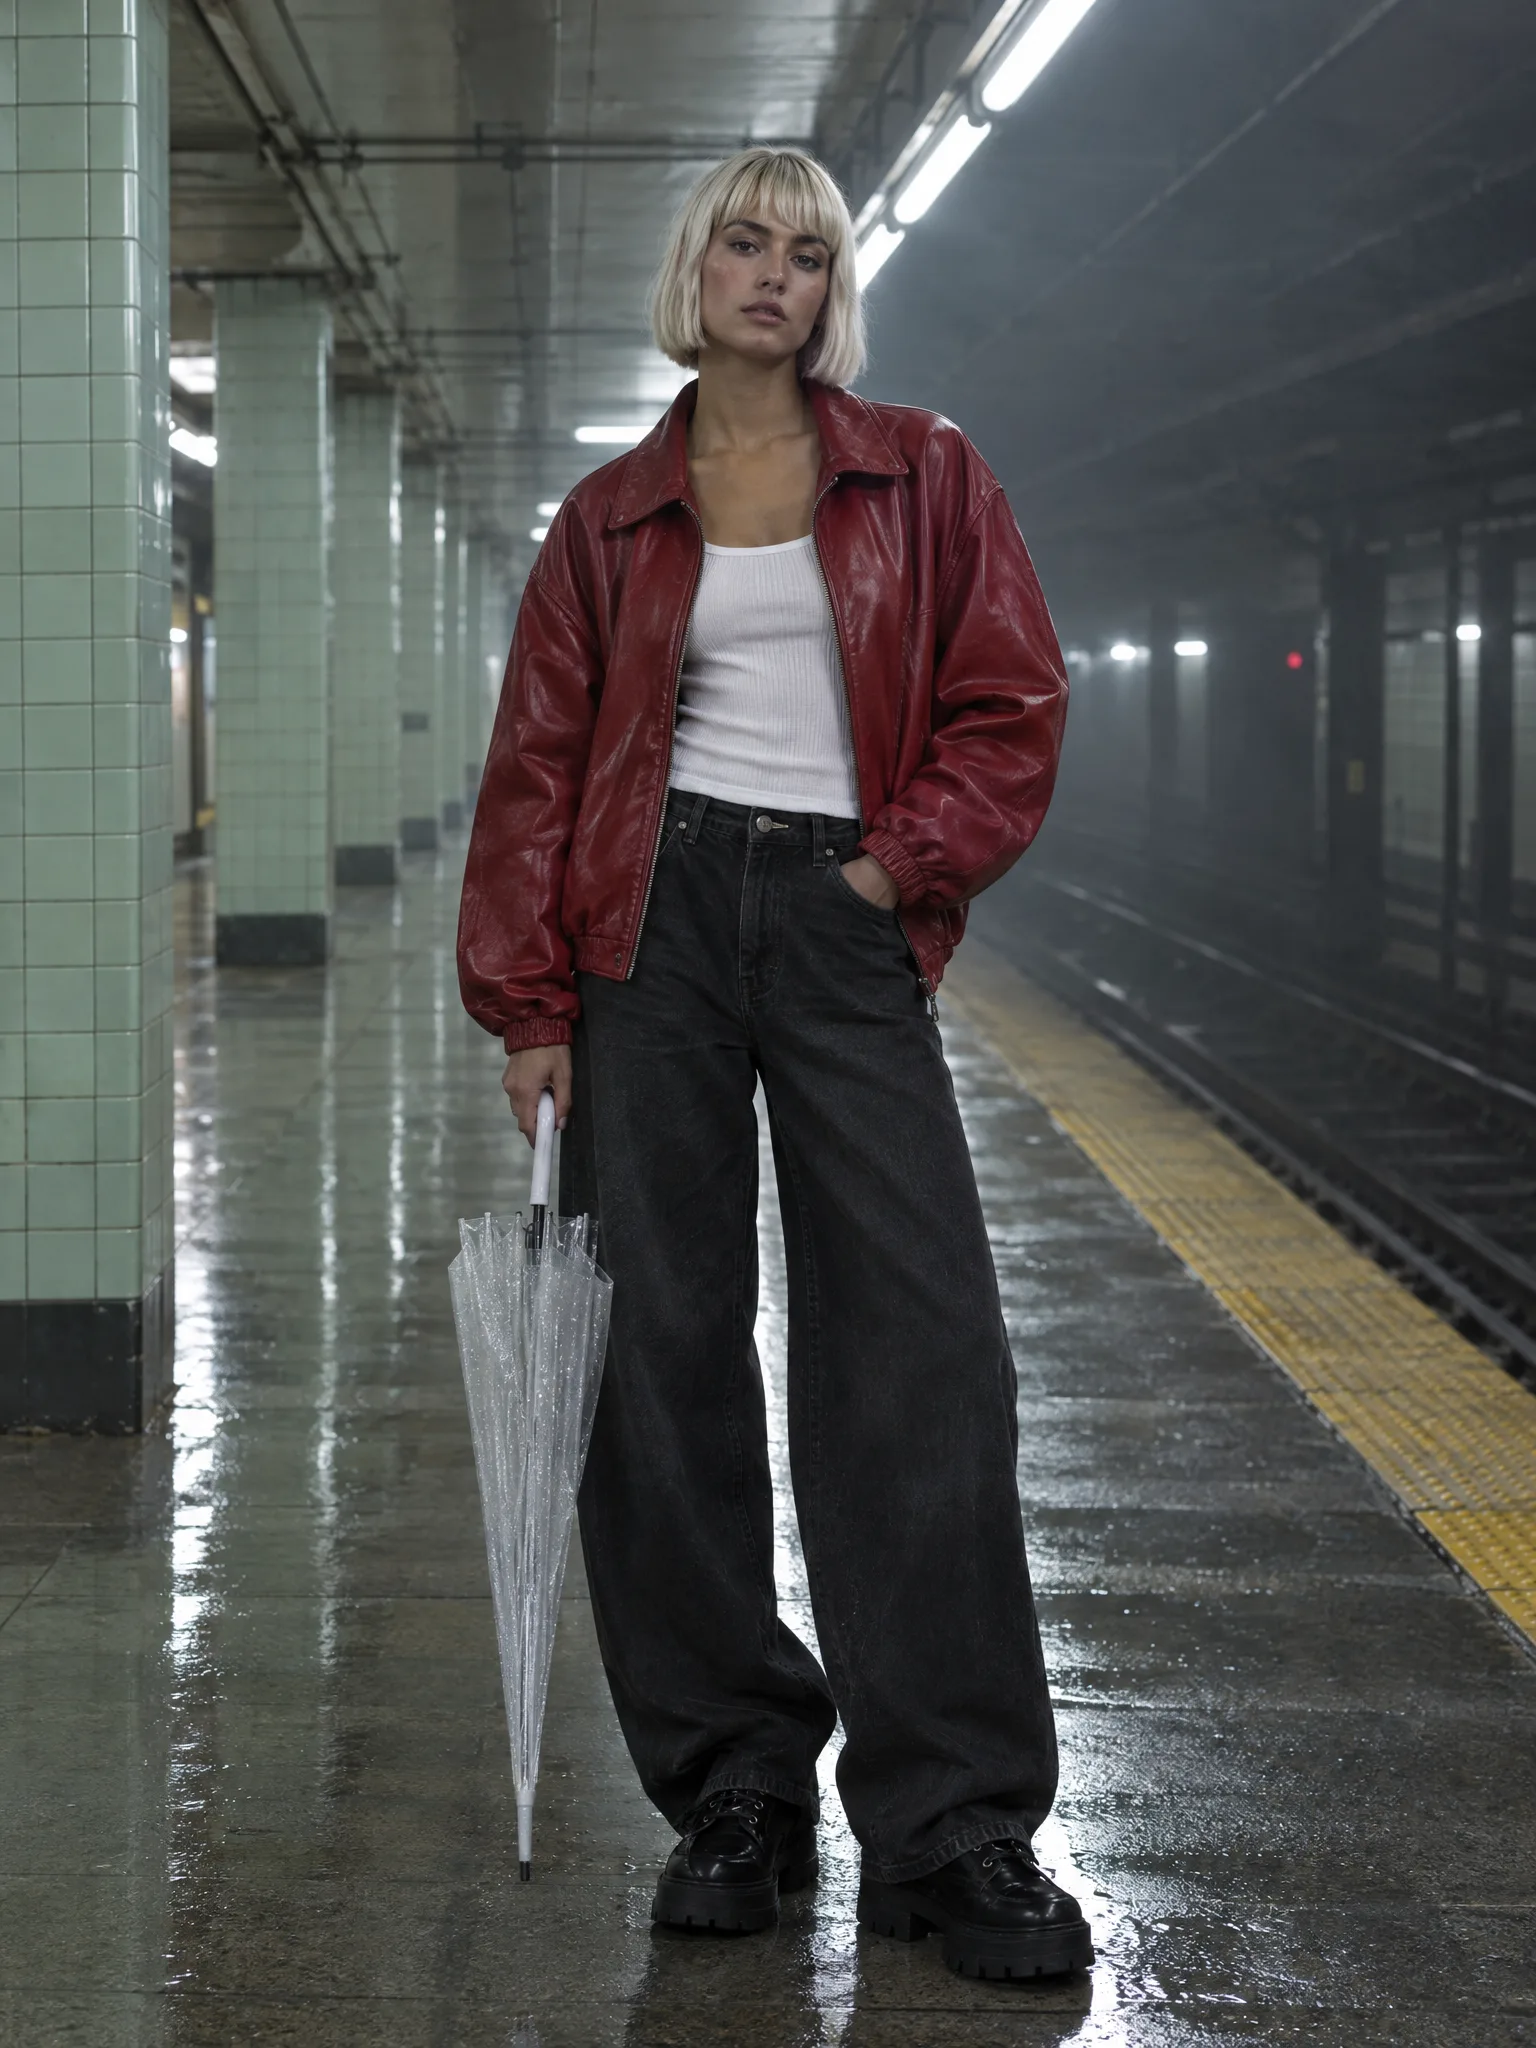
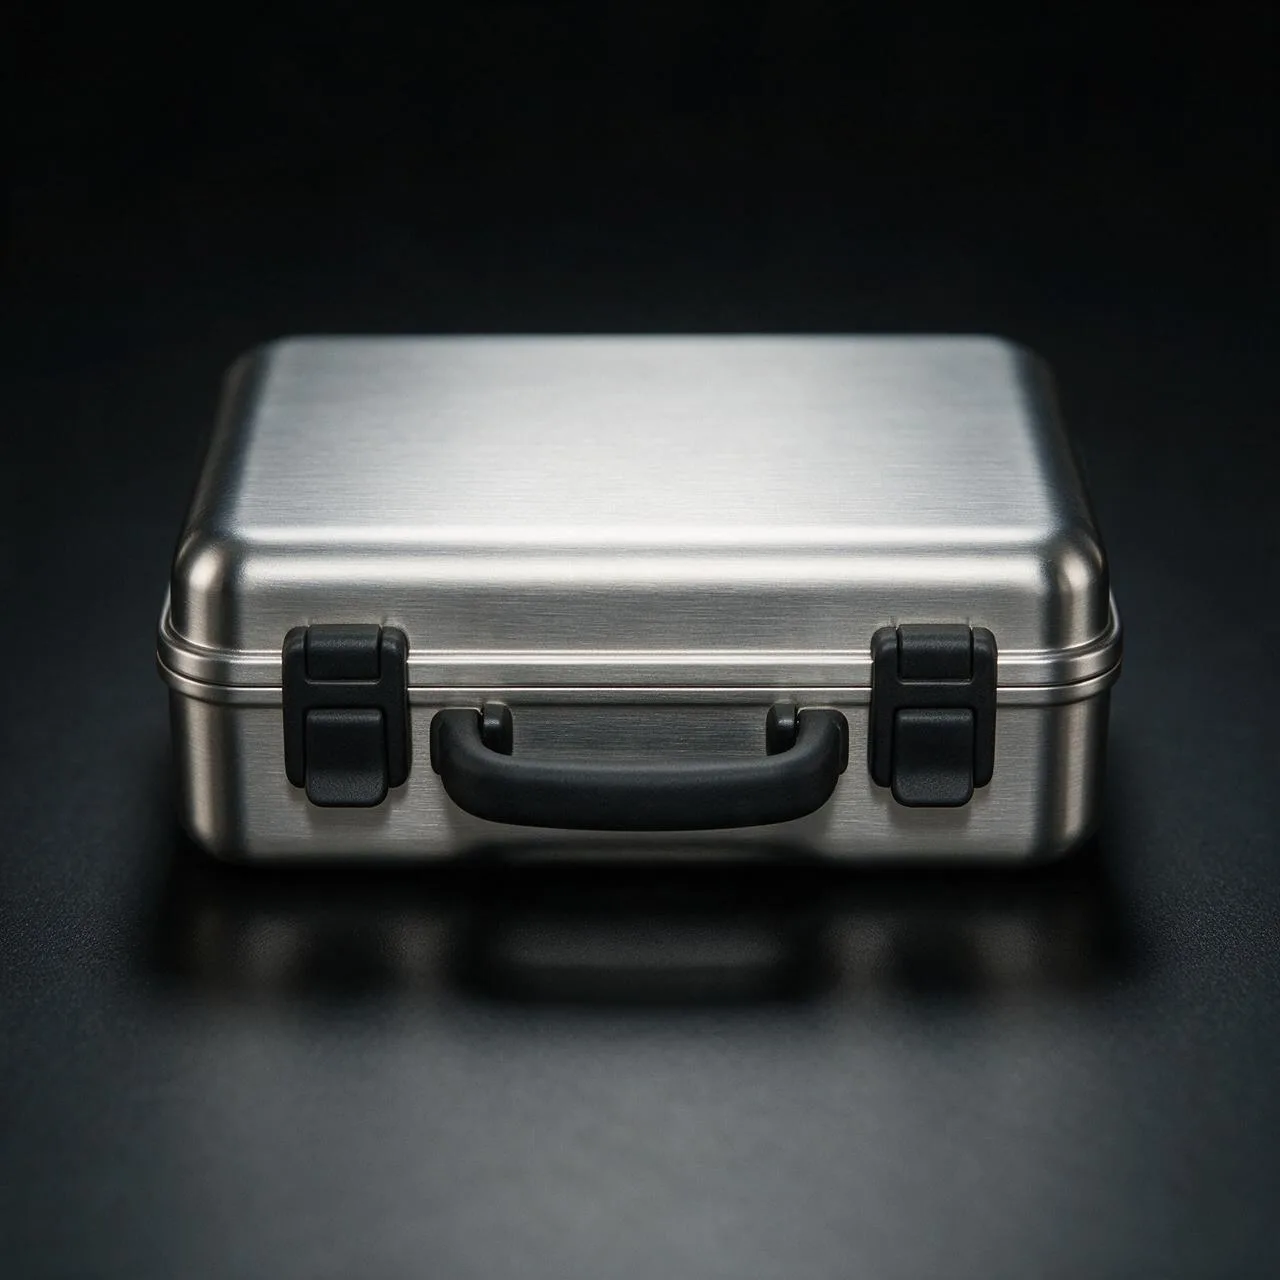
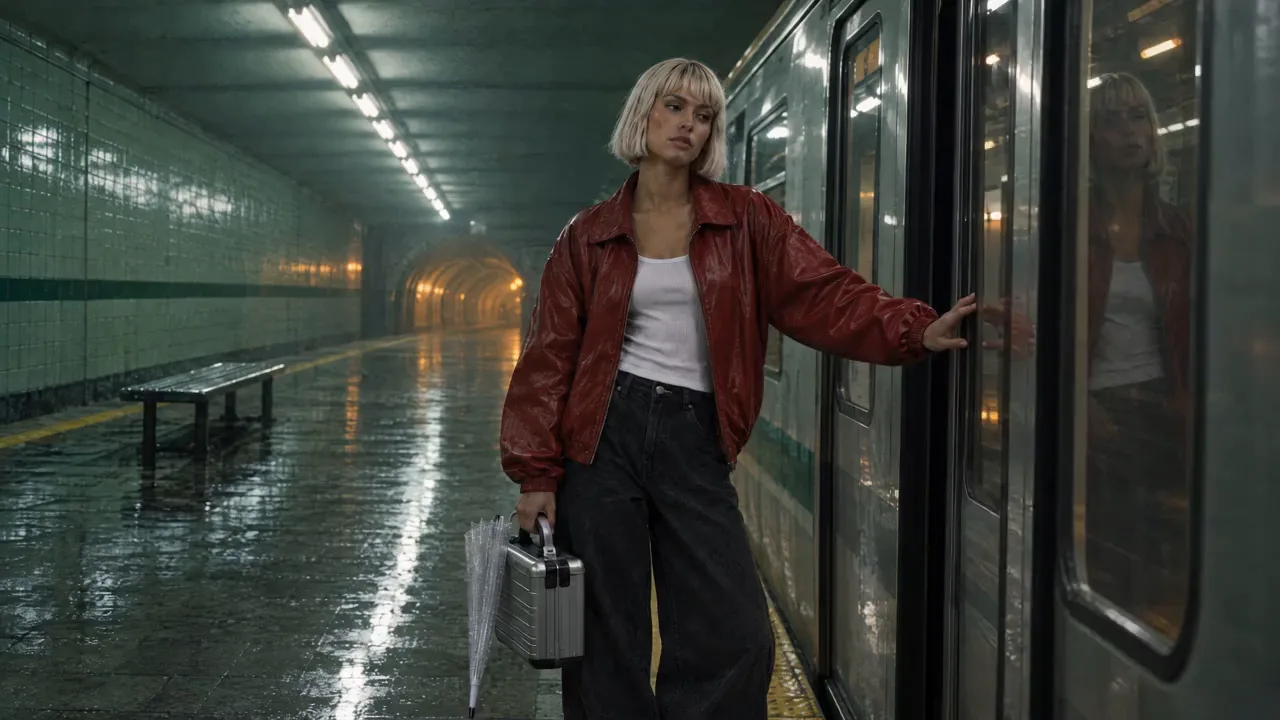
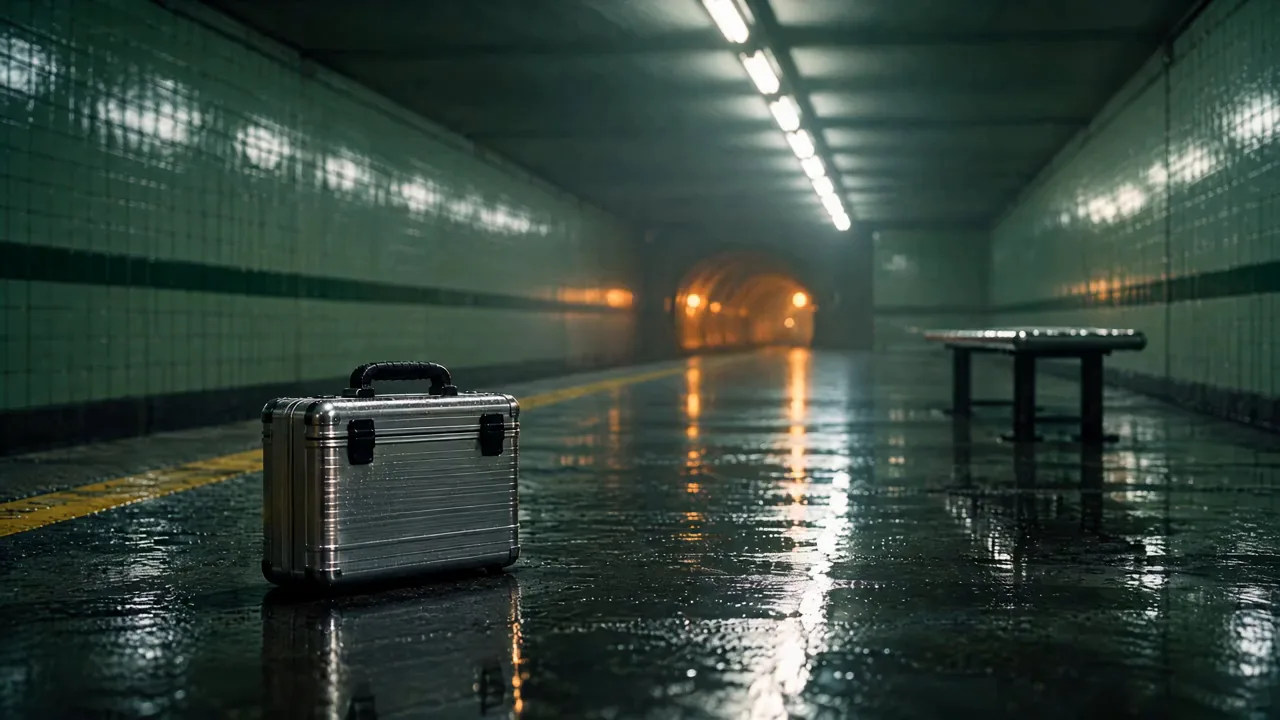
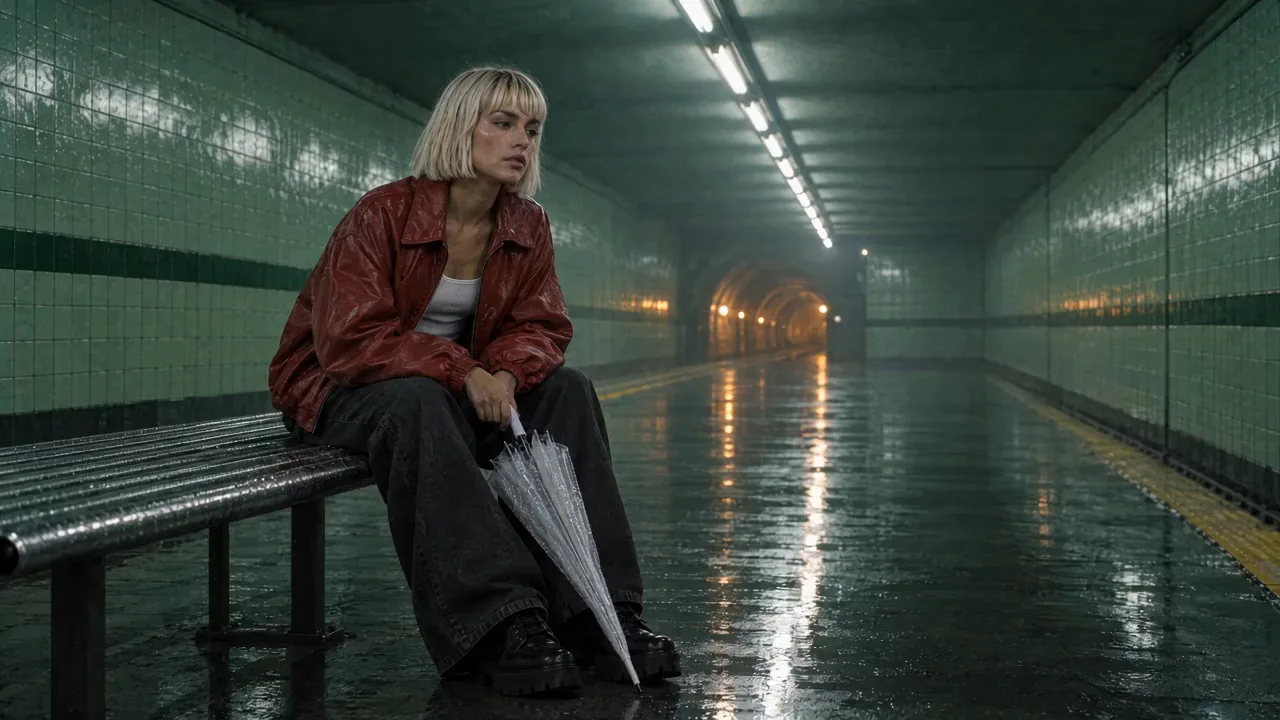
The lead of Last Train: a woman in her early twenties with a platinum blonde sleek chin-length bob and a straight fringe, an oversized cherry-red leather bomber jacket over a white ribbed tank, wide black jeans, chunky black platform lace-up boots, a folded transparent bubble umbrella in one hand.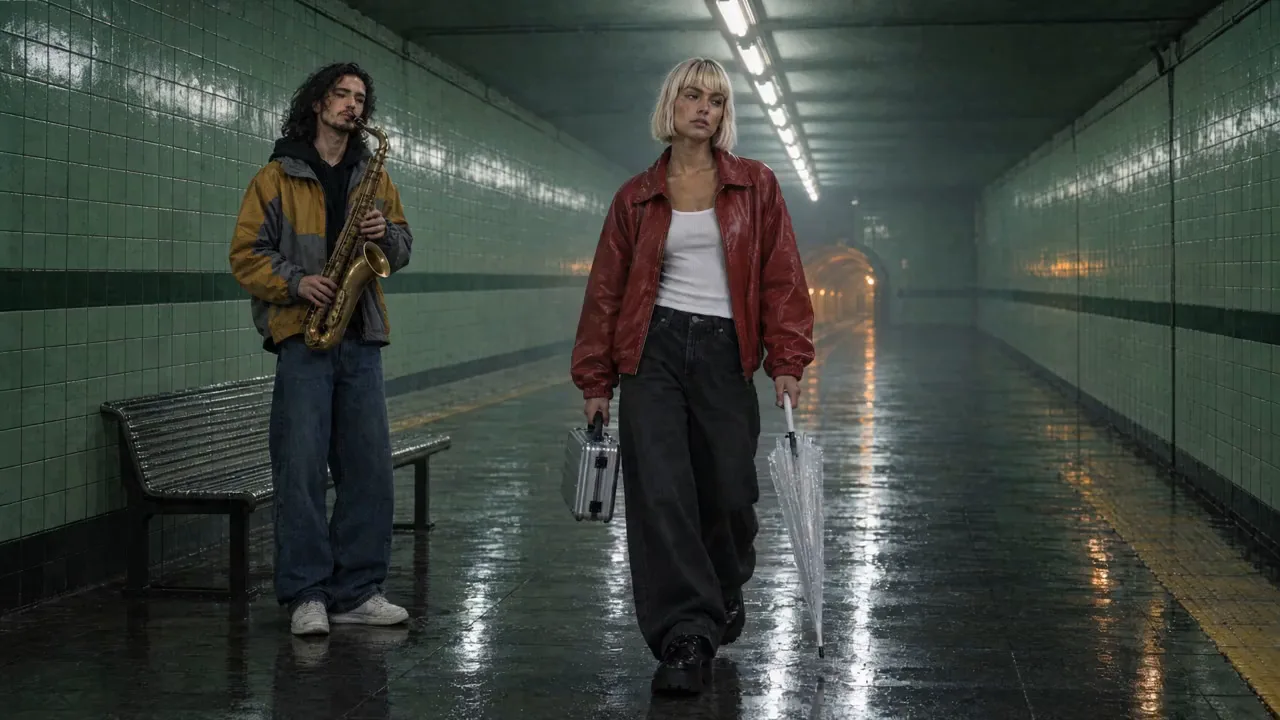
保持一致的內容:服裝、道具與場景,逐鏡頭檢視
我們以每秒兩格的速率檢視每個鏡頭,並核對清單:五件服裝(櫻桃紅皮革飛行夾克、白色羅紋背心、寬版黑色牛仔褲、黑色厚底靴、白金色短髮)、兩件道具(透明雨傘、鍍鉻行李箱),以及六個場景元素(淡綠色瓷磚、深綠色條紋、日光燈管、鋼製長椅、黃色標線、琥珀色隧道口)。
| 鏡頭 | 服裝 | 雨傘 | 行李箱 | 場景 |
|---|---|---|---|---|
| 1 奔跑 | 5/5,夾克敞開 | 是 | 是 | 6/6 |
| 2 街頭藝人 | 5/5,加上 Ozzy 的防風外套、連帽衫與薩克斯風 | 是 | 是 | 6/6 |
| 3 車門 | 4/5:靴子未入鏡 | 是,但此提示詞中未包含 | 是 | 6/6,加上火車 |
| 4 插入鏡頭 | 無人 | 否 | 是,來自第一幀的靜止畫面 | 6/6,加上火車 |
| 5 長椅 | 5 之 5 | 是 | 否:在第 4 個鏡頭中放下 | 6/6 |
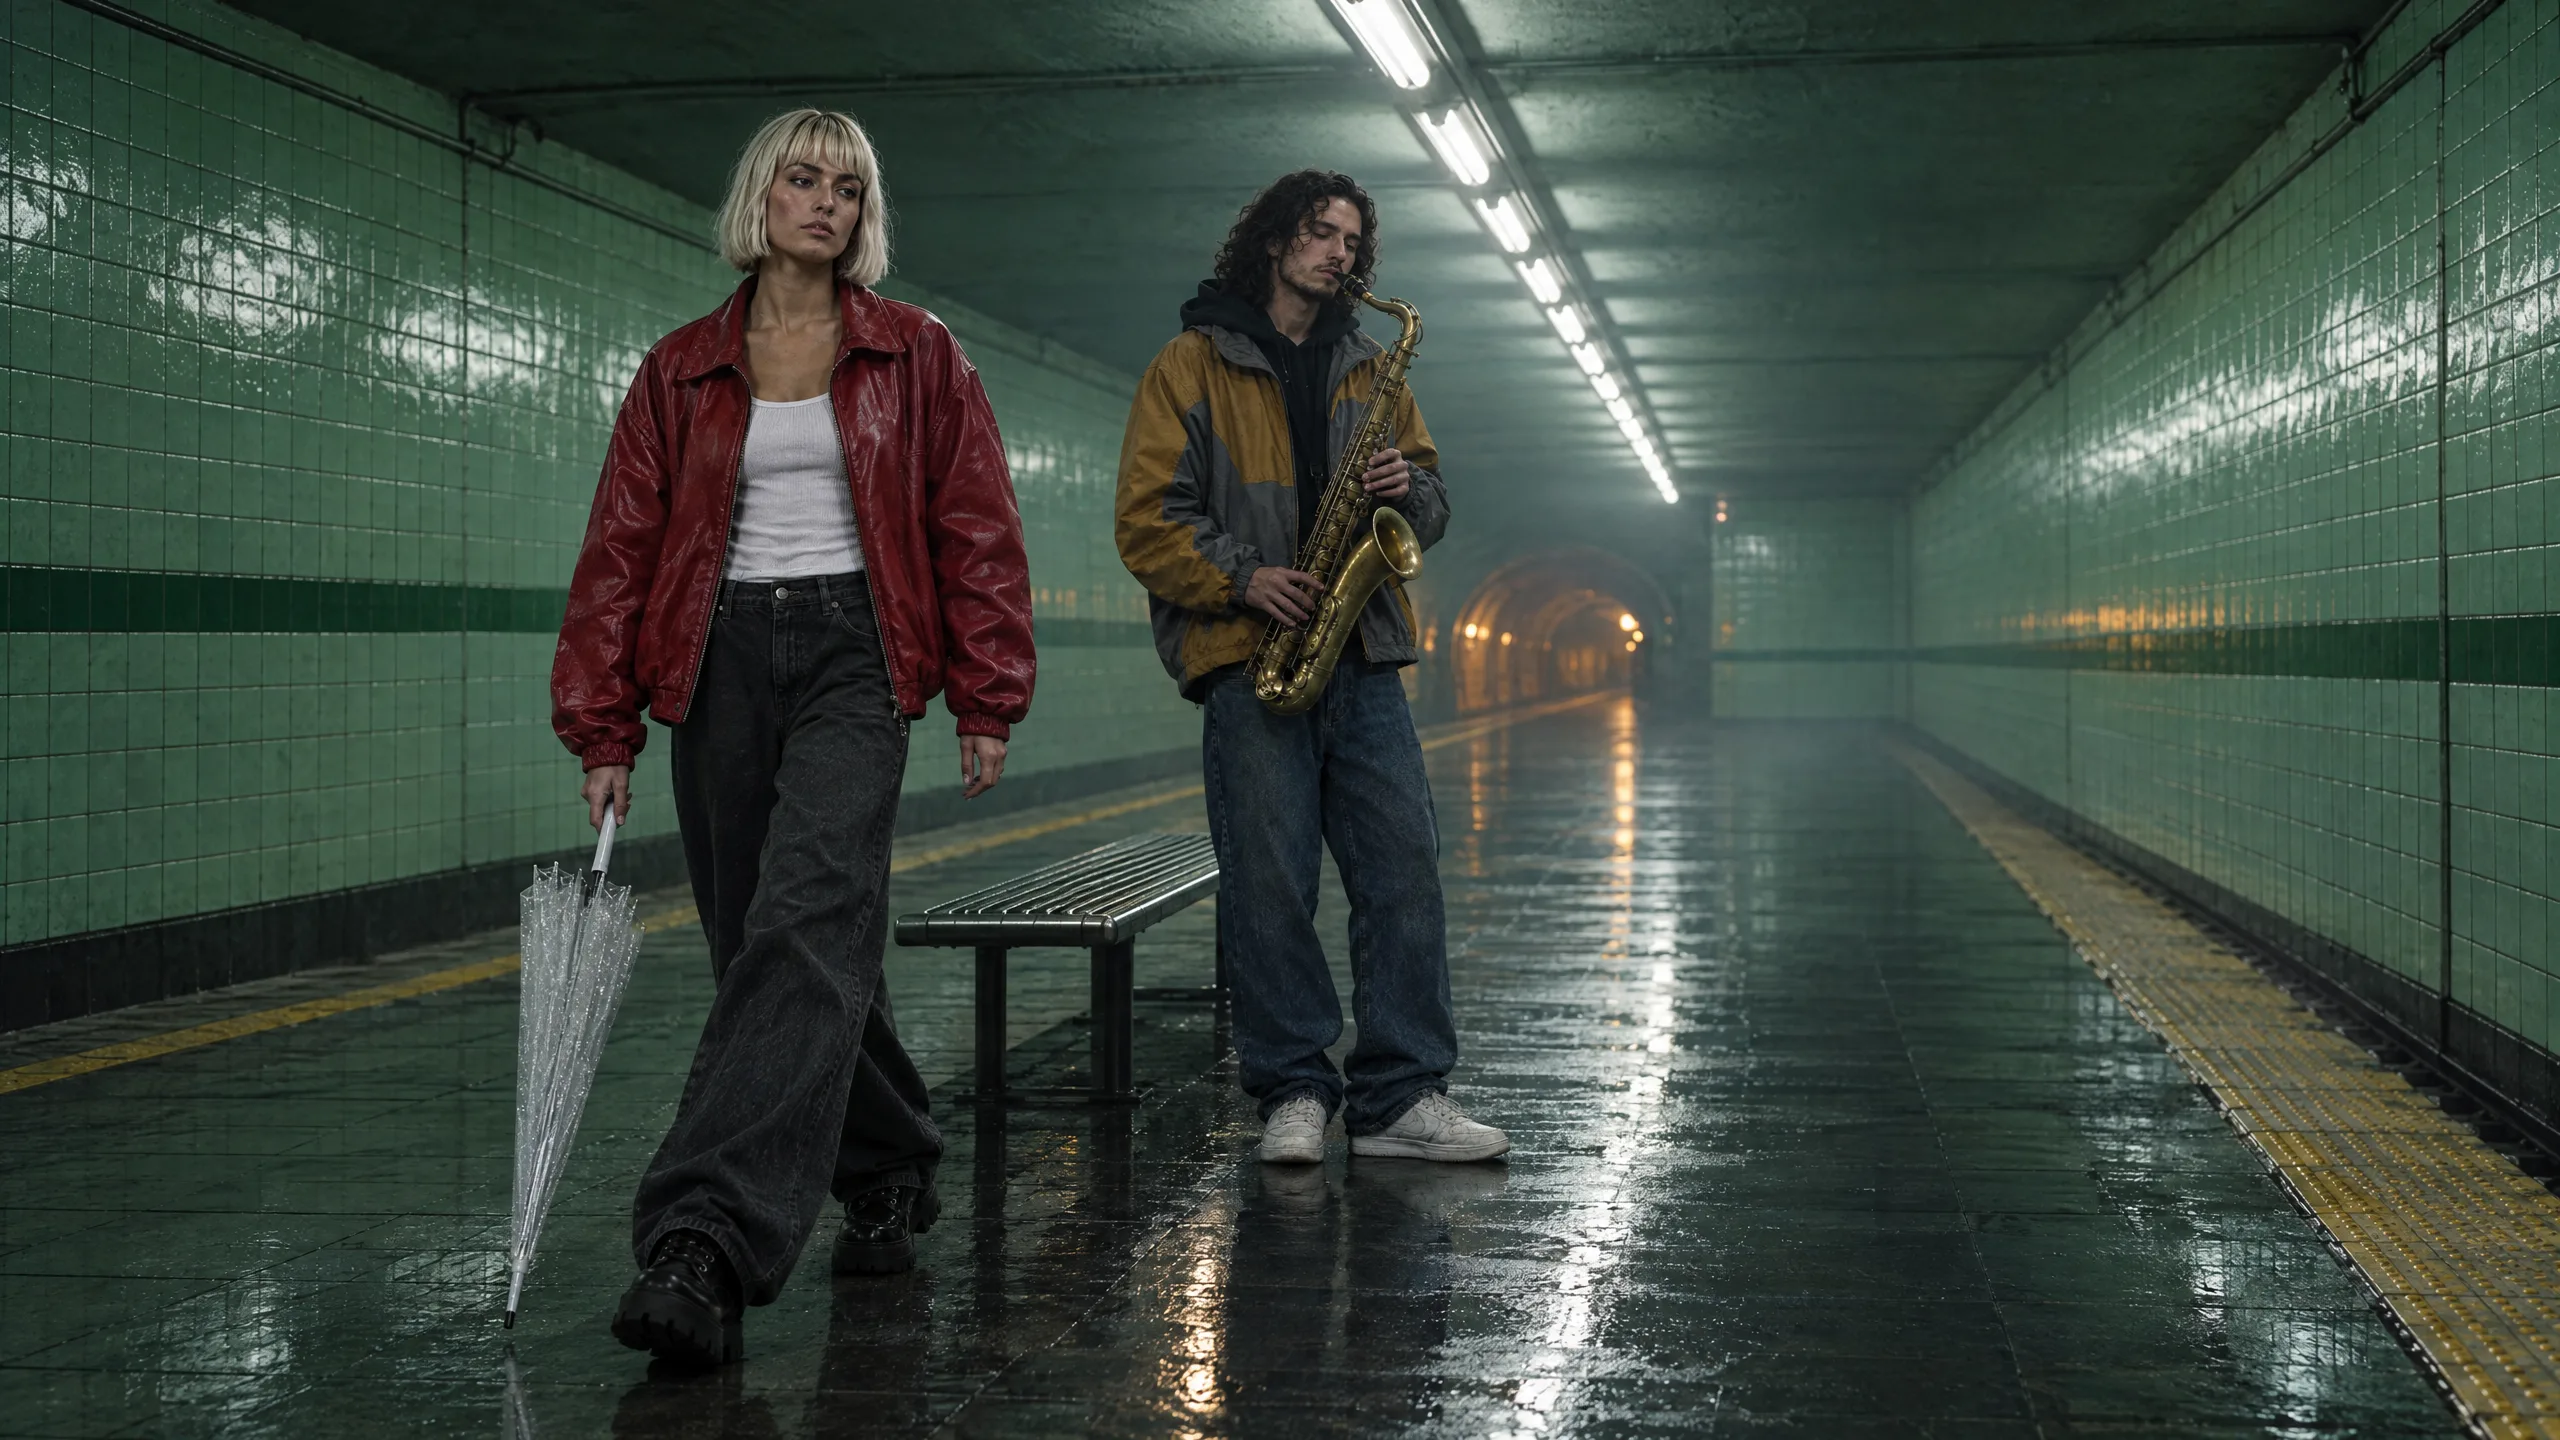
注意:差距:手提箱從第一幀 2 中消失. 我們第一版的第一幀 2 提到了 Ozzy、長椅、薩克斯風和雨傘,但沒有提到手提箱。因此它沒有手提箱,儘管她在第一幀和第三幀中都有攜帶。沒有任何東西會自動幫你保留道具。修復方法很無聊:將關於手提箱的那句話加入提示詞,然後重新生成該幀。
第一版:漏掉的那句話
第二版:提示詞中的那句話
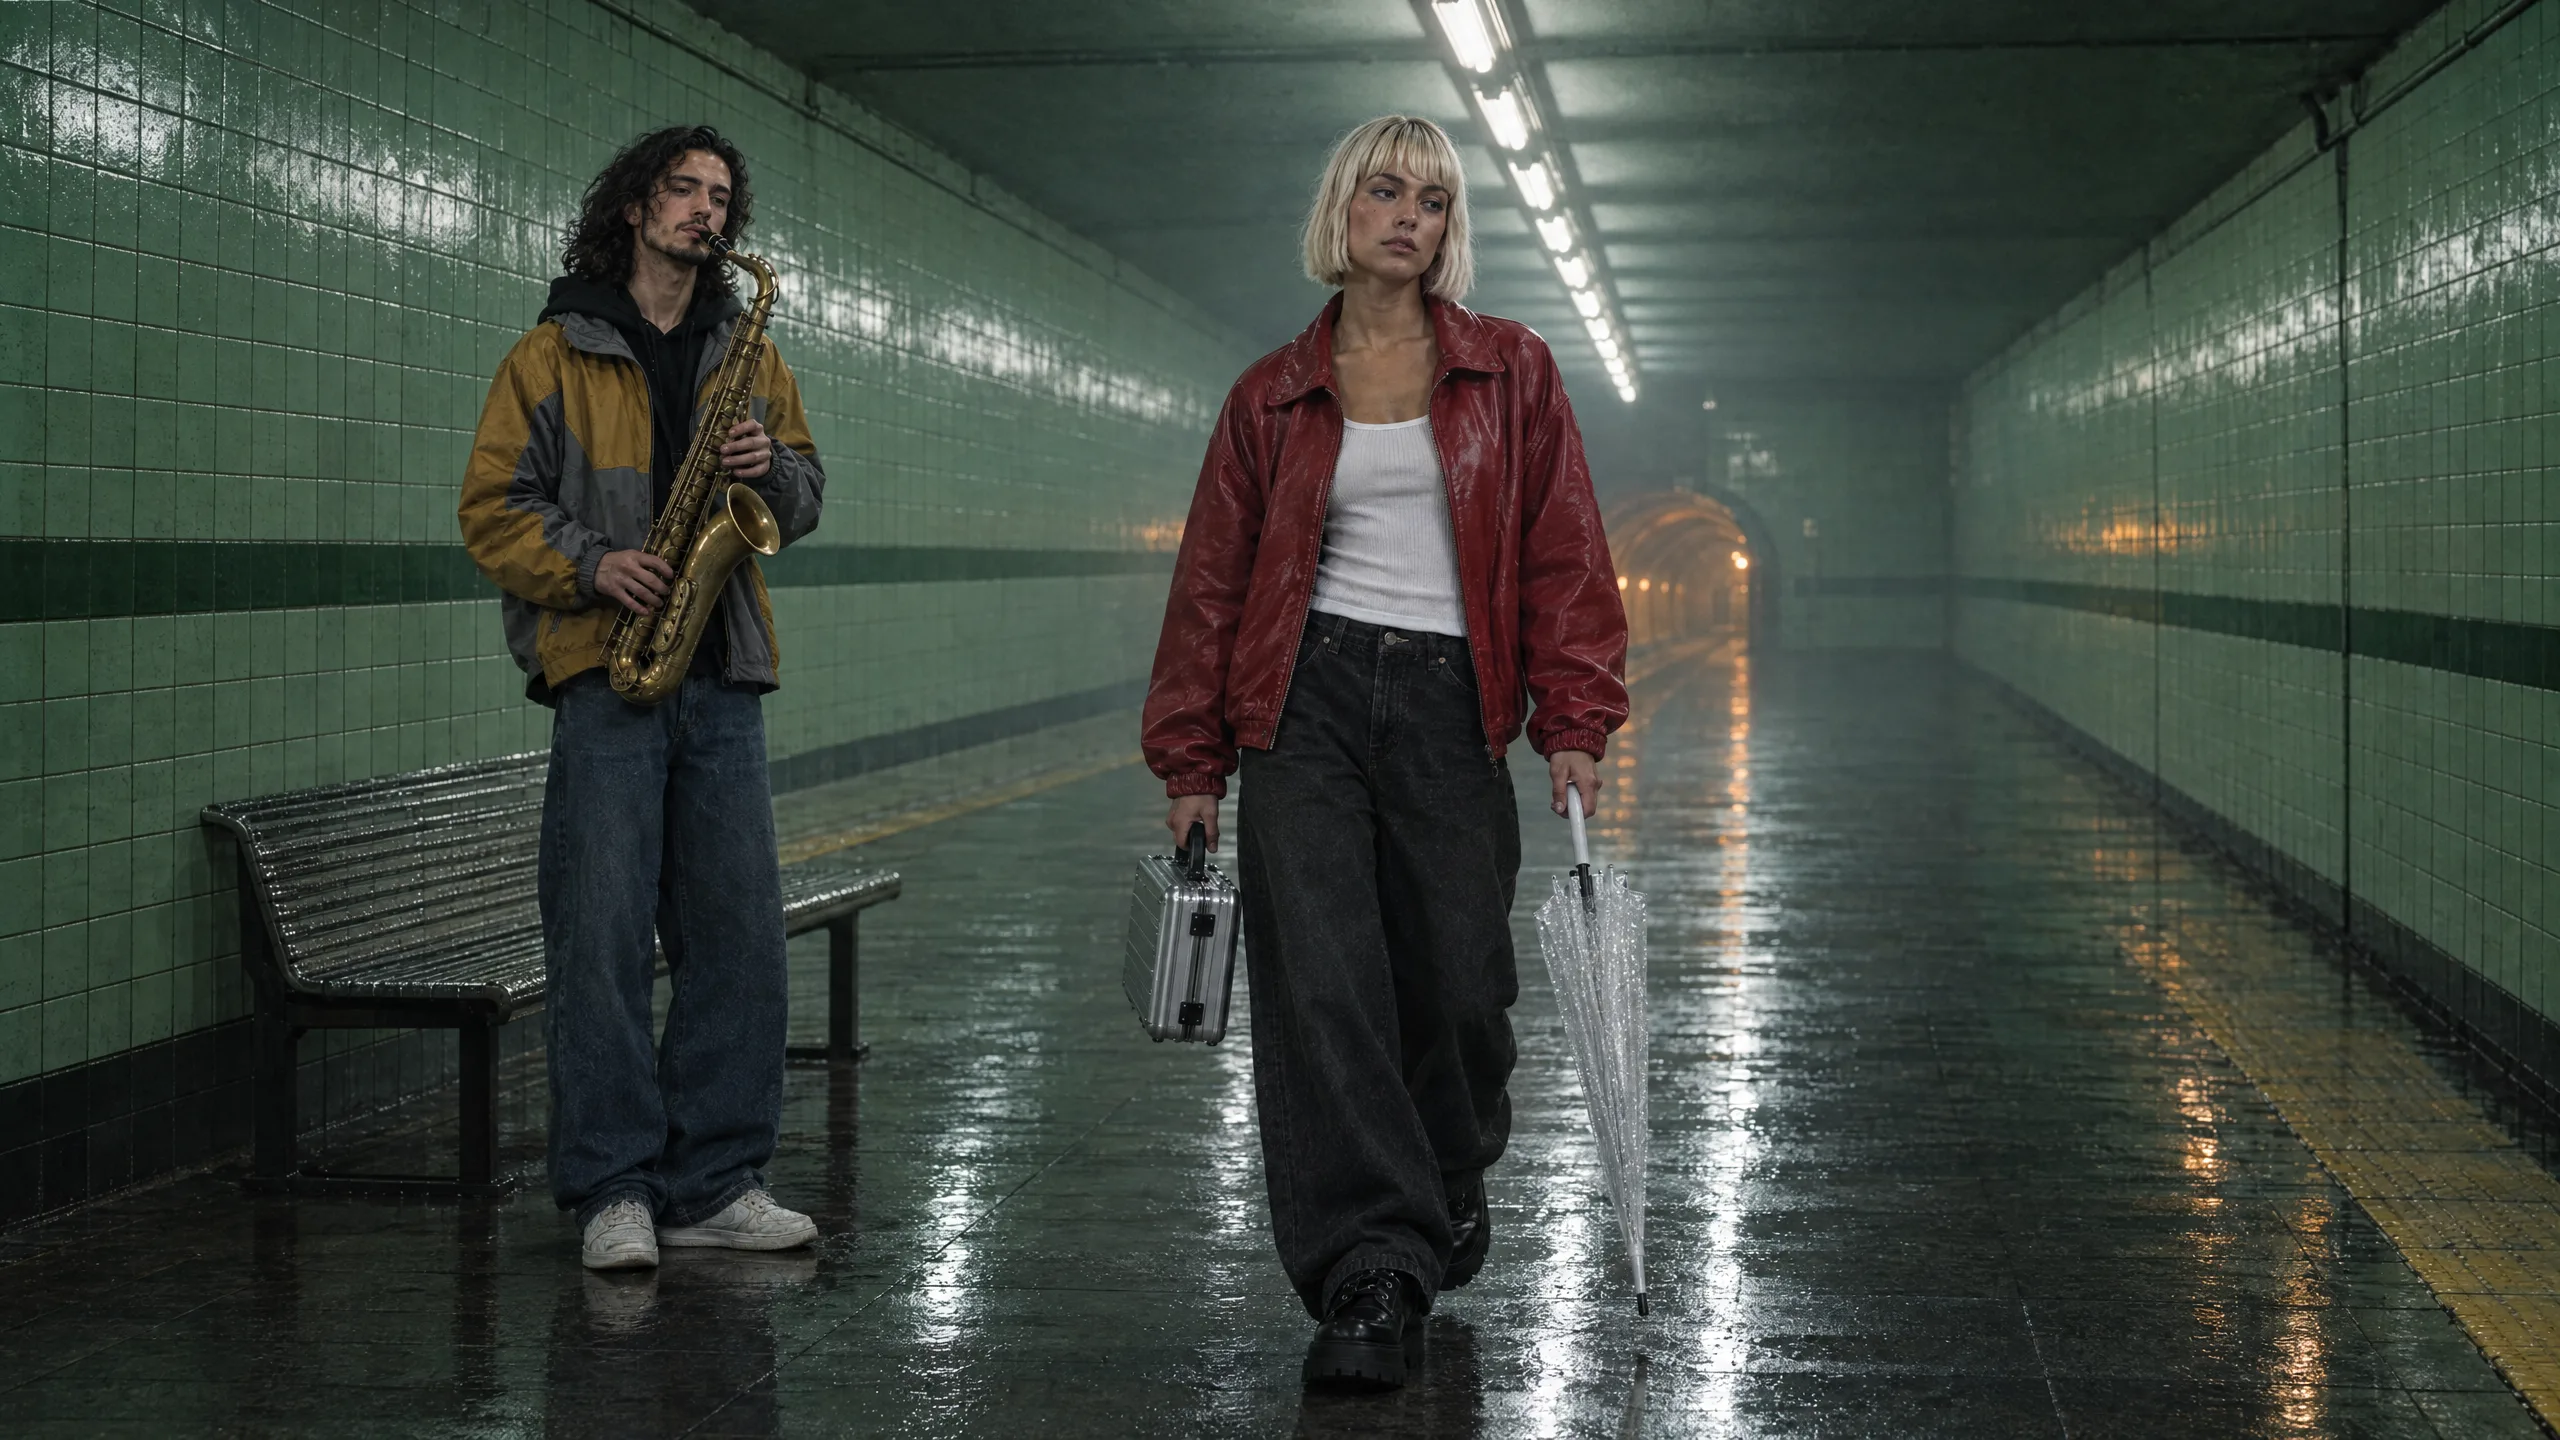
注意:反向情況:提示詞從未提及的道具. 反過來的情況也會發生。第 3 格的提示詞提到的是公事包而不是雨傘,但雨傘還是出現了,因為 Vale 儲存的描述中將雨傘放在她手中。角色的描述會伴隨每個與之關聯的鏡頭。
保持不變的部分:色調
場景也是一種色彩。我們以每秒兩格的頻率測量每個鏡頭的每一格:計算落在場景綠色範圍、隧道琥珀色範圍以及夾克紅色範圍內的飽和像素比例,以及平均亮度。地點的靜態圖作為參考基準。
| 鏡頭 | 綠色 | 琥珀色 | 夾克紅色 | 亮度 |
|---|---|---|---|---|
| 地點靜態圖(參考) | 69% | 1% | 0% | 0.26 |
| 1 奔跑 | 65% | 3% | 3% | 0.28 |
| 2 街頭藝人 | 33% | 6% | 9% | 0.28 |
| 3 車門 | 19% | 12% | 8% | 0.25 |
| 4 插入鏡頭 | 37% | 17% | 0% | 0.35 |
| 5 長椅 | 45% | 13% | 11% | 0.28 |
這段連續鏡頭最接近靜止畫面:沿月台的廣角鏡頭大部分是牆面。車門鏡頭的綠色最少,因為火車填滿畫面右側;插入鏡頭最亮,因為火車頭燈從箱子後方的隧道中出現。兩者都不是色調漂移,而是鏡頭本身呈現的內容。
未保持一致的部分,以及我們未聲稱的部分
- 臉部。 我們未測量 Vale 的臉在鏡頭之間是否屬於同一人,因此本指南不聲稱它是一致的。上述統計涵蓋的是服裝、髮型和道具。
- 沒有對應句子的道具。 第一個畫面 2 缺少箱子,因為該提示詞中沒有包含關於箱子的句子。
- 來自描述的道具。 在第 3 個鏡頭中出現了一把傘,但提示詞中並未提及,因為 Vale 的儲存描述將傘放在她手中。請圍繞描述撰寫鏡頭,或明確說明每隻手拿著什麼。
- 這次每個鏡頭只拍一次。 五個鏡頭都不需要重拍。但在另一次生成中,道具仍可能移動或淡入,因此請以全尺寸檢查每個鏡頭。
哪種錨點適合哪種任務
| 你想保持一致的是 | 使用 | 它在此處保留的內容 |
|---|---|---|
| 角色在多個鏡頭間的服裝與髮型 | 一個角色,已附加,在提示詞中使用 @Name | 畫面中的每個物品,在她出現的 4 個鏡頭中的 4 個都保持一致(其中一個鏡頭靴子未入鏡) |
| 地點在多個鏡頭間的一致性 | 一個地點,已附加 | 5 個鏡頭中的 5 個都保留了 6 個元素中的 6 個;場景的綠色在每個鏡頭中都出現,其比例取決於畫面中牆面的多寡 |
| 道具在多個鏡頭間的一致性 | 每個提示詞中的一句話,以及靜態插入鏡頭中包含該道具的畫面 | 在該句話出現的地方都存在,在該句話未出現的那一個畫面中則不存在 |
| 同一鏡頭中的兩個人物 | 兩人都列入演員陣容,按順序排列,並在提示詞中使用 @ 標註名稱 | Vale 和 Ozzy,鏡頭 2 |
| 一張臉 | 此處未進行測量 | 未宣稱 |
成本是多少
儲存角色或地點不需要花費任何費用。單張圖片按張計價,鏡頭則依模型與長度計價。這五個鏡頭所用模型的即時費率如下:
GPT Image 2.5 FlareEvery plan
Per image
Native 8 點 · 2K 21 點 · 4K 58 點
Kling v3Pro and up
Per 5s clip (audio on by default)
720p 35 點 · 1080p 47 點 · 4K 117 點
Seedance 2.5Pro and up
Per 5s clip
480p 26 點 · 720p 56 點 · 1080p 137 點
1080p renders at 16:9 and 9:16
Seedream 5.0 ProEvery plan
Per image
1K 5 點 · 2K 9 點
頁面載入時從目錄即時讀取。 所有價格都會在生成前顯示。 查看所有費率.
檢查清單
- 每個重複出現的人物對應一個角色,並儲存主要參考圖與一段描述。
- 每個場景對應一個地點,並儲存一張靜態圖與一句話。
- 每個道具對應一句話,並寫入所有需要看到該道具的提示詞中。
- 以 16:9 比例製作畫面,並附加演員陣容與地點;鏡頭由這些畫面生成。
- 在剪輯前,以全尺寸逐一檢查每個鏡頭是否符合清單;若有落差,只需重做一個提示詞,而非整部影片。
常見問題
- 從一個鏡頭到下一個鏡頭,是否都是同一個人的臉?
- 我們尚未進行測量,因此不做此宣稱。我們測量並確認穩定的是服裝、髮型、道具與場景。
- 角色如何保持其服裝一致?
- 它的主要參考照片會作為參考圖片,隨每個附加的提示詞一起傳送,而它的描述則以文字形式呈現。兩者都描述了同一件夾克、靴子和短髮,模型會將這些元素渲染出來。描述也可能帶來提示詞未要求的事物:第 3 個鏡頭中的雨傘就是來自於此。
- 為什麼手提箱在一個鏡頭中消失了?
- 因為該鏡頭的提示詞中沒有包含描述它的句子。道具的一致性取決於每個提示詞中描述它的文字,因此請將相同的句子貼到每個提示詞中;包含該句子的第二個版本鏡頭,就有手提箱。
- 地點仍然必須是照片嗎?
- 不需要。我們使用的是由 Seedream 5.0 Pro 生成的靜態圖像。任何該地點的靜態圖像,無論是上傳還是生成的,都可以作為地點的參考。
- 我可以將角色直接附加到影片模型嗎?
- 在我們測試的模型上,效果不佳:Seedance 2.0 Fast 拒絕了她的參考圖,Seedance 1.5 Pro 無法承載參考圖,而 Seedance 2.5 雖然接受了她的參考圖,卻自行創造了不同的平台。使用附加了地點的圖像合成器生成 16:9 的畫面,然後使用「將圖像動畫化」功能,則能同時保留兩者。
- 調色盤是如何測量的?
- 每秒兩幀,計算三個色調區間中飽和像素的比例,並對每個鏡頭進行平均,再與該地點靜態圖的相同指標進行比較。
一次儲存演員陣容與場景
開啟角色相關指南
影像製作
用 AI 製作短片:從劇本到最終剪輯的流程
一部 25 秒的影片《Last Train》,從五行劇本到調色完成的剪輯:一個已儲存的角色、一個已儲存的地點、一個道具,先生成畫面,再生成鏡頭、聲音、Studio,最後匯出到 Premiere 或 Resolve。
· 閱讀時間 13 分鐘
影片剪輯
將你的角色和狗狗放入任何影片
選擇一段影片,加入一張人物照片和一張狗狗照片,Miroge 會重新演繹該片段:動作不變、場景不變、鏡頭不變。電腦與手機皆可操作,步驟詳解。
· 閱讀時間 10 分鐘
影像製作
NOLGIA 幫你做 DIT:複製、檢查並命名你的相機記憶卡
將相機記憶卡複製到兩個硬碟,逐一檢查每個副本是否與原卡一致,並取得 ASC MHL 清單、DIT 報告和命名後的檔案。免費,在你自己的電腦上執行。
· 閱讀時間 8 分鐘