

Die gleiche Stimme in jedem Video
Ein Erzähler, der in jeder Folge anders klingt, ist kein Erzähler. Speichere die Stimme auf einem Charakter und höre auf, sie manuell auszuwählen.
- 11 Min. Lesezeit
Automatisch aus dem Englischen übersetzt. Original lesen
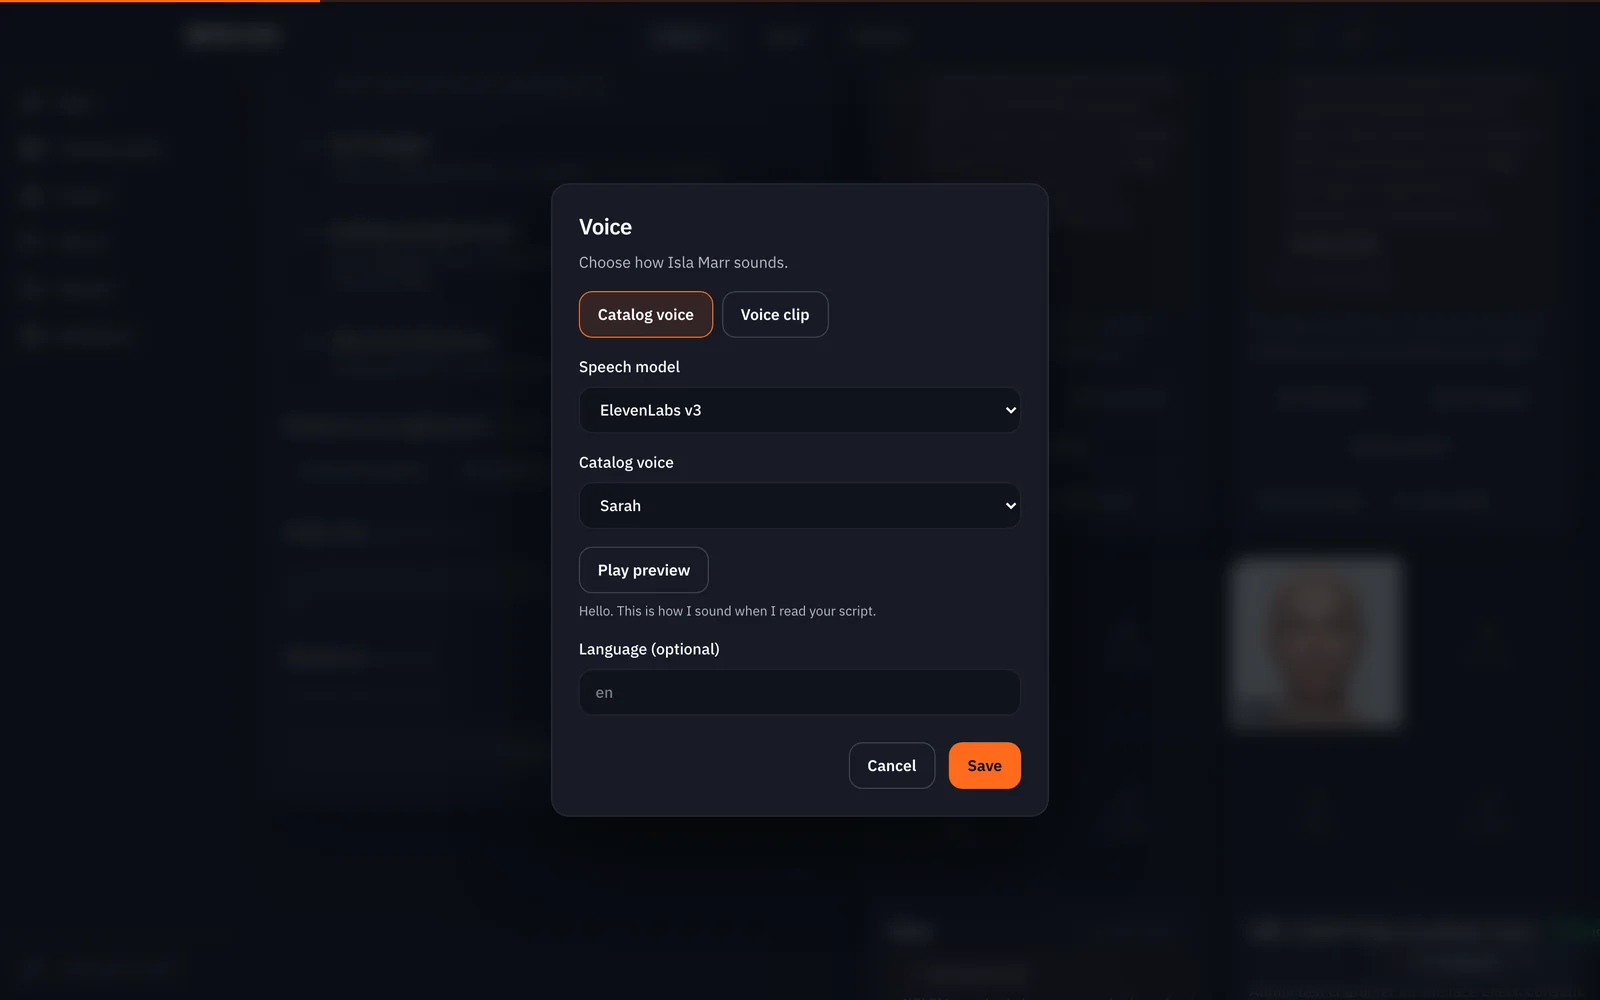 Stimme
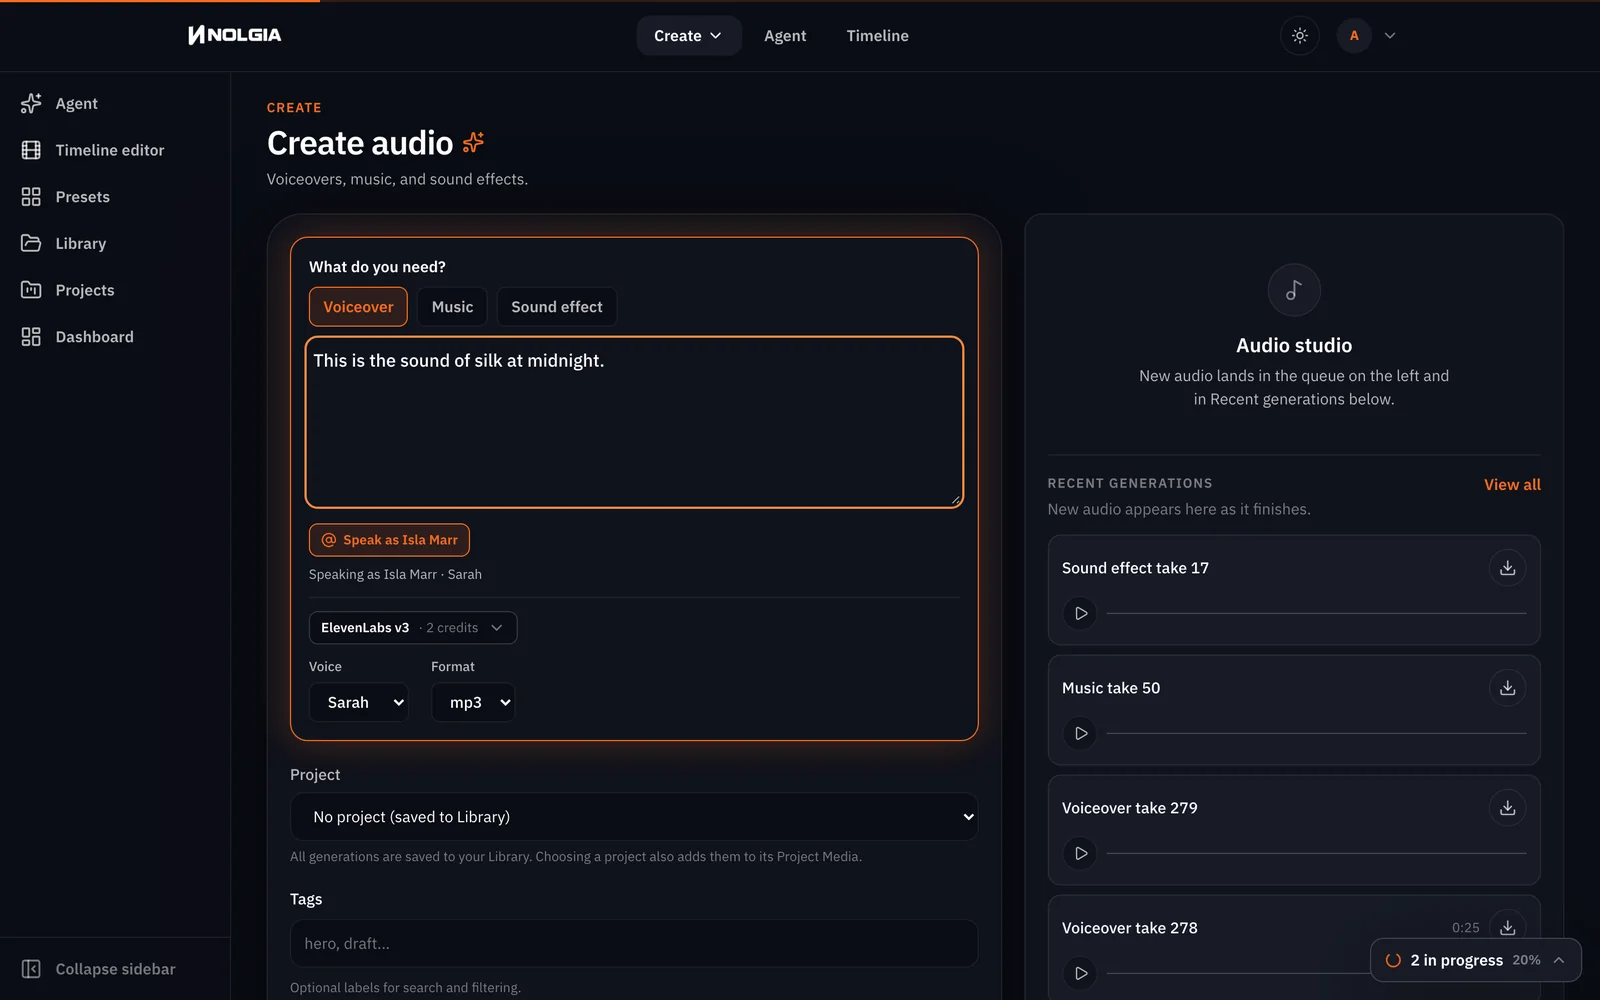 Sprechen als
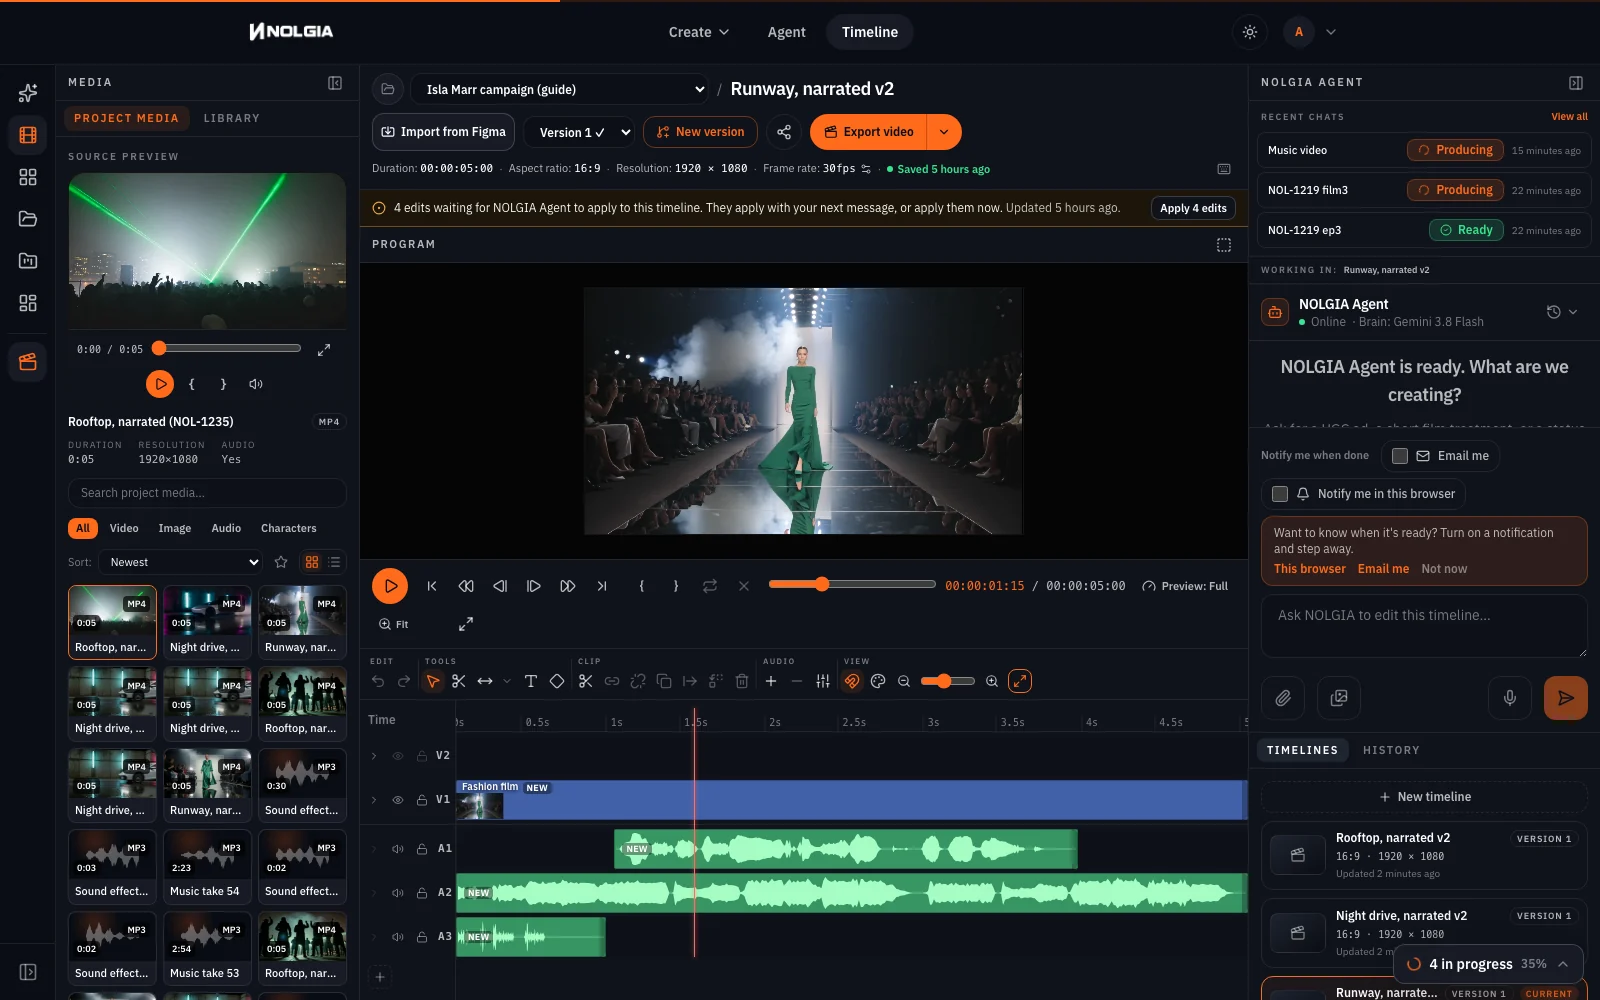 Musikunterlegung und Soundeffekt
Was du erstellst, der Reihe nach. Tippe auf eins, um zu seinem Schritt zu springen.
Du behältst dieselbe Stimme in allen Videos bei, indem du sie auf einem Charakter speicherst. Ein Charakter auf NOLGIA trägt eine Stimme: ein Sprachmodell und eine der benannten Stimmen dieses Modells. Wenn du im Audio-Composer eine Erzählung erstellst, wählt die Schaltfläche Sprechen als den Charakter aus und setzt das Modell und die Stimme auf das gespeicherte Paar. Du wählst sie nie wieder manuell aus, sodass eine Zeile, die nächsten Monat aufgenommen wird, von derselben Stimme gelesen wird wie eine Zeile, die heute aufgenommen wurde.
Dieser Leitfaden erstellt einen Erzähler, eine fiktive Kampagnenstimme, die wir Isla Marr genannt haben, und lässt sie eine Zeile über drei unabhängige Clips lesen: einen Laufsteg, eine Nachtfahrt und eine Dachparty. Jeder Clip erhält auch eine Musikunterlegung und einen Sound-Cue, die in Studio unter der Stimme angeordnet werden. Jeder Clip und jede Zeile ist echte Ausgabe; das Modell und die Stimme haben sich zwischen ihnen nie geändert.
Was schiefgehen kann, und die Korrektur
| Fehler | Warum es schadet | Korrigieren |
|---|---|---|
| Die Stimme jedes Mal manuell auswählen | Einmal v3, das nächste Mal Turbo, und derselbe Name klingt unterschiedlich | Speichere das Modell und die Stimme auf einem Charakter und nutze Sprechen als |
| Ein Modell ohne Stimmliste wählen | MiniMax Speech, Inworld, Dia und Orpheus veröffentlichen keine benannten Stimmen, es gibt also nichts, woran man sich festhalten kann | Nutze ElevenLabs oder Kokoro für einen wiederkehrenden Erzähler |
| Dem Charakter eine Sprachaufnahme geben und eine Erzählung erwarten | Eine Aufnahme-Stimme ist für Modelle, die eine Referenzspur benötigen; Text-zu-Sprache braucht eine Katalog-Stimme | Legen Sie eine Katalog-Stimme für die Erzählung fest, eine Aufnahme nur, wenn ein Videomodell eine verlangt |
| Die Geschwindigkeit pro Aufnahme ändern | Gleiche Stimme, unterschiedliches Tempo, wirkt wie zwei Personen | Lass die Geschwindigkeit unverändert; passe stattdessen das Skript an die Aufnahme an |
| Den Satz umschreiben, damit er mehr wie die Stimme klingt | Die Stimme ist festgelegt; die Worte sind die Variable | Schreibe für die gespeicherte Stimme und halte die Satzlänge konstant |
Bevor du beginnst
- Ein Charakter auf der Charakter-Seite. Zum Erstellen brauchst du einen Namen und mindestens ein Foto: Klicke auf Referenzbilder hinzufügen, lade das Foto hoch, benenne den Charakter und klicke auf Charakter erstellen. Unser Beispiel ist ein generiertes Porträt, es ist also keine reale Person beteiligt.
- Ein Sprachmodell mit benannten Stimmen. Der Dialog Stimme listet nur diese auf: die ElevenLabs-Modelle und Kokoro.
- Die Clips, die du vertonen möchtest, in deiner Mediathek. Unsere sind drei fünfsekündige Clips ohne Ton: die Startbahn und das Dachgeschoss auf Kling v3, die Nachtfahrt auf Seedance 2.5.
Speichere die Stimme am Charakter
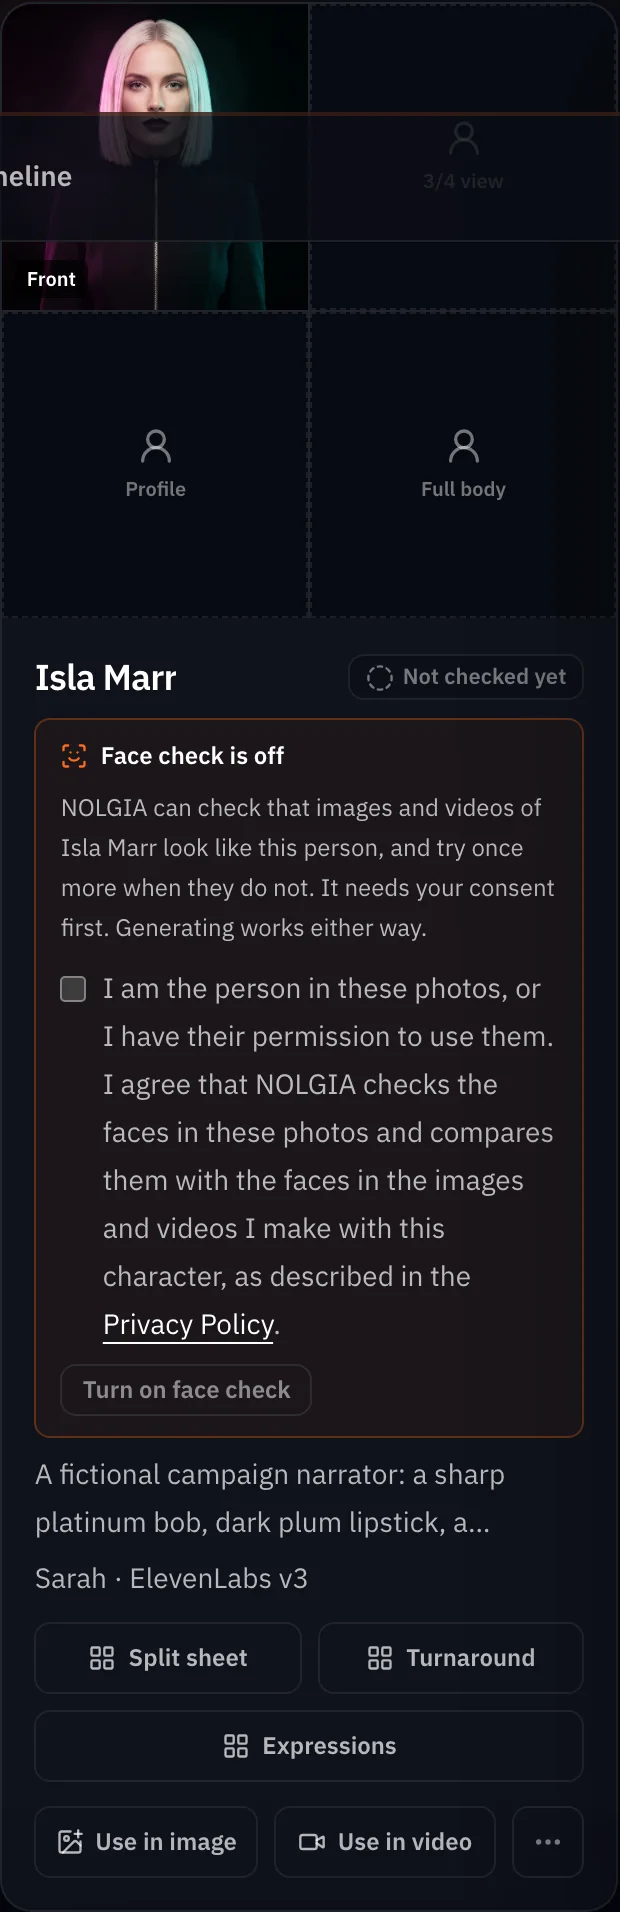
Auf der Seite „Charaktere“ öffnest du das ...-Menü auf der Karte des Charakters und wählst Stimme. Der Dialog bietet zwei Optionen: Katalogstimme und Stimmclip. Behalte „Katalogstimme“ bei. Wähle das Sprachmodell, dann die Katalogstimme; eine Vorschau abspielen-Schaltfläche spielt kostenlos eine aufgezeichnete Hörprobe dieser Stimme ab. Füge optional eine Sprache hinzu und klicke auf Speichern. Die Karte zeigt die Stimme nun unter der Beschreibung an.
Erzählen mit „Sprechen als“
Öffne den Audio-Composer in der Voiceover-Aufgabe und drücke auf Sprechen als. Wähle den Charakter aus. Die Modellauswahl wechselt zum gespeicherten Modell und die Voice-Liste zur gespeicherten Stimme. Eine Zeile unter der Schaltfläche bestätigt dies: Speaking as Isla Marr · Sarah. Tippe den Text ein und drücke auf Audio generieren. Wir haben dies fünfmal hintereinander für zwei Guides gemacht, und das Paar hat sich nie verändert.
This is the sound of silk at midnight.Nothing here was built to stand still.You already know the ending. Wear it anyway.Achtung:Wenn der Hinweis besagt, dass die Stimme nicht verfügbar ist. Speak as prüft, ob das gespeicherte Modell die gespeicherte Stimme weiterhin anbietet. Wenn eine Stimme aus dem Katalog entfernt wird, weist dich der Hinweis darauf hin, auf der Seite Characters eine andere auszuwählen, anstatt mit einer Ersatzstimme zu lesen.
Lege eine Musikunterlegung und einen Soundeffekt unter die Stimme
Eine einzelne Zeile wirkt nackt. Erstelle ein Musikbett in der Musik-Aufgabe des Audio-Composers und einen Sound-Cue im Soundeffekt, baue dann die Timeline für jeden Clip in Studio auf: Timelines, Neue Timeline, und im Mediathek-Tab des linken Panels den Clip mit seinem +, die Aufnahme an der Playhead-Position, wo die Zeile beginnt, das Bett und den Cue.
Tipp:Studio senkt das Bett unter der Stimme ab. Eine heute erstellte Timeline wird beim Export gemischt: Die Musik wird um etwa 12 dB abgesenkt, während jemand spricht, das Bett blendet am Ende aus, und die Lautstärke wird ausgeglichen. Um selbst einen Level festzulegen, wähle einen Sound und öffne das Audio-Inspektor-Fenster: Clip-Lautstärke, Einblenden und Ausblenden, Unter der Stimme absenken und die Spurlautstärke der Spur. Unsere drei Timelines wurden geschnitten, bevor Studio diese Funktionen hatte, daher wählten wir stattdessen eine leise Passage aus jedem Bett: Bitte das Musikmodell um starke Dynamik, spiele den Track in der Quellvorschau ab, drücke Mark In, wo ein voller Takt in eine leise Passage übergeht, Mark Out fünf Sekunden später, und drücke + mit der Playhead bei 0. Das gibt der Zeile immer noch Raum, ohne dass ein hörbares Absenken nötig ist.
Sleek fashion-show runway track, 120 bpm, deep kick and a crisp clicking hi-hat, glossy synth stabs, instrumental, no vocals. Strong dynamics: two seconds of the full groove, then four seconds of a hushed, near-silent filtered pulse, then the full groove slams back in, and that shape repeats through the track.Dark synthwave night-drive track, 100 bpm, driving analog bass arpeggio, gated snare, cold pads, instrumental, no vocals. Strong dynamics: two seconds of the full drive, then four seconds of a sparse, hushed passage with only a low filtered bass, then the full drive returns, and that shape repeats through the track.Warehouse rave build for a rooftop party at night, 128 bpm, instrumental, no vocals: a soft muffled kick and a quiet rising filtered riser that builds for five seconds, then a huge drop with open hi-hats and a big supersaw lead, and that quiet build and big drop repeat through the track.Die Soundeffekte sind jeweils eine kurze Zeile auf ElevenLabs Sound Effects v2, zugeschnitten mit Mark Out, damit sie die Stimme nicht überdecken: Kamera-Auslöser für die erste Sekunde des Runways, Motor und Spritzwasser nach dem Text der Fahrt und ein Jubel der Menge, wenn das Konfetti auf dem Dach fällt. Drücke Play: Die Stimme ist in allen drei Szenen gleich, weil das Modell und die Stimme jedes Mal dieselbe Anfrage waren, und sie liegt über der Musik.
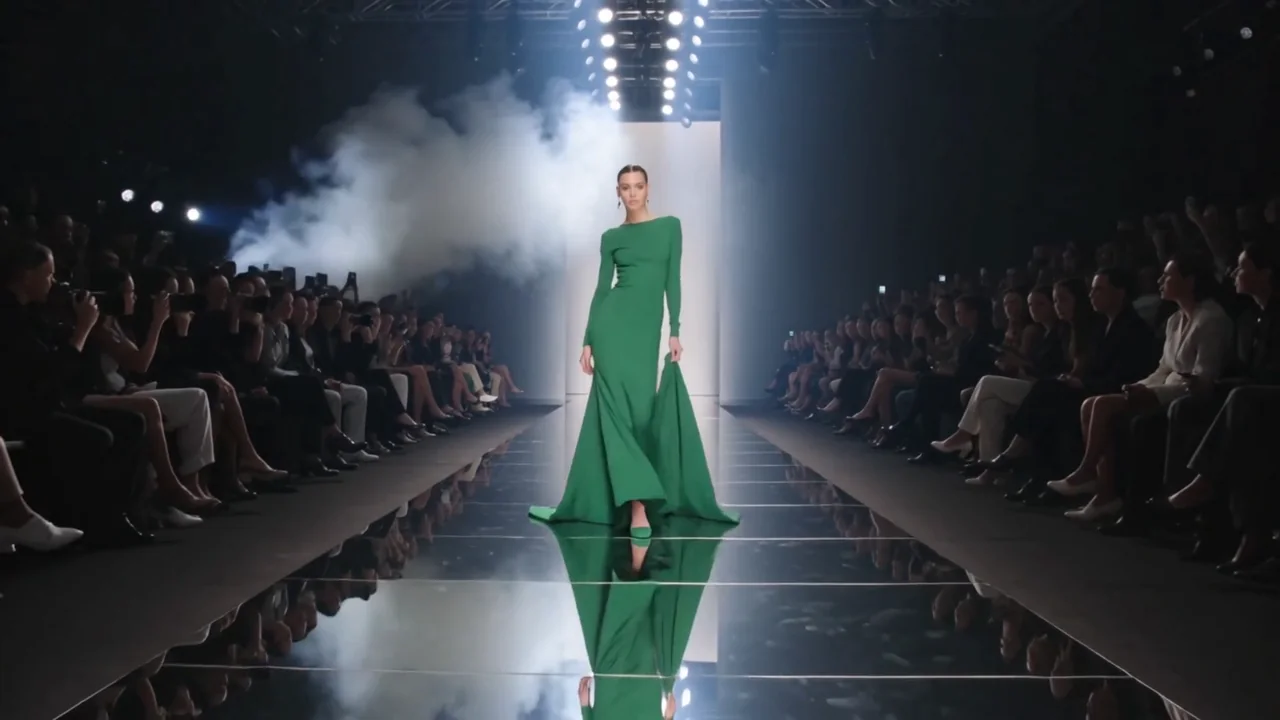
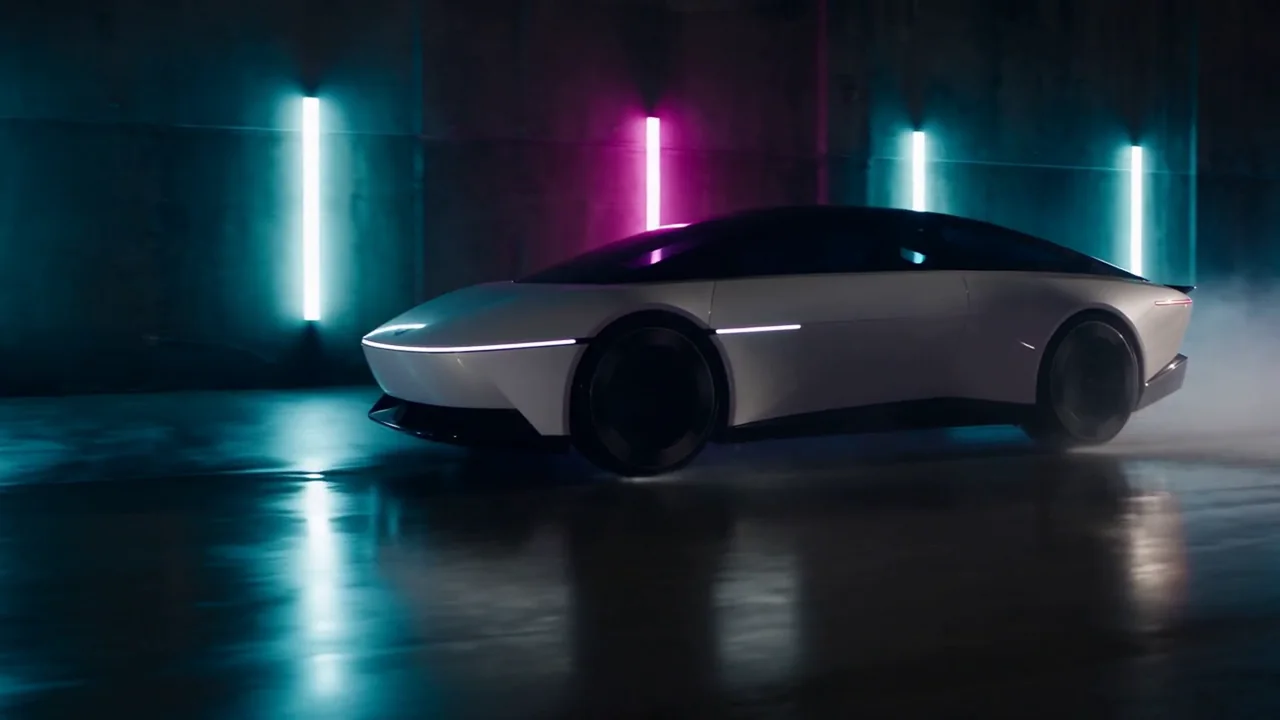
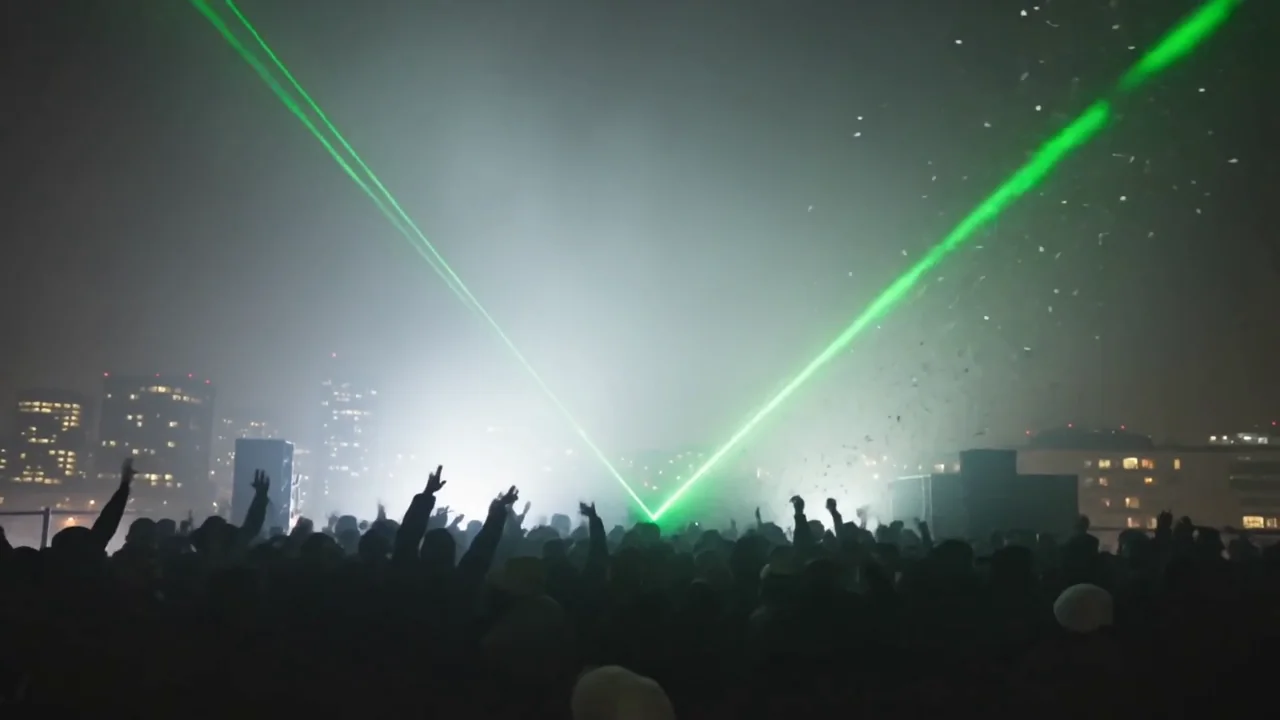
Wir haben jeden Export gemessen: keine Stille länger als eine halbe Sekunde und die Stimme mindestens 3 dB über allem anderen, während sie spricht. Diese Timelines mischten alle Spuren auf dem gleichen Level, daher stammen diese Zahlen aus den von uns gewählten Passagen, nicht aus einer Einstellung.
Drei Wege zur Umsetzung
| Pfad | Vorgehen | Am besten wenn |
|---|---|---|
| Schnellste | Audio-Composer, Speak as, Satz für Satz | Ein paar Sätze für einen Schnitt, den du gerade erstellst |
| Automatisiert | Beauftrage den NOLGIA Agent mit dem Namen der Figur; er kann deine Figuren auflisten und Audio mit der gespeicherten Stimme generieren | Eine Serie von Episoden aus einem Skript |
| Maximale Kontrolle | Die API: POST /generate/audio mit der ID des Charakters oder das MCP-Tool nolgia_text_to_audio aus deinem eigenen Code | Batch-Narration aus einem Dokument oder einer Pipeline |
Der API-Pfad ist unter Charaktere und Orte dokumentiert: Die Stimme eines Charakters wird bei der Audio-Generierung mit der Charakter-ID verwendet und bei der Video-Generierung, wenn du die Stimme des Charakters anforderst. Wir haben für diesen Leitfaden den Composer-Pfad ausgeführt, nicht die anderen beiden.
Wo du noch einmal generieren musst
- Die Auslieferung variiert noch leicht. Gleiche Stimme, gleiches Modell, aber jeder Durchlauf ist eine neue Aufnahme. Wenn eine Zeile flach wirkt, führe sie erneut aus; die Stimme bleibt gleich.
- Ein Hintergrund, der noch ein Wort übertönt. Der Export senkt die Musik unter der Stimme ab, aber eine laute Passage kann eine Zeile noch verdecken. Senke die Clip-Lautstärke des Hintergrunds im Audio-Inspektor oder versetze Mark In auf eine leisere Passage.
- Deine eigene Stimme wird manuell ausgewählt. Auf einem kostenpflichtigen Plan klonst du mit Eigene Stimme erstellen in der Voice-Liste des Audio-Composers deine Stimme aus 10 Sekunden bis 5 Minuten Aufnahmen, basierend auf den ElevenLabs-Sprachmodellen. Der Voice-Dialog auf der Characters-Seite speichert nur Katalog-Stimmen und Voice-Clips, daher kann Speak as noch keine eigene Stimme verwenden: Wähle sie jedes Mal in der Voice-Liste aus. Ein Voice-Clip bei einem Charakter ist eine Referenz für Modelle, die eine solche benötigen, keine Text-to-Speech-Stimme.
- Die Geschwindigkeit ist nur über die API verfügbar. Der Composer bietet derzeit keine Geschwindigkeitssteuerung.
Was es kostet
Das Speichern einer Stimme kostet nichts; die Vorschau einer Stimme kostet nichts. Jede Zeile wird mit dem Preis pro Zeichen des Modells abgerechnet, mit einem Mindestbetrag. Jedes Musikbett und jeder Cue ist eine pauschale Gebühr. Die Clips wurden nach Länge berechnet, und die Studio-Exporte werden nicht abgerechnet.
ElevenLabs v3Every plan
Per 1,000 characters
Standard 6 Credits
Lyria 3.5Every plan
Per generation
Standard 5 Credits
Stable Audio 3 MediumEvery plan
Per generation
Standard 3 Credits
ElevenLabs SFXEvery plan
Per generation
Standard 4 Credits
Kling v3Pro and up
Per 5s clip (audio on by default)
720p 35 Credits · 1080p 47 Credits · 4K 117 Credits
Seedance 2.5Pro and up
Per 5s clip
480p 26 Credits · 720p 56 Credits · 1080p 137 Credits
1080p renders at 16:9 and 9:16
Live aus dem Katalog gelesen, wenn diese Seite lädt. Jeder Preis wird angezeigt, bevor du generierst. Alle Tarife ansehen.
Probiere es selbst aus
Das Porträt des Erzählers
- Isla Marr Porträt, 1408x768 JPEGJPEG-Foto · 1408x768 · 483 KBHerunterladen
Fashion film, one continuous shot. A model in a sculpted emerald green floor-length gown with long sleeves walks down a mirrored runway toward the camera, camera strobes flashing from the crowd in silhouette on both sides, white haze, slow motion, low tracking shot moving backwards, anamorphic flares, deep blacks. No text, no logo.Premium car commercial, one continuous shot. An original concept coupe that resembles no production car: a low, wide, wedge-shaped matte white body with a single thin continuous light bar across the nose, no grille, no badges, a smooth flush glass canopy, enclosed rear wheel arches and a sharp ducktail rear. It slides sideways through a wet night street lined with bare concrete walls and plain vertical neon tubes in teal and magenta, no shop windows, no signs, no lettering anywhere. Rain streaks in the air, neon reflections stretched across the asphalt, low side tracking shot, spray from the tyres, motion blur on the passing lights, cinematic contrast.Music video, one continuous shot. A rooftop rave at night: a dense crowd in silhouette wearing long dark coats, hoodies and bucket hats, arms raised, under sharp green laser beams fanning through a thick haze layer, confetti bursting in slow motion, a city skyline of blurred lights behind them, low handheld camera looking up, backlit, high contrast. No text, no logo.Deine Clips und Musikbetten werden nicht mit unseren übereinstimmen; ein Prompt gibt dem Modell die Szene oder die Stimmung, nicht die Aufnahme, also finde deine eigene leise Passage für den Mark In. Die Stimme wird übereinstimmen, weil der Charakter sie trägt.
Checkliste
- Charakter existiert mit einem Namen und einem Foto.
- Stimmen-Dialog: Katalogstimme, ein Modell mit benannten Stimmen, Vorschau abgespielt, gespeichert.
- Audio-Composer: „Sprechen als“ zeigt den Charakter an und die Notiz benennt die Stimme.
- Eine Generierung pro Zeile; prüfe jede Aufnahme, bevor du schneidest.
- Ein Musikbett, das mit starken Dynamiken angefordert wurde, und ein Cue pro Clip.
- Studio: Clip, Aufnahme am Playhead, ein fünfsekündiges Musikbett-Fenster aus einer leisen Passage, der Cue klar von der Stimme getrennt, Video exportieren.
Fragen und Antworten
- Welche Modelle können die Stimme eines Charakters sein?
- Die Modelle mit benannten Stimmen: die ElevenLabs-Sprachmodelle mit zehn Stimmen und Kokoro mit zwanzig. MiniMax Speech, Inworld, Dia und Orpheus haben keine Stimmenliste, daher werden sie im Dialog nicht angeboten.
- Klingen alle Aufnahmen identisch?
- Die Stimme und das Modell sind identisch. Die Lesung selbst wird jedes Mal neu generiert, daher können sich Tempo und Betonung zwischen den Aufnahmen leicht unterscheiden. Wiederhole eine Zeile, die dir nicht gefällt; die Stimme bleibt gleich.
- Kann ich meine eigene Stimme verwenden?
- Ja, in einem kostenpflichtigen Plan. Öffne im Audio-Composer bei einem ElevenLabs-Sprachmodell die Liste „Stimme“ und wähle „Eigene Stimme erstellen“: Nimm 10 Sekunden bis 5 Minuten einer sprechenden Person auf oder lade sie hoch, bestätige, dass es deine Stimme ist oder du die Erlaubnis des Sprechers hast, und sie liest ab dann jedes Skript. Eine Figur kann noch keine eigene Stimme tragen, wähle sie daher in der Liste „Stimme“. Ein Stimmclip an einer Figur, 3 bis 30 Sekunden, ist eine Referenz für Modelle, die eine Referenzspur akzeptieren.
- Kann ein Videomodell die Stimme der Figur verwenden?
- Die API hat dafür einen Schalter bei der Videogenerierung. Wir haben es für diesen Leitfaden nicht getestet, daher beschreiben wir nicht, wie es klingt.
- Wofür ist das Feld „Sprache“?
- Ein optionales Tag wie en oder en-US, das mit der Stimme gespeichert wird und angibt, welche Sprache die Figur spricht. Lass es leer, wenn du unsicher bist.
- Kann Studio die Musik unter der Stimme absenken?
- Ja. Bei einer heute erstellten Timeline wird die Musik beim Export um etwa 12 dB abgesenkt, während jemand spricht. Die Option Duck under voice ist für Musik standardmäßig aktiviert. Du kannst sie deaktivieren oder Clip volume, Fade in, Fade out und Track volume im Audio-Inspektor selbst einstellen.
Stimme einer Figur zuweisen
Characters öffnenÄhnliche Anleitungen
Audio
Stimme, Musik und Soundeffekte für dein Video
Erstelle eine Erzählstimme, eine Musikunterlegung und einen Soundeffekt im Audio-Composer und lege sie in Studio unter deinen Clip. Welches Modell welche Aufgabe übernimmt und was jedes kostet.
· 10 Min. Lesezeit
Kanäle
Ein gesichtloser, narrativer Kanal: Tools, Workflow und die nächste Episode
Skript, eine gespeicherte Erzählerstimme, B-Roll in einem festen Look aus dem Video-Composer, der Schnitt in Studio und der NOLGIA Agent für die nächste Episode. Zwei kurze Episoden, real produziert.
· 12 Min. Lesezeit
Agent
Das NOLGIA Agent Kochbuch: Was du sagen kannst und was als Nächstes passiert
Zehn Nachrichten, die du an den NOLGIA Agent senden kannst, was er damit macht und welche Vorlage dahintersteckt, von Produktfotos und einem Listing-Set bis hin zu einem Hook-Score und einem geschnittenen Video.
· 6 Min. Lesezeit