

La misma voz en cada vídeo
Un narrador que suena diferente en cada episodio no es un narrador. Guarda la voz en un personaje y deja de elegirla a mano.
- 11 min de lectura
Traducido automáticamente del inglés. Leer el original
Mantienes la misma voz en todos los vídeos guardándola en un personaje. Un personaje en NOLGIA lleva una voz: un modelo de habla y una de las voces con nombre de ese modelo. Cuando creas la narración en el compositor de audio, el botón Hablar como elige el personaje y establece el modelo y la voz al par guardado. Nunca los eliges manualmente de nuevo, por lo que una línea grabada el mes próximo la lee la misma voz que una línea grabada hoy.
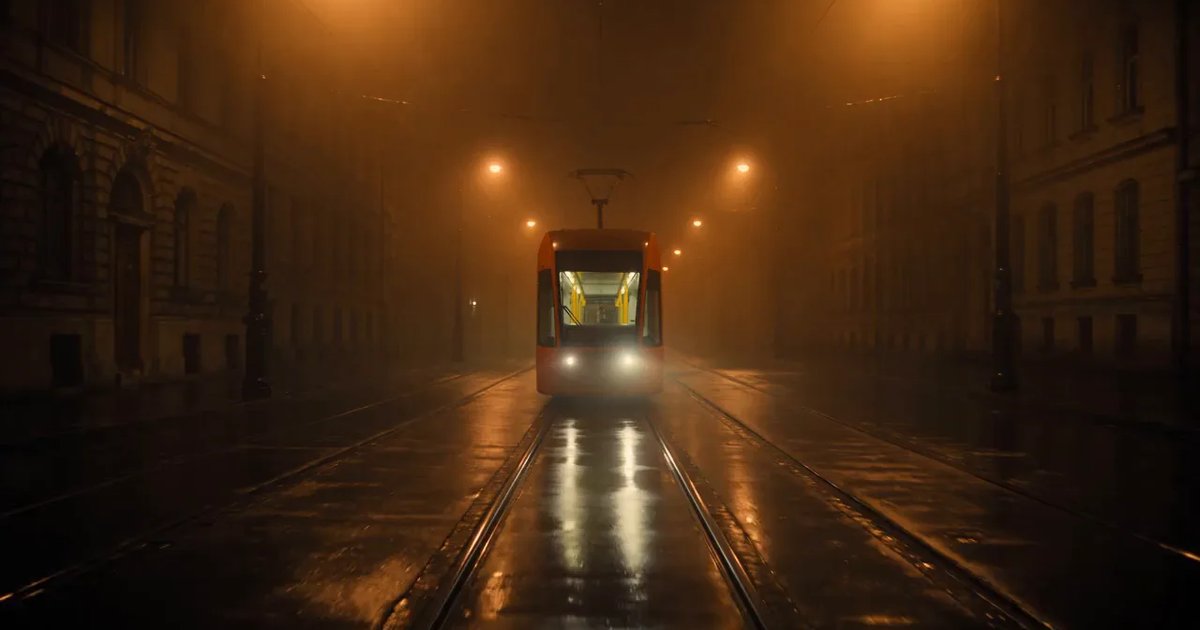
Esta guía crea un narrador, una voz de campaña ficticia que llamamos Isla Marr, y hace que lea una línea sobre tres clips no relacionados: una pasarela, un viaje nocturno y una fiesta en la azotea. Cada clip también recibe una base musical y una señal de sonido, colocadas bajo la voz en Studio. Cada clip y cada línea es una salida real; el modelo y la voz nunca cambiaron entre ellos.
Qué sale mal y la corrección
| Error | Por qué perjudica | Corregir |
|---|---|---|
| Elegir la voz manualmente cada vez | Una sesión en v3, la siguiente en Turbo, y el mismo nombre suena diferente | Guarda el modelo y la voz en un personaje y usa Hablar como |
| Elegir un modelo sin lista de voces | MiniMax Speech, Inworld, Dia y Orpheus no publican voces con nombre, así que no hay nada que fijar | Usa ElevenLabs o Kokoro para un narrador recurrente |
| Dar al personaje un clip de voz y esperar una narración | La voz de un clip es para modelos que aceptan una pista de referencia; la conversión de texto a voz necesita una voz del catálogo | Asigna una voz del catálogo para la narración, y un clip solo cuando un modelo de vídeo lo pida |
| Cambiar la velocidad por toma | La misma voz, distinto ritmo, suena a dos personas | No toques la velocidad; ajusta el guion al clip en su lugar |
| Reescribir la frase para que suene más como la voz | La voz es fija; las palabras son la variable | Escribe para la voz que guardaste y mantén la longitud de las frases constante |
Antes de empezar
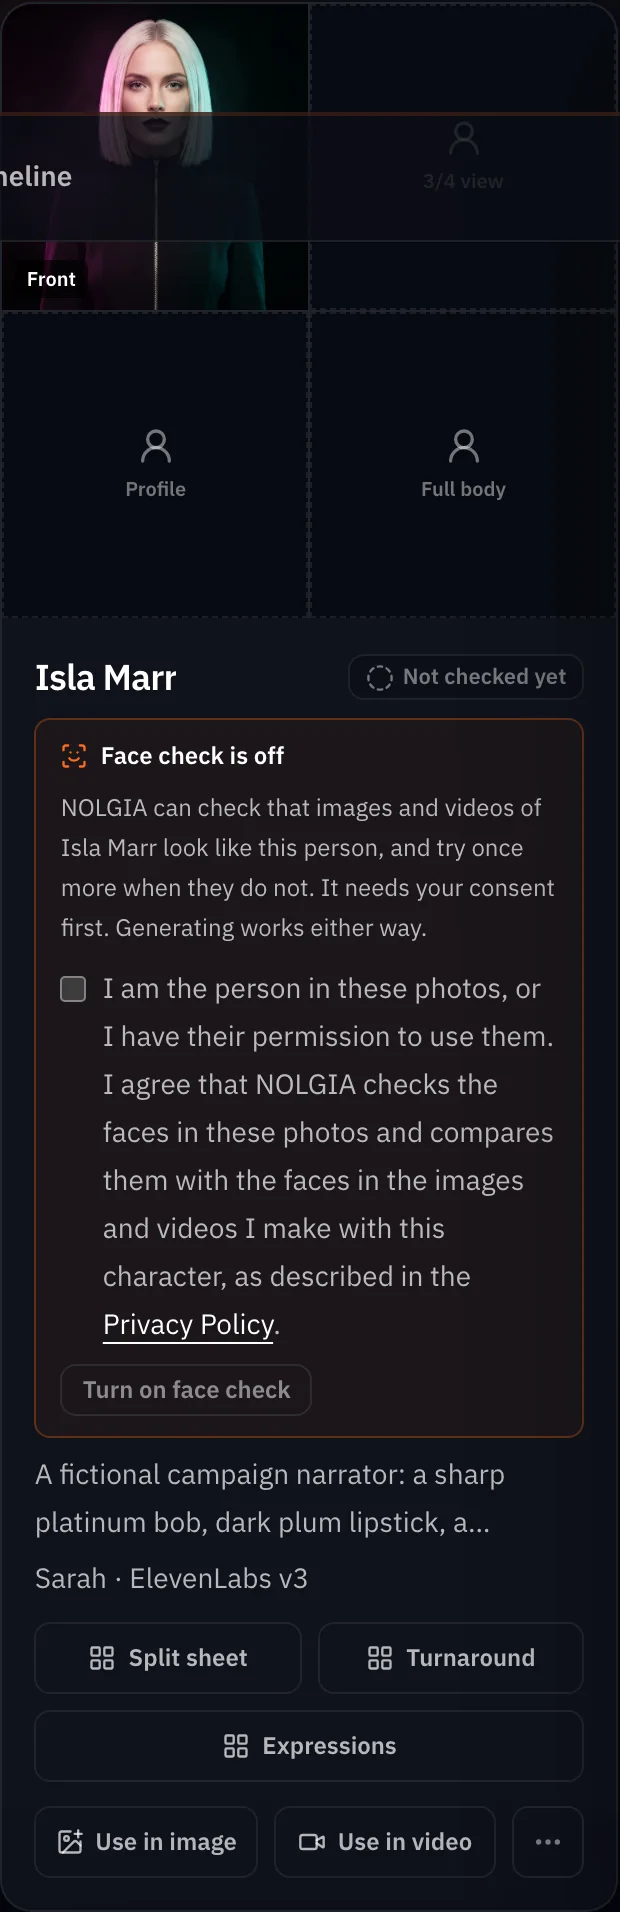
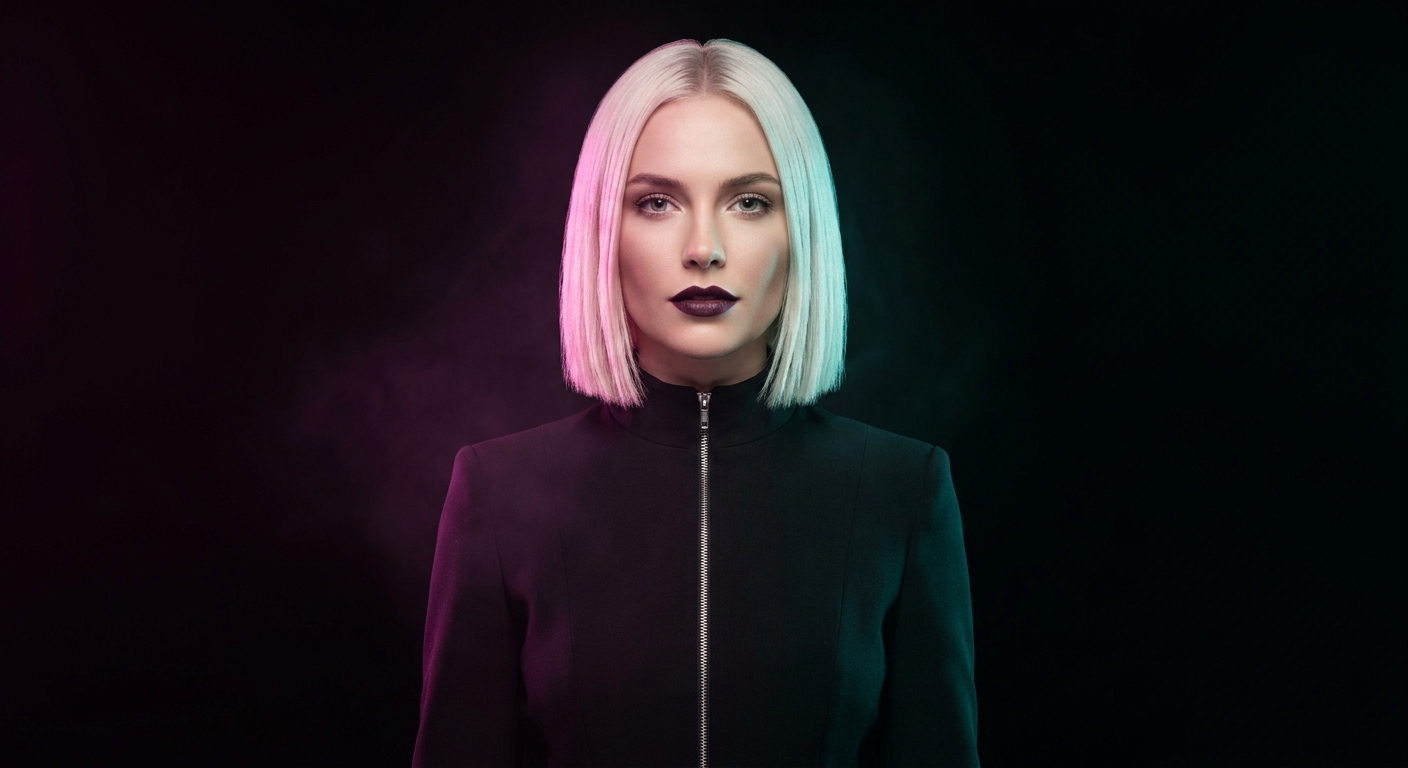
- Un personaje en la página de Personajes. Para crear uno necesitas un nombre y al menos una foto: pulsa Añadir imágenes de referencia, sube la foto, nombra al personaje y pulsa Crear personaje. El nuestro es un retrato generado, así que no hay ninguna persona real involucrada.
- Un modelo de voz con voces con nombre. El diálogo de Voz solo lista esas: los modelos de ElevenLabs y Kokoro.
- Los clips que quieres narrar, en tu Biblioteca. Los nuestros son tres clips de cinco segundos sin sonido: la pista de aterrizaje y la azotea en Kling v3, y la conducción nocturna en Seedance 2.5.
Guarda la voz en el personaje
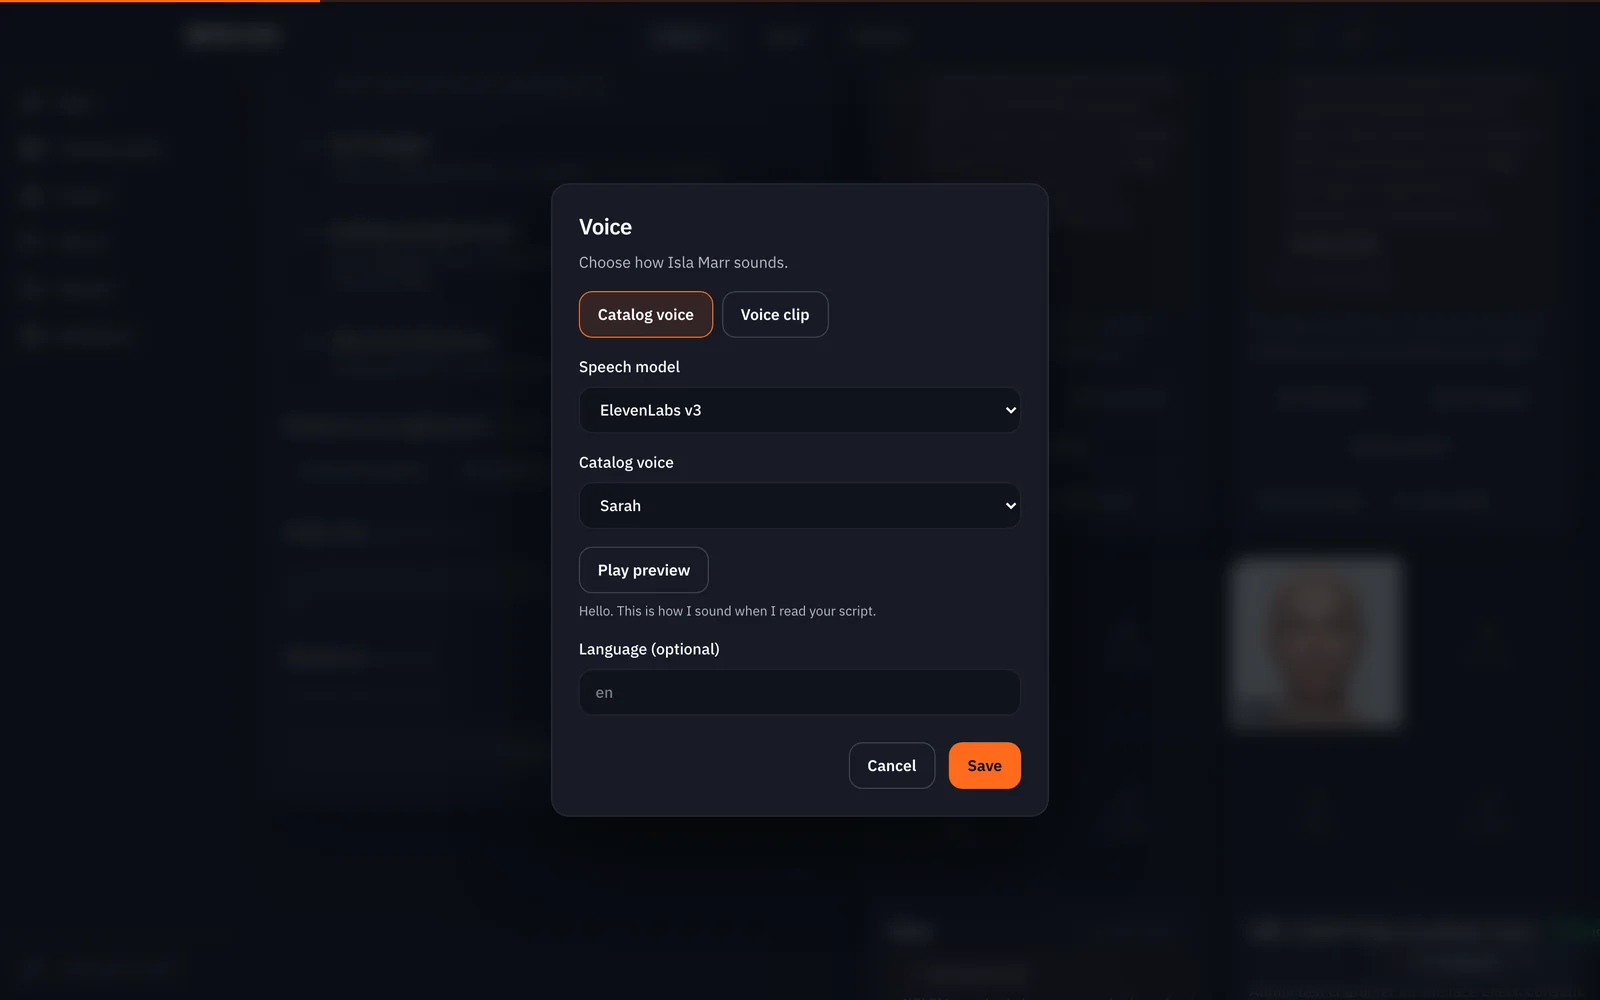
En la página Personajes, abre el menú ... en la tarjeta del personaje y elige Voz. El cuadro de diálogo ofrece dos tipos: Voz del catálogo y Clip de voz. Mantén Voz del catálogo. Selecciona el Modelo de voz y luego la Voz del catálogo; un botón Reproducir vista previa reproduce una muestra grabada de esa voz gratis. Añade un idioma si quieres, y pulsa Guardar. La tarjeta ahora muestra la voz bajo la descripción.
Narrar con Hablar como
Abre el editor de audio en la tarea de locución y pulsa Hablar como. Elige el personaje. El selector de modelos cambia al modelo guardado y la lista de voces a la voz guardada, y una línea bajo el botón lo confirma: Hablando como Isla Marr · Sarah. Escribe la frase y pulsa Generar audio. Lo hicimos cinco veces seguidas para dos guías, y la pareja nunca cambió.
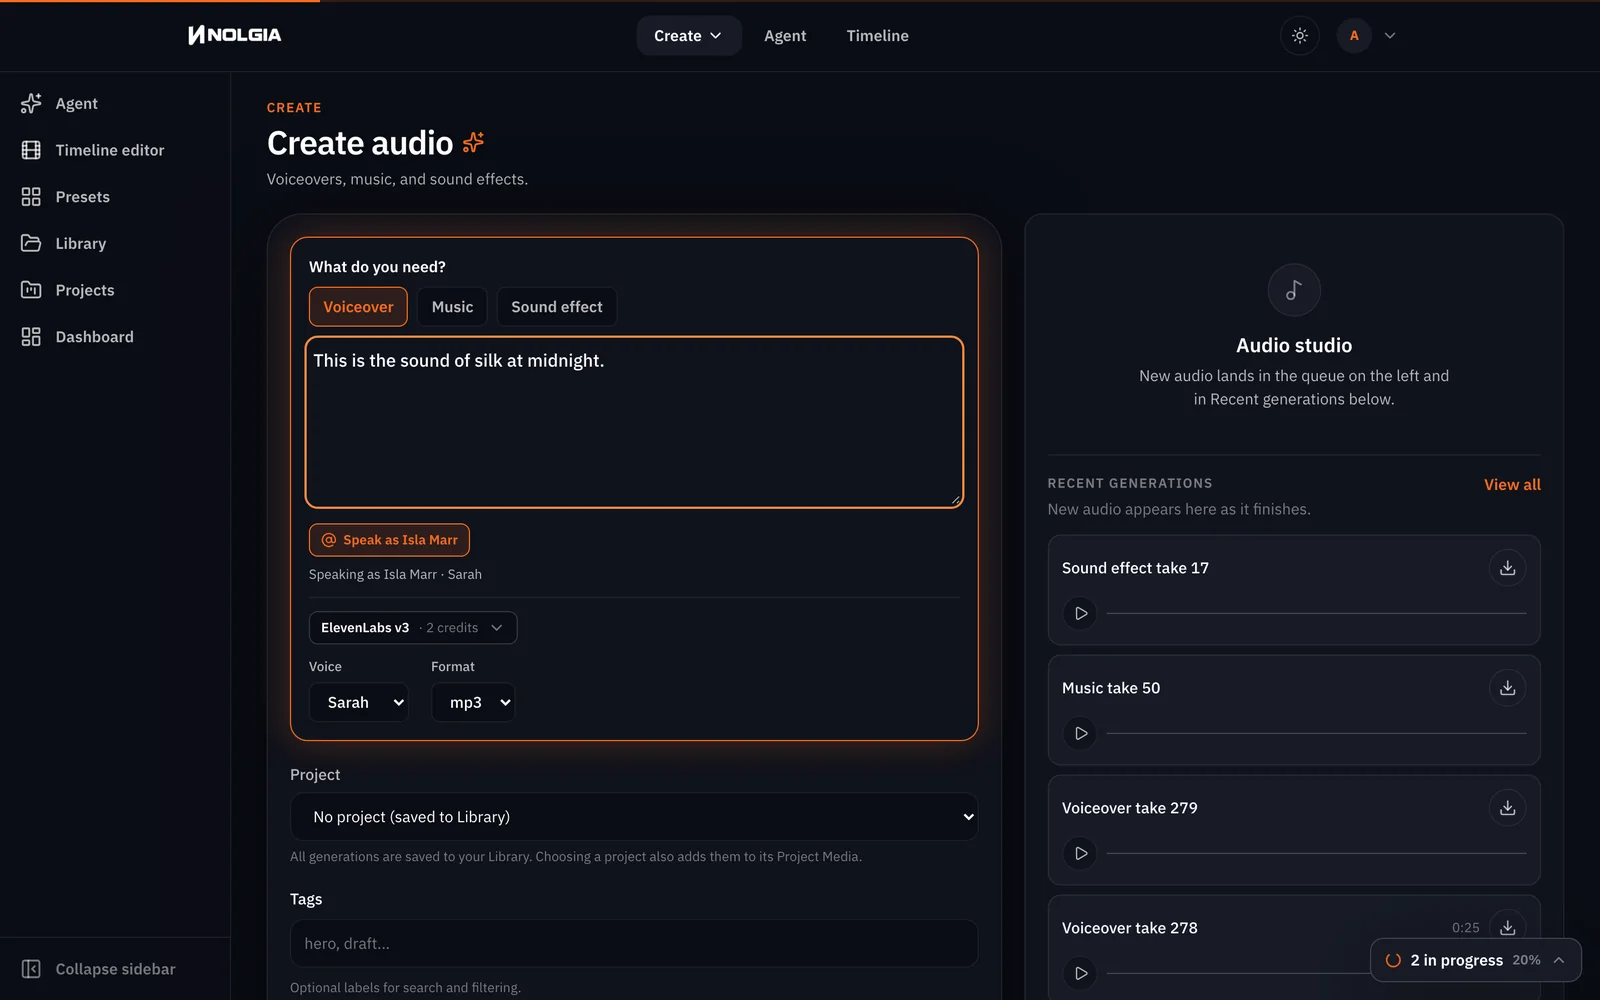
This is the sound of silk at midnight.Nothing here was built to stand still.You already know the ending. Wear it anyway.Atención:Si la nota indica que la voz no está disponible. Hablar como comprueba que el modelo guardado sigue publicando la voz guardada. Si una voz sale del catálogo, la nota te indica que elijas otra en la página de Personajes en lugar de leer con una sustituta.
Pon una base y una señal bajo la voz
Una línea sola suena vacía. Crea una base musical en la tarea Música del compositor de audio y una señal de sonido en Efecto de sonido, y luego construye la línea de tiempo de cada clip en Studio: Timelines, Nueva línea de tiempo, y en la pestaña Biblioteca del panel izquierdo, el clip con su +, la toma en el cabezal de reproducción donde empieza la línea, la base y la señal.
Consejo:Studio atenúa la base bajo la voz. Una línea de tiempo creada hoy se mezcla al exportar: la música baja unos 12 dB mientras alguien habla, la base hace un fundido de salida al final y el volumen se iguala. Para ajustar el nivel tú mismo, selecciona un sonido y abre el inspector de Audio: Volumen del clip, Fundido de entrada y Fundido de salida, Atenuar bajo la voz, y el Volumen de la pista de la pista. Nuestras tres líneas de tiempo se editaron antes de que Studio tuviera esas funciones, así que elegimos en su lugar un pasaje suave de cada base: pide al modelo de música dinámicas fuertes, reproduce la pista en la Vista previa de origen, pulsa Marcar entrada donde un compás completo lleva a un pasaje suave, Marcar salida cinco segundos después, y pulsa + con el cabezal de reproducción en 0. Así la línea tiene espacio sin un descenso audible.
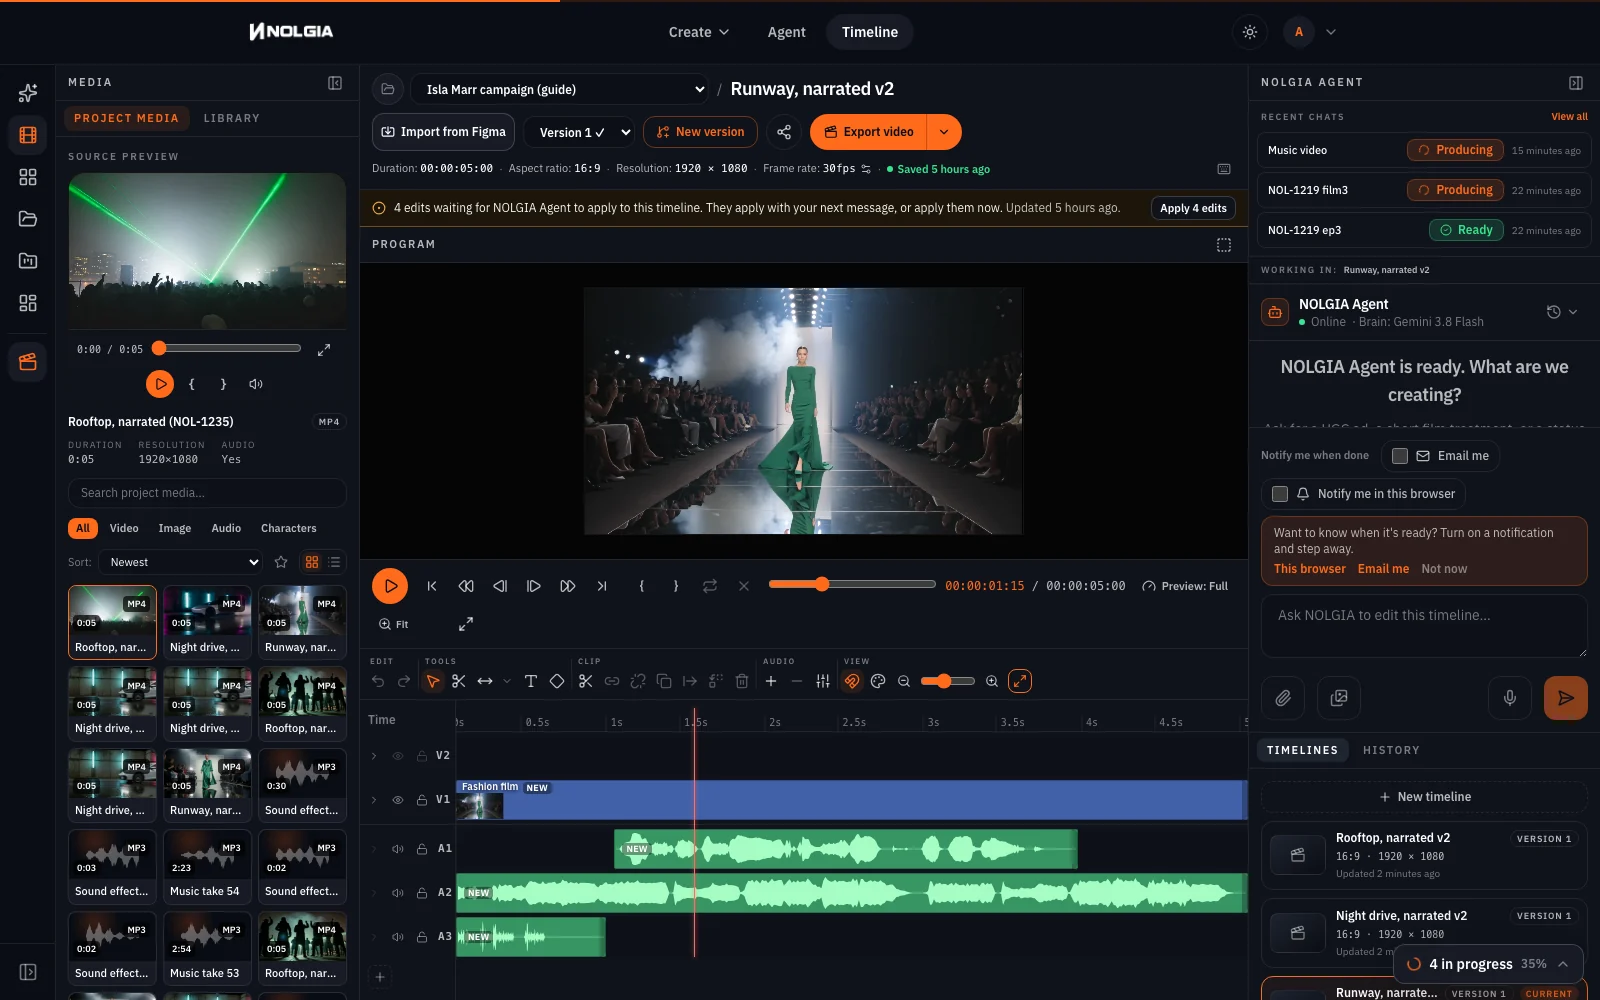
Sleek fashion-show runway track, 120 bpm, deep kick and a crisp clicking hi-hat, glossy synth stabs, instrumental, no vocals. Strong dynamics: two seconds of the full groove, then four seconds of a hushed, near-silent filtered pulse, then the full groove slams back in, and that shape repeats through the track.Dark synthwave night-drive track, 100 bpm, driving analog bass arpeggio, gated snare, cold pads, instrumental, no vocals. Strong dynamics: two seconds of the full drive, then four seconds of a sparse, hushed passage with only a low filtered bass, then the full drive returns, and that shape repeats through the track.Warehouse rave build for a rooftop party at night, 128 bpm, instrumental, no vocals: a soft muffled kick and a quiet rising filtered riser that builds for five seconds, then a huge drop with open hi-hats and a big supersaw lead, and that quiet build and big drop repeat through the track.Las señales son una línea corta cada una en ElevenLabs Sound Effects v2, recortadas con Mark Out para que no interfieran con la voz: obturadores de cámara durante el primer segundo de la pasarela, el motor y el agua tras la frase de la conducción, y un grito de multitud cuando cae el confeti de la azotea. Pulsa reproducir: la voz es la misma en los tres casos porque el modelo y la voz fueron la misma solicitud cada vez, y se sitúa por encima de la música.
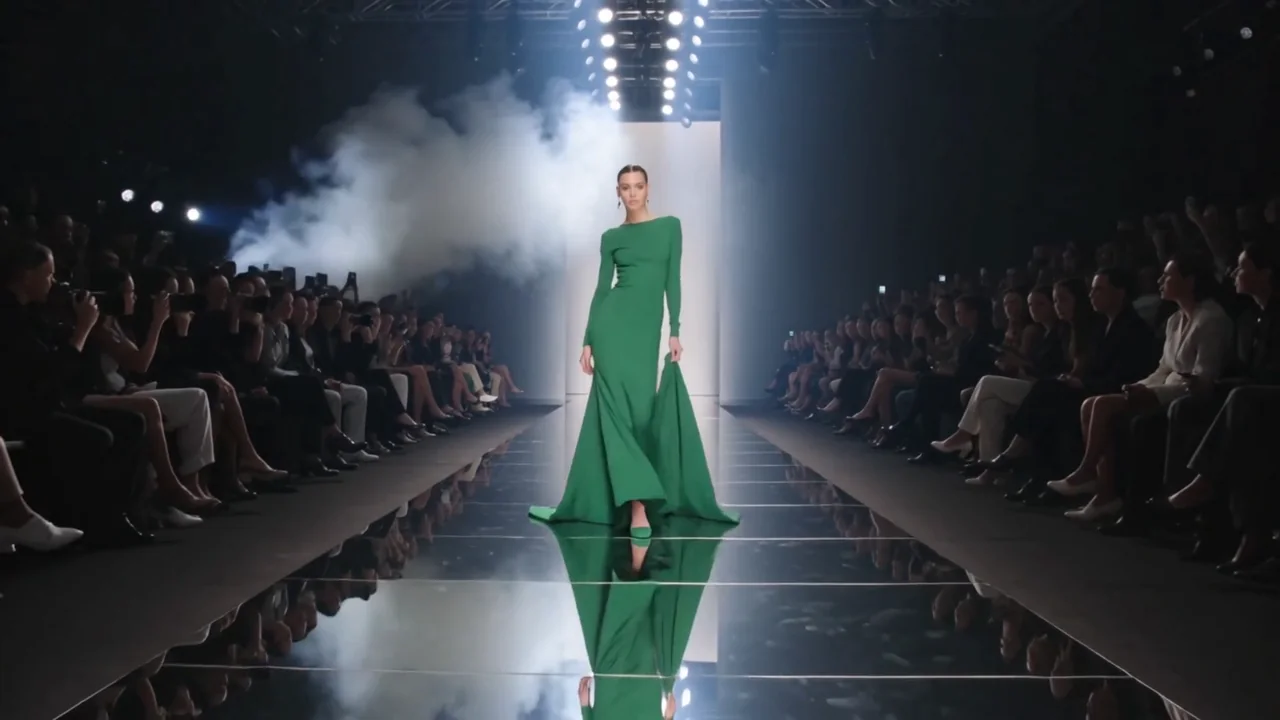
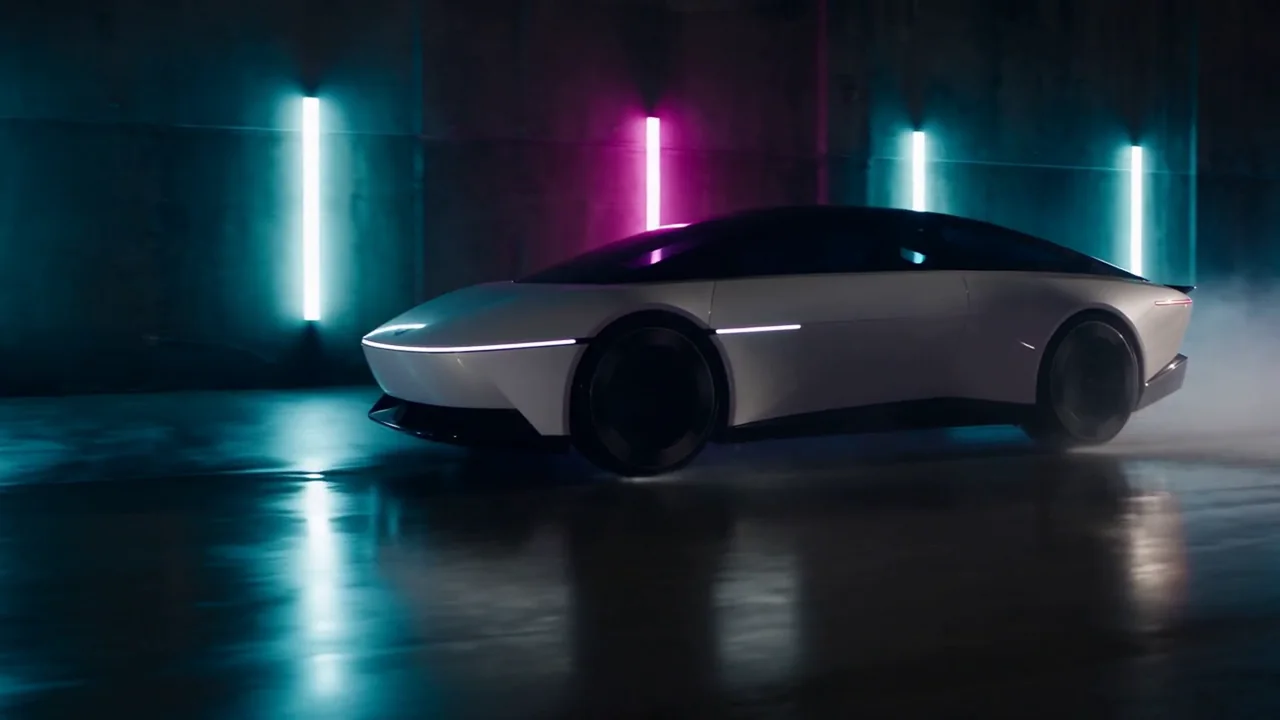
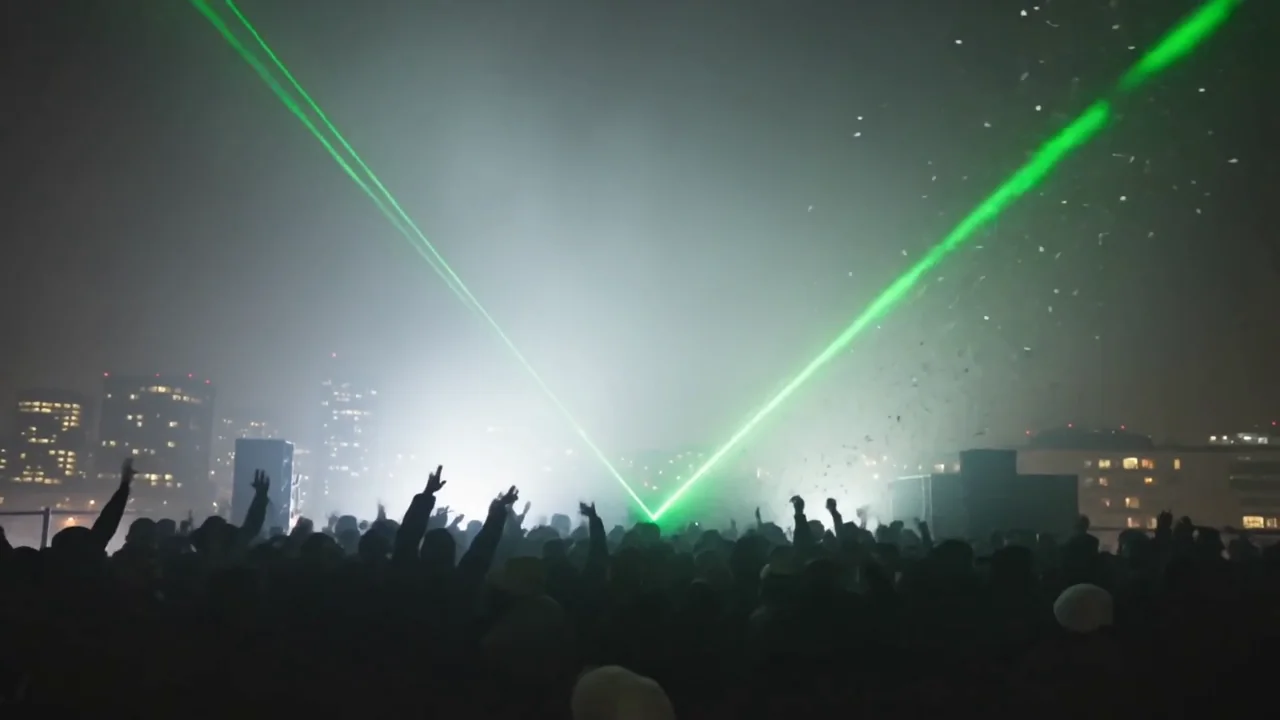
Medimos cada exportación: ningún silencio superior a medio segundo, y la voz al menos 3 dB por encima de todo lo demás mientras ella habla. Esas líneas de tiempo mezclaban todas las pistas al mismo nivel, así que estos números provienen de los pasajes que elegimos, no de un ajuste.
Tres formas de hacerlo
| Ruta | Cómo | Ideal cuando |
|---|---|---|
| Más rápido | Compositor de audio, Hablar como, una frase a la vez | Unas pocas frases para un montaje que estás haciendo ahora |
| Sin intervención | Dale instrucciones al NOLGIA Agent con el nombre del personaje; puede listar tus personajes y generar audio con la voz guardada | Una serie de episodios a partir de un guion |
| Máximo control | La API: POST /generate/audio con el id del personaje, o la herramienta MCP nolgia_text_to_audio desde tu propio código | Narración por lotes desde un documento o un flujo de trabajo |
La ruta de la API está documentada en Personajes y localizaciones: la voz de un personaje se utiliza en la generación de audio con el id del personaje, y en la generación de vídeo cuando solicitas la voz del personaje. Para esta guía, probamos la ruta del compositor, no las otras dos.
Dónde aún tienes que regenerar
- La entrega aún varía un poco. Misma voz, mismo modelo, pero cada toma es una nueva lectura. Si una frase suena plana, ejecútala de nuevo; la voz no cambiará.
- Una base musical que aún tapa una palabra. La exportación baja el volumen de la música bajo la voz, pero un pasaje fuerte aún puede saturar una frase. Baja el Volumen del clip de la base musical en el inspector de Audio, o mueve Marcar entrada a un pasaje más silencioso.
- Tu propia voz se elige manualmente. En un plan de pago, Crear voz personalizada en la lista de voces del compositor de audio clona tu voz a partir de grabaciones de 10 segundos a 5 minutos, con los modelos de voz de ElevenLabs. El diálogo de voz de la página de Personajes solo guarda voces del catálogo y clips de voz, por lo que Hablar como aún no puede usar una voz personalizada: elígela en la lista de voces cada vez. Un clip de voz en un personaje es una referencia para los modelos que aceptan una, no una voz de texto a voz.
- La velocidad es solo por API. El compositor no tiene control de velocidad actualmente.
Cuánto cuesta
Guardar una voz no cuesta nada; previsualizar una voz no cuesta nada. Cada línea factura la tarifa por carácter del modelo con un mínimo. Cada base musical y cada indicación es un cargo fijo. Los clips se han facturado por duración, y las exportaciones de Studio no se facturan.
ElevenLabs v3Every plan
Per 1,000 characters
Standard 6 créditos
Lyria 3.5Every plan
Per generation
Standard 5 créditos
Stable Audio 3 MediumEvery plan
Per generation
Standard 3 créditos
ElevenLabs SFXEvery plan
Per generation
Standard 4 créditos
Kling v3Pro and up
Per 5s clip (audio on by default)
720p 35 créditos · 1080p 47 créditos · 4K 117 créditos
Seedance 2.5Pro and up
Per 5s clip
480p 26 créditos · 720p 56 créditos · 1080p 137 créditos
1080p renders at 16:9 and 9:16
Se lee en directo del catálogo al cargar esta página. Cada precio se muestra antes de generar. Ver todas las tarifas.
Pruébalo tú mismo
El retrato del narrador
- Retrato de Isla Marr, JPEG de 1408x768Foto JPEG · 1408x768 · 483 KBDescargar
Fashion film, one continuous shot. A model in a sculpted emerald green floor-length gown with long sleeves walks down a mirrored runway toward the camera, camera strobes flashing from the crowd in silhouette on both sides, white haze, slow motion, low tracking shot moving backwards, anamorphic flares, deep blacks. No text, no logo.Premium car commercial, one continuous shot. An original concept coupe that resembles no production car: a low, wide, wedge-shaped matte white body with a single thin continuous light bar across the nose, no grille, no badges, a smooth flush glass canopy, enclosed rear wheel arches and a sharp ducktail rear. It slides sideways through a wet night street lined with bare concrete walls and plain vertical neon tubes in teal and magenta, no shop windows, no signs, no lettering anywhere. Rain streaks in the air, neon reflections stretched across the asphalt, low side tracking shot, spray from the tyres, motion blur on the passing lights, cinematic contrast.Music video, one continuous shot. A rooftop rave at night: a dense crowd in silhouette wearing long dark coats, hoodies and bucket hats, arms raised, under sharp green laser beams fanning through a thick haze layer, confetti bursting in slow motion, a city skyline of blurred lights behind them, low handheld camera looking up, backlit, high contrast. No text, no logo.Tus clips y bases no coincidirán con los nuestros; un prompt le da al modelo la escena o el ambiente, no la toma, así que busca tu propio pasaje silencioso para el Marcado de entrada. La voz coincidirá, porque el personaje la lleva.
Lista de comprobación
- El personaje existe con un nombre y una foto.
- Diálogo de voz: Voz del catálogo, un modelo con voces con nombre, vista previa reproducida, guardada.
- Compositor de audio: Hablar como muestra el personaje y la nota nombra la voz.
- Una generación por línea; revisa cada toma antes de cortar.
- Una base musical solicitada con dinámicas fuertes, y una pista por clip.
- Studio: clip, toma en el cabezal de reproducción, una ventana de base de cinco segundos de un pasaje silencioso, la pista clara de la voz, Exportar vídeo.
Preguntas y respuestas
- ¿Qué modelos pueden ser la voz de un personaje?
- Los que publican voces con nombre: los modelos de voz de ElevenLabs con diez voces y Kokoro con veinte. MiniMax Speech, Inworld, Dia y Orpheus no tienen lista de voces, por lo que el cuadro de diálogo no los ofrece.
- ¿Sonará idéntica cada toma?
- La voz y el modelo son idénticos. La lectura se genera de nuevo cada vez, por lo que el ritmo y el énfasis pueden variar ligeramente entre tomas. Vuelve a ejecutar una línea que no te guste; la voz se mantiene.
- ¿Puedo usar mi propia voz?
- Sí, en un plan de pago. En el compositor de audio, con un modelo de voz de ElevenLabs, abre la lista Voice y elige Create custom voice: graba o sube entre 10 segundos y 5 minutos de una persona hablando, confirma que es tu voz o que tienes el permiso del hablante, y a partir de entonces leerá cualquier guion. Un personaje aún no puede llevar una voz personalizada, así que elígela en la lista Voice. Un clip de voz en un personaje, de 3 a 30 segundos, es una referencia para los modelos que aceptan una pista de referencia.
- ¿Puede un modelo de vídeo usar la voz del personaje?
- La API tiene un interruptor para ello en la generación de vídeo. No lo probamos para esta guía, así que no describimos cómo suena.
- ¿Para qué sirve el campo de idioma?
- Una etiqueta opcional como en o en-US que se guarda con la voz, indicando lo que dice el personaje. Déjala vacía si no estás seguro.
- ¿Puede Studio bajar la música bajo la voz por mí?
- Sí. En una línea de tiempo creada hoy, la exportación reduce la música unos 12 dB mientras alguien habla, con la opción Duck under voice activada por defecto para la música. Puedes desactivarla, o ajustar tú mismo el Volumen del clip, el Fundido de entrada, el Fundido de salida y el Volumen de la pista en el inspector de Audio.
Asignar una voz a un personaje
Abrir PersonajesGuías relacionadas
Audio
Voz, música y efectos de sonido para tu vídeo
Crea una pista de narración, una base musical y un efecto de sonido en el compositor de audio, y colócalos bajo tu clip en Studio. Qué modelo hace cada trabajo y cuánto cuesta cada uno.
· 10 min de lectura
Canales
Un canal narrado sin rostro: las herramientas, el flujo de trabajo, el próximo episodio
Guion, una voz de narrador guardada, b-roll con un estilo fijo desde el compositor de vídeo, el montaje en Studio y el NOLGIA Agent para el próximo episodio. Dos episodios cortos creados de verdad.
· 12 min de lectura
Agente
El recetario del Agente NOLGIA: qué decir y qué pasa después
Diez mensajes que puedes enviar al Agente NOLGIA, lo que hace con cada uno y el preset detrás, desde fotos de producto y un set de listado hasta una puntuación de gancho y un montaje graduado.
· 6 min de lectura