

La même voix dans chaque vidéo
Un narrateur qui sonne différemment à chaque épisode n'est pas un narrateur. Enregistrez la voix sur un personnage et cessez de la choisir manuellement.
- 11 min de lecture
Traduit automatiquement de l'anglais. Lire l'original
 Voix
 Parler en tant que
 Fond sonore et signal
Ce que vous créez, dans l'ordre. Touchez-en un pour aller à son étape.
Vous gardez la même voix dans toutes vos vidéos en l'enregistrant sur un personnage. Un personnage sur NOLGIA porte une voix : un modèle de synthèse vocale et une des voix nommées de ce modèle. Lorsque vous créez une narration dans le compositeur audio, le bouton Parler en tant que sélectionne le personnage et définit le modèle et la voix sur le couple enregistré. Vous n'avez plus jamais à les choisir manuellement, ainsi une ligne enregistrée le mois prochain sera lue par la même voix qu'une ligne enregistrée aujourd'hui.
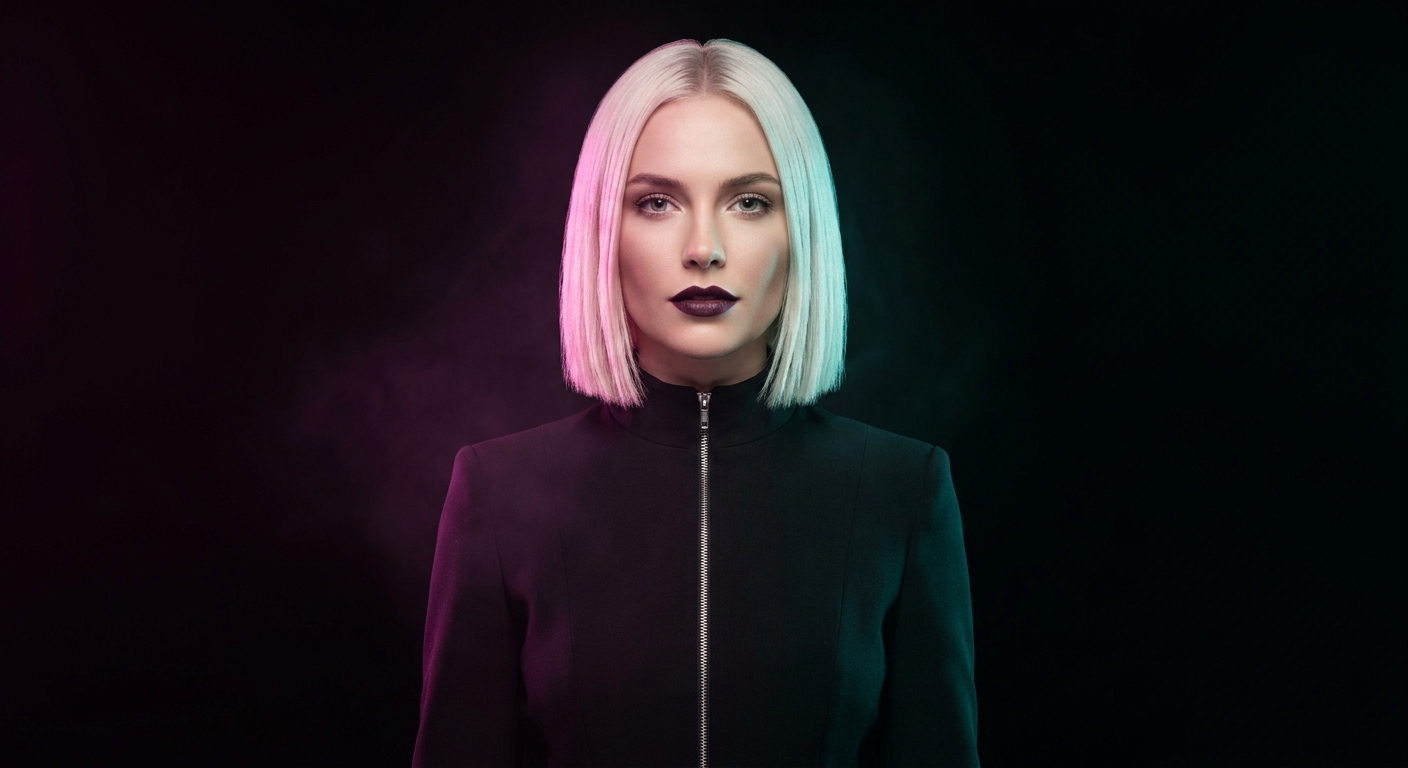
Ce guide crée un narrateur, une voix de campagne fictive que nous avons nommée Isla Marr, et lui fait lire une ligne sur trois clips sans rapport : un défilé, une conduite nocturne et une fête sur un toit. Chaque clip reçoit également une musique de fond et un effet sonore, placés sous la voix dans Studio. Chaque clip et chaque ligne sont des résultats réels ; le modèle et la voix n'ont jamais changé entre eux.
Ce qui ne va pas, et la correction
| Erreur | Pourquoi c'est problématique | Correction |
|---|---|---|
| Choisir la voix manuellement à chaque fois | Une session sur v3, la suivante sur Turbo, et le même nom se lit différemment | Enregistrez le modèle et la voix sur un personnage et utilisez Parler en tant que |
| Choisir un modèle sans liste de voix | MiniMax Speech, Inworld, Dia et Orpheus ne publient pas de voix nommées, il n'y a donc rien à épingler | Utilisez ElevenLabs ou Kokoro pour un narrateur récurrent |
| Donner au personnage un clip audio et s'attendre à une narration | La voix d'un clip est destinée aux modèles qui acceptent une piste de référence ; la synthèse vocale nécessite une voix du catalogue | Définissez une voix du catalogue pour la narration, un clip uniquement si un modèle vidéo le demande |
| Modifier la vitesse pour chaque prise | Même voix, rythme différent, cela donne l'impression de deux personnes différentes | Ne changez pas la vitesse ; adaptez plutôt le script au clip |
| Réécrire la phrase pour qu'elle ressemble davantage à la voix | La voix est fixe ; ce sont les mots qui sont la variable | Écrivez pour la voix que vous avez enregistrée et gardez une longueur de phrase constante |
Avant de commencer
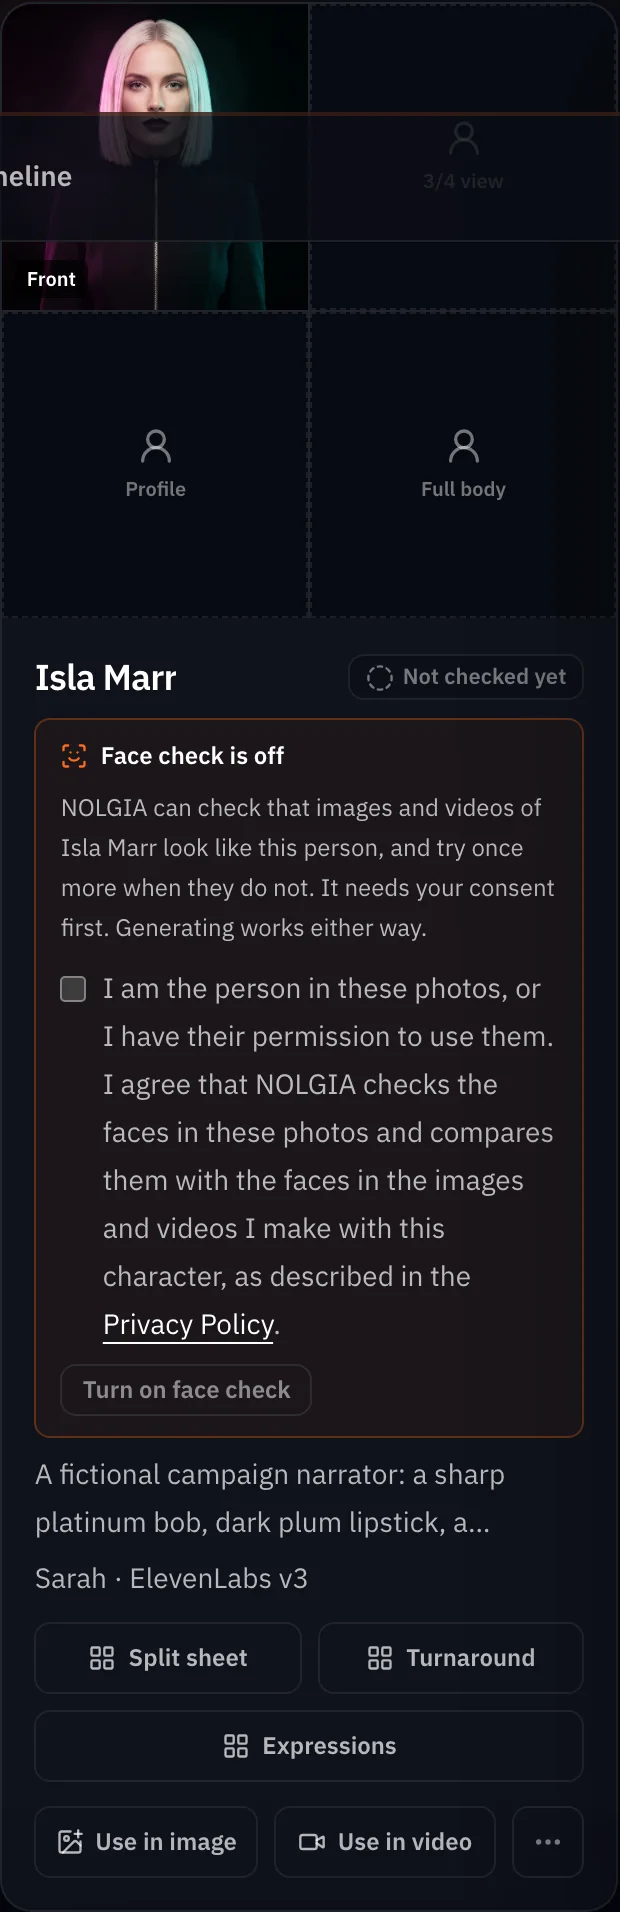
- Un personnage sur la page Personnages. Pour en créer un, il faut un nom et au moins une photo : appuyez sur Ajouter des images de référence, importez la photo, nommez le personnage et appuyez sur Créer le personnage. Le nôtre est un portrait généré, aucune personne réelle n'est impliquée.
- Un modèle de synthèse vocale avec des voix nommées. La boîte de dialogue Voix ne liste que celles-ci : les modèles ElevenLabs et Kokoro.
- Les clips que vous souhaitez narrer, dans votre Bibliothèque. Les nôtres sont trois clips de cinq secondes sans son : la piste d'envol et le toit sur Kling v3, la conduite nocturne sur Seedance 2.5.
Enregistrer la voix sur le personnage
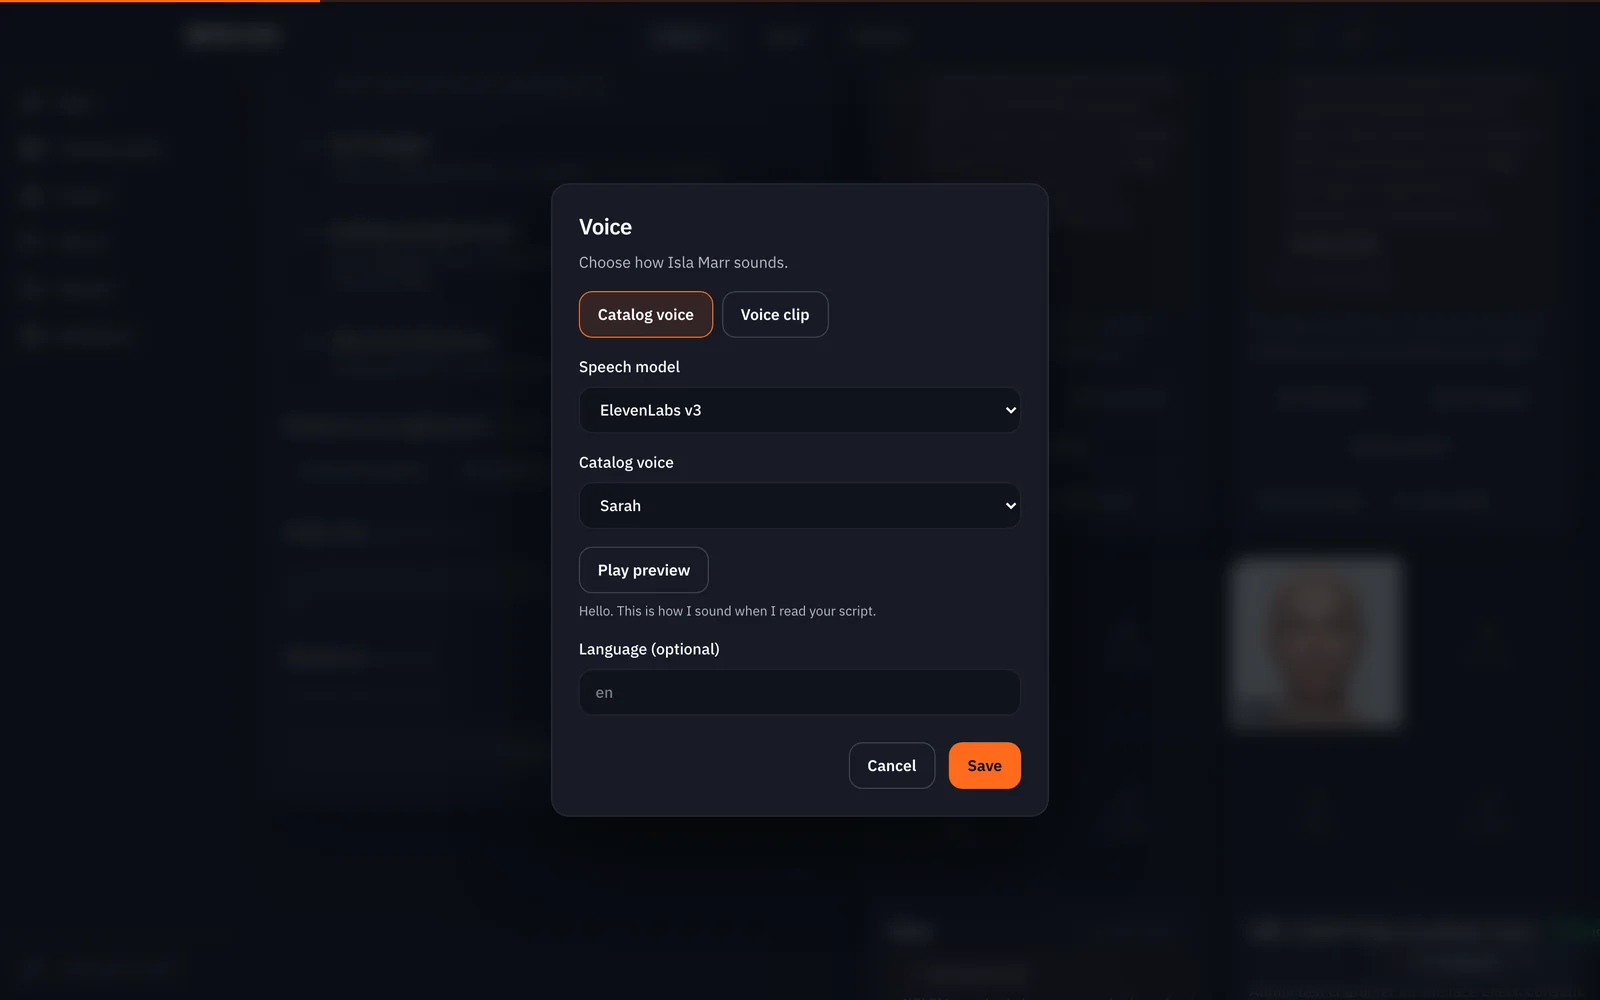
Sur la page Personnages, ouvrez le menu ... sur la carte du personnage et choisissez Voix. La boîte de dialogue propose deux types : Voix du catalogue et Extrait de voix. Conservez Voix du catalogue. Sélectionnez le Modèle vocal, puis la Voix du catalogue ; un bouton Écouter l’aperçu diffuse gratuitement un échantillon enregistré de cette voix. Ajoutez une langue si vous le souhaitez, puis cliquez sur Enregistrer. La carte affiche désormais la voix sous la description.
Narrer avec Parler en tant que
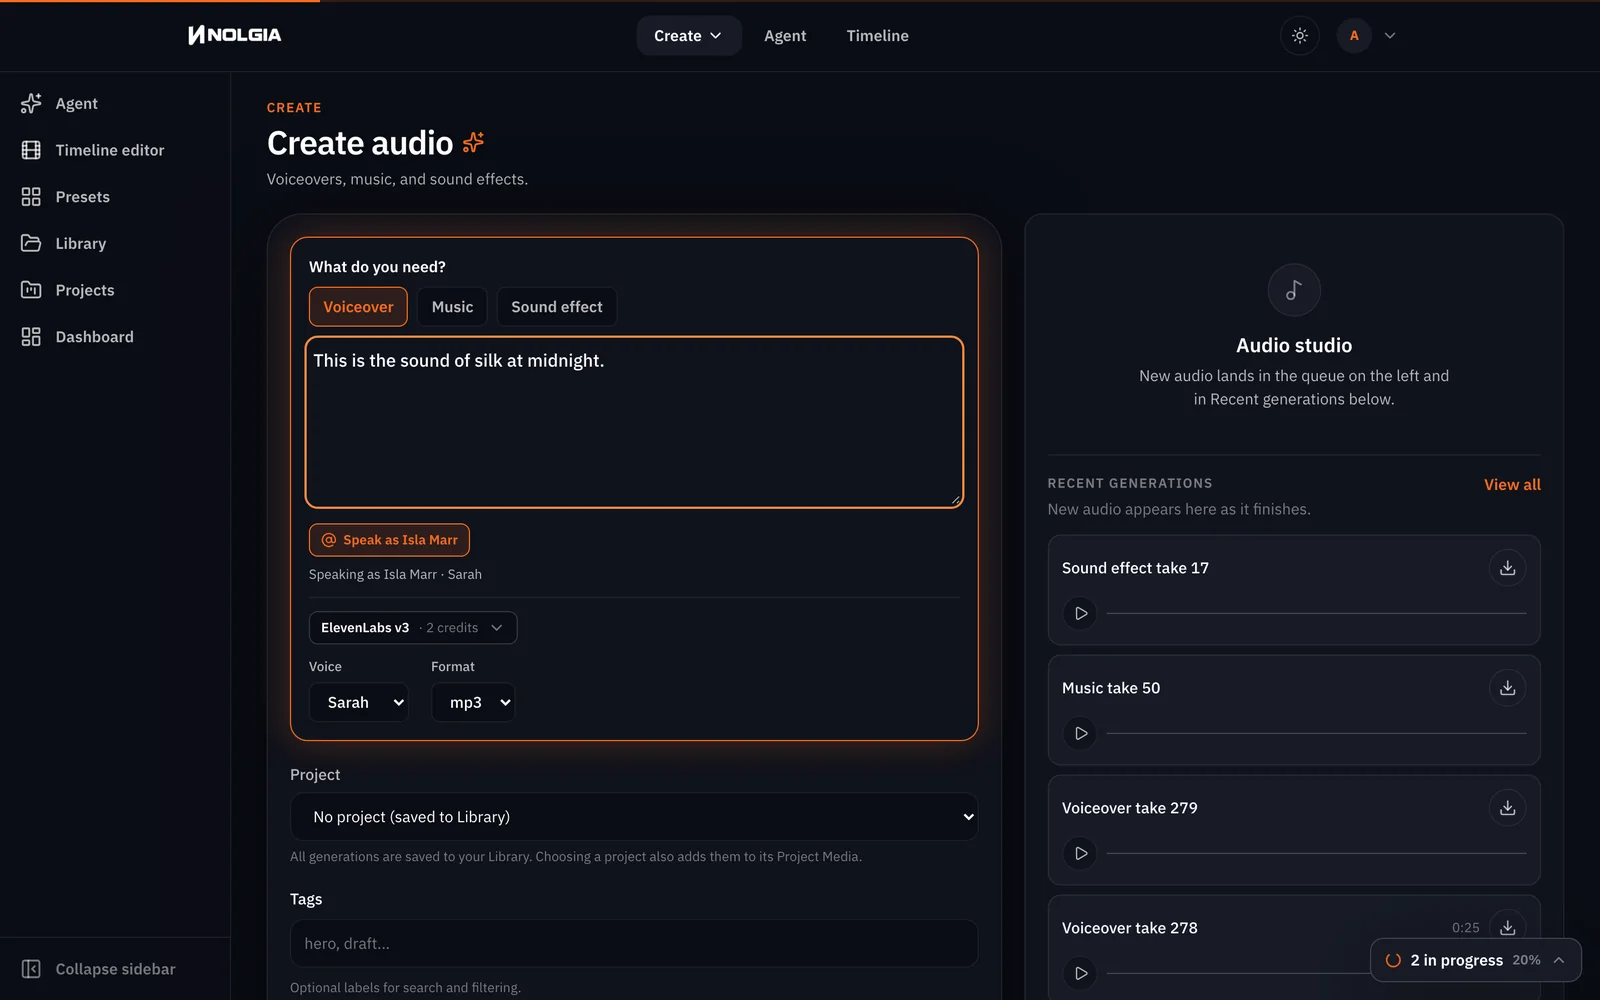
Ouvrez le composeur audio sur la tâche Voiceover et appuyez sur Parler en tant que. Choisissez le personnage. Le sélecteur de modèle passe au modèle enregistré et la liste des voix à la voix enregistrée, et une ligne sous le bouton le confirme : Speaking as Isla Marr · Sarah. Tapez la réplique et appuyez sur Générer de l’audio. Nous avons répété cette opération cinq fois de suite pour deux guides, et le couple n’a jamais bougé.
This is the sound of silk at midnight.Nothing here was built to stand still.You already know the ending. Wear it anyway.Attention :Si la note indique que la voix est indisponible. Parler en tant que vérifie que le modèle enregistré publie toujours la voix enregistrée. Si une voix quitte le catalogue, la note vous invite à en choisir une autre sur la page Characters plutôt que de lire avec une voix de substitution.
Ajoutez un fond sonore et un signal sous la voix
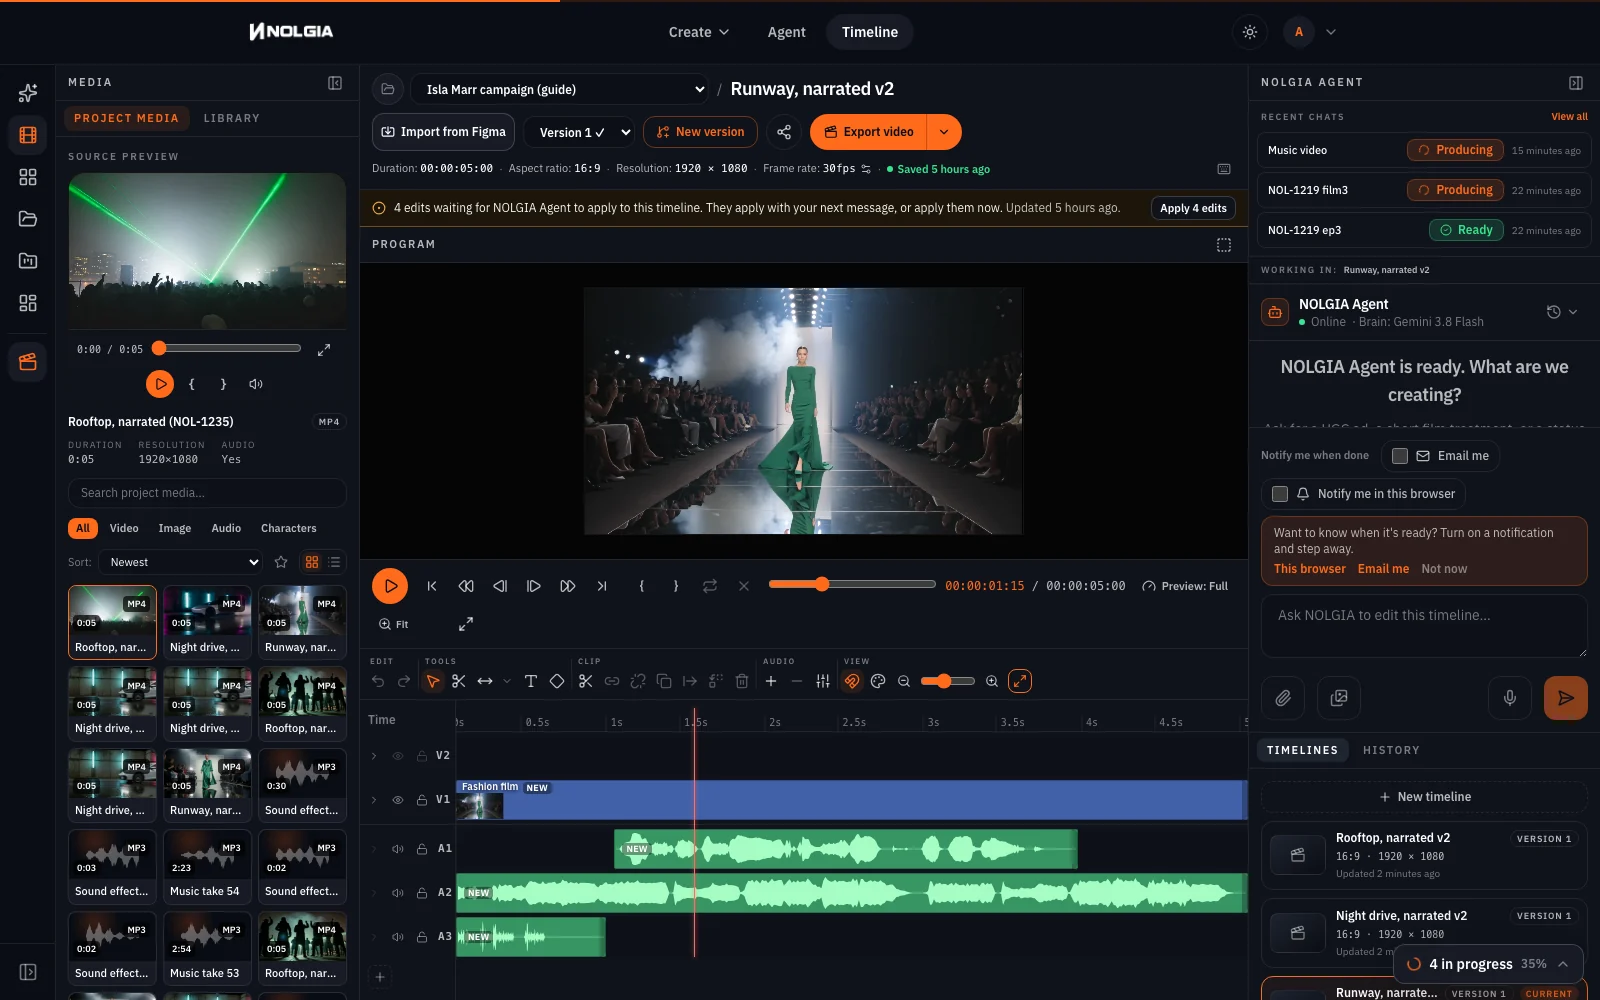
Une ligne seule paraît nue. Créez un fond musical dans la tâche Musique du compositeur audio et un effet sonore dans Effet sonore, puis construisez la timeline de chaque clip dans Studio : Timelines, Nouvelle timeline, et dans l’onglet Bibliothèque du panneau de gauche, le clip avec son +, la prise au niveau de la tête de lecture où la ligne commence, le fond musical et l’effet sonore.
Astuce :Studio atténue le fond musical sous la voix. Une timeline créée aujourd’hui est mixée à l’exportation : la musique baisse d’environ 12 dB pendant que quelqu’un parle, le fond musical s’estompe à la fin et le volume est normalisé. Pour définir vous-même un niveau, sélectionnez un son et ouvrez l’inspecteur Audio : Volume du clip, Fondu d’entrée et Fondu de sortie, Atténuer sous la voix, et le Volume de la piste de la piste. Nos trois timelines ont été montées avant que Studio ne dispose de ces fonctions, nous avons donc choisi un passage discret de chaque fond musical : demandez au modèle de musique des dynamiques fortes, écoutez la piste dans l’Aperçu source, appuyez sur Point d’entrée là où une mesure complète mène à un passage discret, Point de sortie cinq secondes plus tard, et appuyez sur + avec la tête de lecture à 0. Cela laisse encore de l’espace à la ligne sans atténuation audible.
Sleek fashion-show runway track, 120 bpm, deep kick and a crisp clicking hi-hat, glossy synth stabs, instrumental, no vocals. Strong dynamics: two seconds of the full groove, then four seconds of a hushed, near-silent filtered pulse, then the full groove slams back in, and that shape repeats through the track.Dark synthwave night-drive track, 100 bpm, driving analog bass arpeggio, gated snare, cold pads, instrumental, no vocals. Strong dynamics: two seconds of the full drive, then four seconds of a sparse, hushed passage with only a low filtered bass, then the full drive returns, and that shape repeats through the track.Warehouse rave build for a rooftop party at night, 128 bpm, instrumental, no vocals: a soft muffled kick and a quiet rising filtered riser that builds for five seconds, then a huge drop with open hi-hats and a big supersaw lead, and that quiet build and big drop repeat through the track.Les indications sont des lignes courtes sur ElevenLabs Sound Effects v2, découpées avec Mark Out pour ne pas gêner la voix : obturateurs d'appareil photo pour la première seconde du défilé, moteur et embruns après la réplique de la balade, et acclamations de la foule lorsque les confettis du rooftop tombent. Appuyez sur lecture : la voix est la même dans les trois cas car le modèle et la voix étaient identiques à chaque demande, et elle se situe au-dessus de la musique.
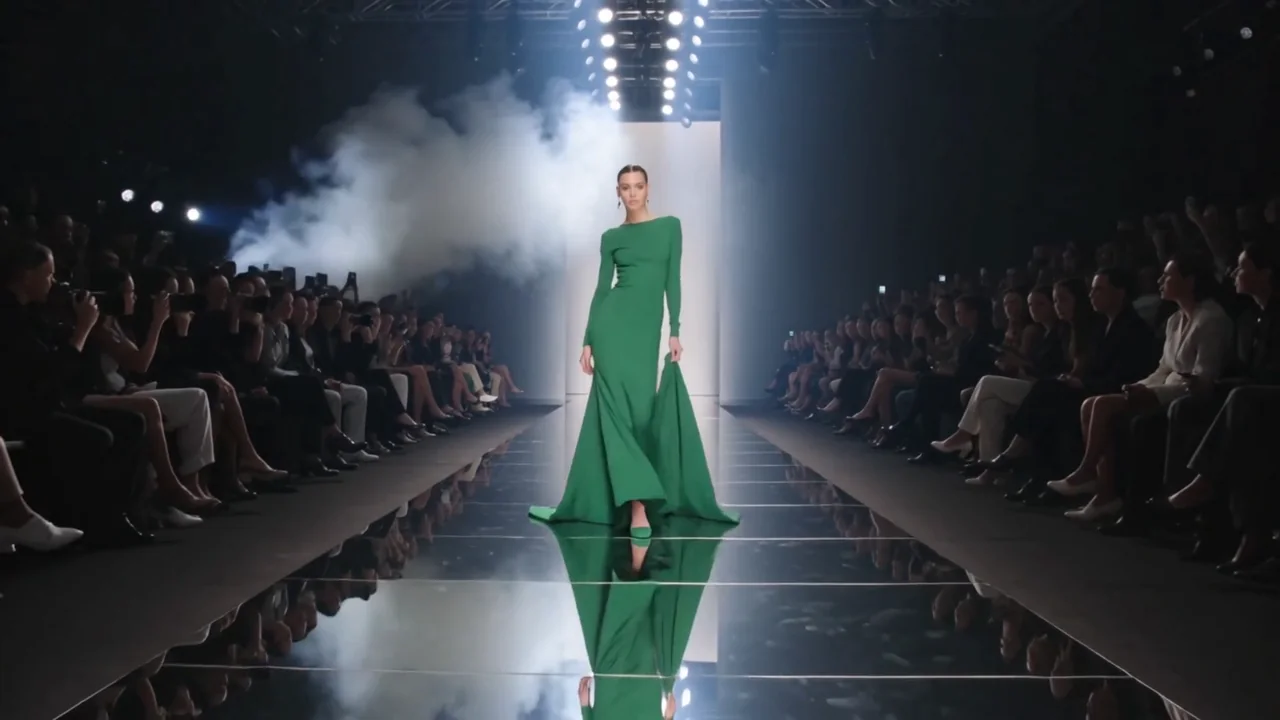
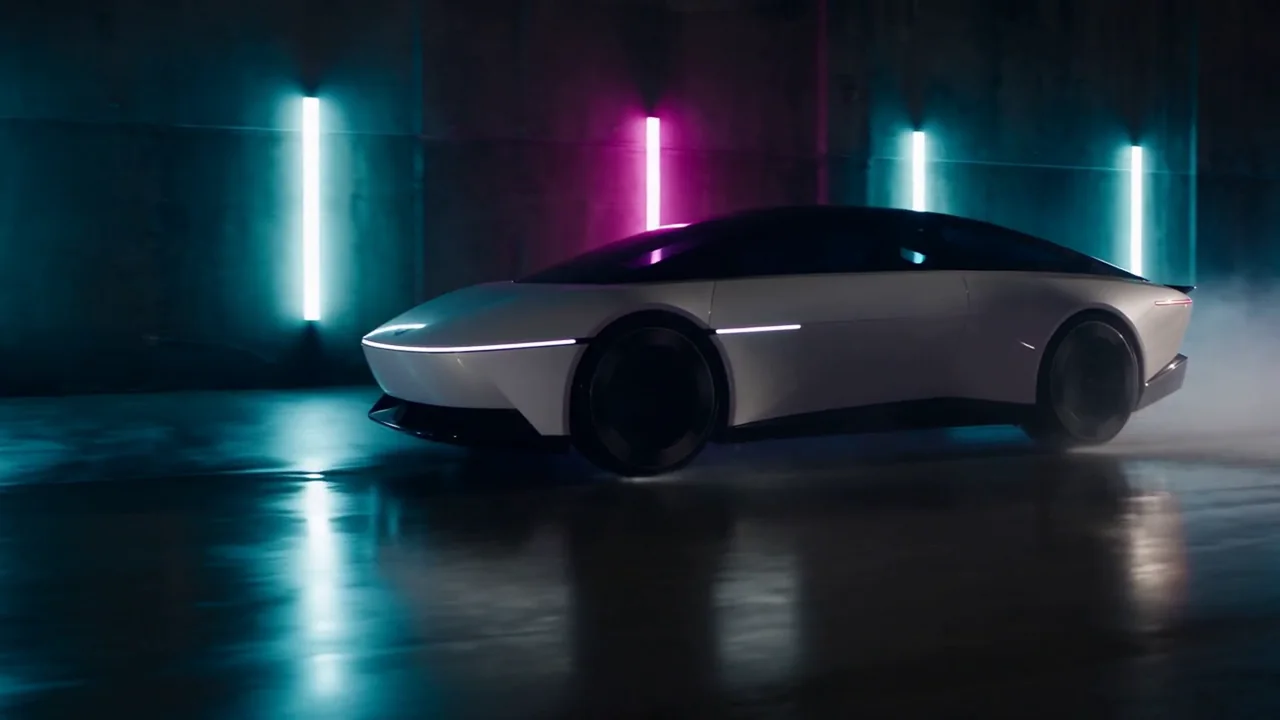
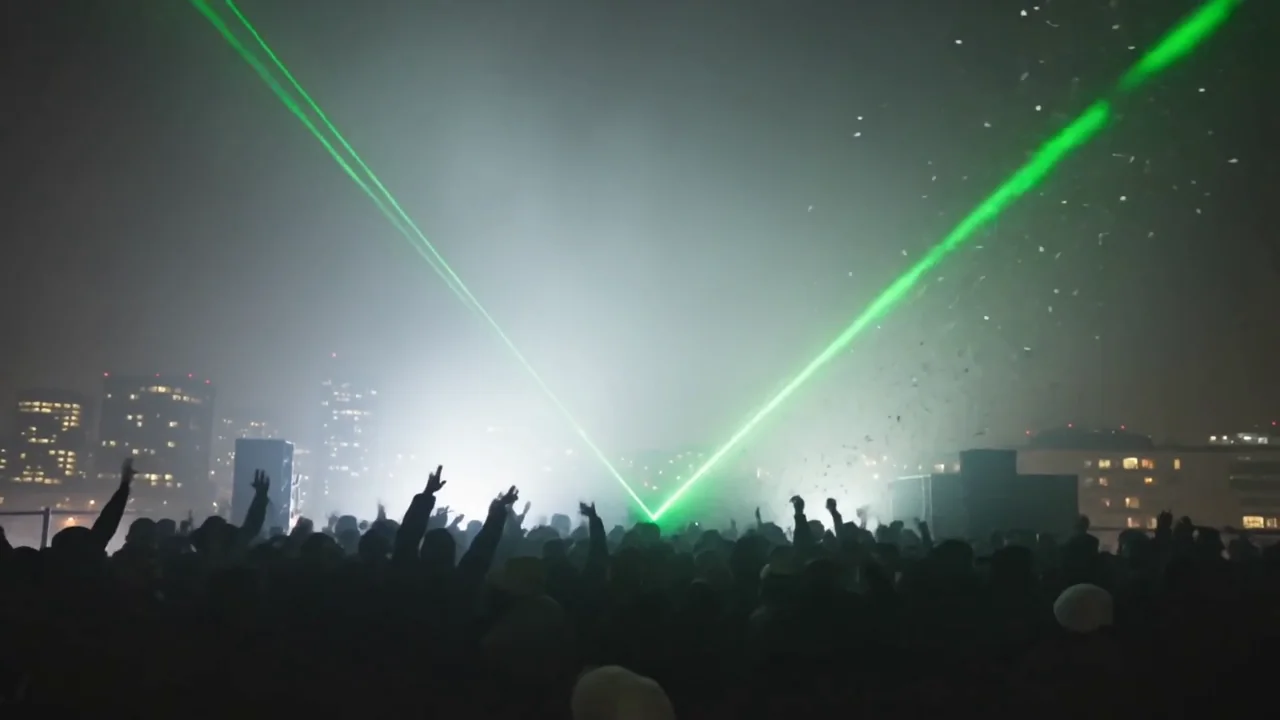
Nous avons mesuré chaque exportation : aucun silence de plus d'une demi-seconde, et la voix au moins 3 dB au-dessus de tout le reste pendant qu'elle parle. Ces timelines mixaient toutes les pistes au même niveau, donc ces chiffres proviennent des passages que nous avons choisis, et non d'un réglage.
Trois façons de le faire
| Voie | Comment | Idéal quand |
|---|---|---|
| Le plus rapide | Compositeur audio, Parler comme, une réplique à la fois | Quelques répliques pour un montage en cours |
| Sans intervention | Donnez des instructions au NOLGIA Agent avec le nom du personnage ; il peut lister vos personnages et générer de l'audio avec la voix enregistrée | Une série d'épisodes à partir d'un script |
| Le plus de contrôle | L'API : POST /generate/audio avec l'identifiant du personnage, ou l'outil MCP nolgia_text_to_audio depuis votre propre code | Narration par lots à partir d'un document ou d'un pipeline |
La voie API est documentée dans Personnages et lieux : la voix d'un personnage est utilisée par la génération audio avec l'identifiant du personnage, et par la génération vidéo lorsque vous demandez la voix du personnage. Nous avons suivi la voie du compositeur pour ce guide, pas les deux autres.
Où vous régénérez encore
- La livraison varie encore un peu. Même voix, même modèle, mais chaque prise est une nouvelle lecture. Si une ligne est plate, relancez-la ; la voix ne bougera pas.
- Un fond sonore qui couvre encore un mot. L'exportation abaisse la musique sous la voix, mais un passage fort peut encore gêner une ligne. Baissez le Volume du clip du fond sonore dans l'inspecteur Audio, ou déplacez Marque Début vers un passage plus calme.
- Votre propre voix est sélectionnée manuellement. Sur un plan payant, Créer une voix personnalisée dans la liste Voice du compositeur audio clone votre voix à partir d'enregistrements de 10 secondes à 5 minutes, sur les modèles de parole ElevenLabs. La boîte de dialogue de voix de la page Characters ne sauvegarde que les voix du catalogue et les extraits de voix, donc Speak as ne peut pas encore utiliser une voix personnalisée : choisissez-la dans la liste Voice à chaque fois. Un extrait de voix sur un personnage est une référence pour les modèles qui en acceptent une, pas une voix de synthèse vocale.
- La vitesse est disponible uniquement via l'API. Le compositeur n'a pas de contrôle de vitesse aujourd'hui.
Ce que cela coûte
Sauvegarder une voix ne coûte rien ; la prévisualiser ne coûte rien. Chaque ligne facture le tarif par caractère du modèle avec un minimum. Chaque fond musical et chaque séquence sont facturés à un tarif forfaitaire. Les clips étaient facturés selon leur durée, et les exports Studio ne sont pas facturés.
ElevenLabs v3Every plan
Per 1,000 characters
Standard 6 crédits
Lyria 3.5Every plan
Per generation
Standard 5 crédits
Stable Audio 3 MediumEvery plan
Per generation
Standard 3 crédits
ElevenLabs SFXEvery plan
Per generation
Standard 4 crédits
Kling v3Pro and up
Per 5s clip (audio on by default)
720p 35 crédits · 1080p 47 crédits · 4K 117 crédits
Seedance 2.5Pro and up
Per 5s clip
480p 26 crédits · 720p 56 crédits · 1080p 137 crédits
1080p renders at 16:9 and 9:16
Lu en direct dans le catalogue au chargement de cette page. Chaque prix est affiché avant que vous ne génériez. Voir tous les tarifs.
Essayez-le vous-même
Le portrait du narrateur
- Portrait d'Isla Marr, JPEG 1408x768Photo JPEG · 1408x768 · 483 KBTélécharger
Fashion film, one continuous shot. A model in a sculpted emerald green floor-length gown with long sleeves walks down a mirrored runway toward the camera, camera strobes flashing from the crowd in silhouette on both sides, white haze, slow motion, low tracking shot moving backwards, anamorphic flares, deep blacks. No text, no logo.Premium car commercial, one continuous shot. An original concept coupe that resembles no production car: a low, wide, wedge-shaped matte white body with a single thin continuous light bar across the nose, no grille, no badges, a smooth flush glass canopy, enclosed rear wheel arches and a sharp ducktail rear. It slides sideways through a wet night street lined with bare concrete walls and plain vertical neon tubes in teal and magenta, no shop windows, no signs, no lettering anywhere. Rain streaks in the air, neon reflections stretched across the asphalt, low side tracking shot, spray from the tyres, motion blur on the passing lights, cinematic contrast.Music video, one continuous shot. A rooftop rave at night: a dense crowd in silhouette wearing long dark coats, hoodies and bucket hats, arms raised, under sharp green laser beams fanning through a thick haze layer, confetti bursting in slow motion, a city skyline of blurred lights behind them, low handheld camera looking up, backlit, high contrast. No text, no logo.Vos clips et nappes sonores ne correspondront pas aux nôtres ; un prompt donne au modèle la scène ou l'ambiance, pas la prise, donc trouvez votre propre passage feutré pour le Marquage. La voix correspondra, car le personnage la porte.
Liste de contrôle
- Le personnage existe avec un nom et une photo.
- Boîte de dialogue Voix : Voix du catalogue, un modèle avec des voix nommées, prévisualisation jouée, enregistré.
- Compositeur audio : Parler comme affiche le personnage et la note nomme la voix.
- Une génération par ligne ; vérifiez chaque prise avant de couper.
- Une nappe sonore demandée avec de fortes dynamiques, et une indication musicale par clip.
- Studio : clip, prise à la tête de lecture, une fenêtre de nappe de cinq secondes à partir d'un passage feutré, l'indication musicale dégagée de la voix, Exporter la vidéo.
Questions et réponses
- Quels modèles peuvent servir de voix pour un personnage ?
- Ceux qui publient des voix nommées : les modèles de synthèse vocale ElevenLabs avec dix voix et Kokoro avec vingt. MiniMax Speech, Inworld, Dia et Orpheus n'ont pas de liste de voix, donc la boîte de dialogue ne les propose pas.
- Chaque prise sonnera-t-elle de manière identique ?
- La voix et le modèle sont identiques. La lecture elle-même est générée à chaque fois, donc le rythme et l'accentuation peuvent varier légèrement entre les prises. Relancez une ligne que vous n'aimez pas ; la voix reste la même.
- Puis-je utiliser ma propre voix ?
- Oui, avec un abonnement payant. Dans le compositeur audio, sur un modèle de synthèse vocale ElevenLabs, ouvrez la liste Voice et choisissez Create custom voice : enregistrez ou importez 10 secondes à 5 minutes d'une personne parlant, confirmez qu'il s'agit de votre voix ou que vous avez la permission du locuteur, et elle lira n'importe quel script par la suite. Un personnage ne peut pas encore porter une voix personnalisée, donc sélectionnez-la dans la liste Voice. Un clip vocal sur un personnage, de 3 à 30 secondes, sert de référence pour les modèles qui acceptent une piste de référence.
- Un modèle vidéo peut-il utiliser la voix du personnage ?
- L'API dispose d'une option pour cela lors de la génération vidéo. Nous ne l'avons pas testée pour ce guide, donc nous ne décrivons pas le résultat sonore.
- À quoi sert le champ de langue ?
- Une balise facultative telle que en ou en-US, enregistrée avec la voix, indiquant la langue parlée par le personnage. Laissez-la vide si vous n'êtes pas sûr.
- Studio peut-il baisser la musique sous la voix pour moi ?
- Oui. Sur une timeline créée aujourd'hui, l'exportation abaisse la musique d'environ 12 dB lorsqu'une personne parle, avec l'option Duck under voice activée par défaut pour la musique. Vous pouvez la désactiver, ou définir vous-même Clip volume, Fade in, Fade out et Track volume dans l'inspecteur Audio.
Épingler une voix à un personnage
Ouvrir CharactersGuides associés
Audio
Voix, musique et effets sonores pour votre vidéo
Créez une piste de narration, un fond musical et un effet sonore dans le compositeur audio, puis placez-les sous votre clip dans Studio. Quel modèle fait quel travail, et combien cela coûte.
· 10 min de lecture
Canaux
Une chaîne narrée sans visage : les outils, le workflow, le prochain épisode
Script, une voix de narrateur enregistrée, des plans d'illustration dans un style verrouillé depuis le compositeur vidéo, le montage dans Studio, et l'Agent NOLGIA pour le prochain épisode. Deux courts épisodes réalisés pour de vrai.
· 12 min de lecture
Agent
Le guide pratique de NOLGIA Agent : quoi dire et ce qui se passe ensuite
Dix messages que vous pouvez envoyer à NOLGIA Agent, ce qu'il fait avec chacun et le preset associé, des photos de produits et d'une série de fiches produit à un score d'accroche et un montage noté.
· 6 min de lecture