

हर वीडियो में एक ही आवाज़
हर एपिसोड में अलग आवाज़ वाला नैरेटर असली नैरेटर नहीं होता। कैरेक्टर पर आवाज़ सेव करें और इसे मैन्युअली चुनना बंद करें।
- 11 मिनट में पढ़ें
अंग्रेज़ी से अपने आप अनुवाद किया गया। मूल पढ़ें
आप एक कैरेक्टर पर वॉइस सेव करके हर वीडियो में वही आवाज़ रखते हैं। NOLGIA पर एक कैरेक्टर एक voice रखता है: एक स्पीच मॉडल और उस मॉडल की नामित आवाज़ों में से एक। जब आप audio composer में नैरेशन बनाते हैं, तो इस आवाज़ में बोलें बटन कैरेक्टर चुनता है और मॉडल और वॉइस को सेव किए गए जोड़े पर सेट करता है। आप उन्हें फिर कभी हाथ से नहीं चुनते, इसलिए अगले महीने रिकॉर्ड की गई लाइन उसी आवाज़ से पढ़ी जाती है जो आज रिकॉर्ड की गई लाइन को पढ़ती है।
यह गाइड एक नैरेटर बनाती है, एक काल्पनिक कैंपेन वॉइस जिसे हमने Isla Marr नाम दिया, और उसे तीन असंबंधित क्लिप्स पर एक लाइन पढ़वाती है: एक रनवे, एक नाइट ड्राइव और एक रूफटॉप रेव। हर क्लिप को Studio में वॉइस के नीचे एक म्यूज़िक बेड और एक साउंड क्यू भी मिलता है। हर क्लिप और हर लाइन असली आउटपुट है; उनके बीच मॉडल और वॉइस कभी नहीं बदले।
क्या गलत होता है, और ठीक करें
| गलती | यह क्यों नुकसानदायक है | **ठीक करें** |
|---|---|---|
| हर बार वॉइस हाथ से चुनना | एक सेशन v3 पर, अगला Turbo पर, और वही नाम अलग तरह से पढ़ा जाता है | मॉडल और वॉइस को एक कैरेक्टर पर सेव करें और इस आवाज़ में बोलें का उपयोग करें |
| ऐसा मॉडल चुनना जिसमें वॉइस लिस्ट न हो | MiniMax Speech, Inworld, Dia और Orpheus कोई नामित वॉइस प्रकाशित नहीं करते, इसलिए पिन करने के लिए कुछ नहीं है | दोहराए जाने वाले नैरेटर के लिए ElevenLabs या Kokoro का उपयोग करें |
| कैरैक्टर को वॉइस क्लिप देकर नैरेशन की उम्मीद करना | क्लिप वॉइस उन मॉडल्स के लिए है जो रेफरेंस ट्रैक लेते हैं; टेक्स्ट टू स्पीच के लिए कैटलॉग वॉइस की ज़रूरत होती है | नैरेशन के लिए कैटलॉग वॉइस सेट करें, क्लिप का उपयोग केवल तभी करें जब वीडियो मॉडल इसे मांगे |
| हर टेक के लिए स्पीड बदलना | एक ही वॉइस, अलग गति, दो अलग लोगों जैसा लगता है | स्पीड को न बदलें; इसके बजाय स्क्रिप्ट को क्लिप के अनुसार ढालें |
| वॉइस जैसी आवाज़ के लिए लाइन को दोबारा लिखना | वॉइस फिक्स्ड है; शब्द ही बदलने योग्य हैं | जिस वॉइस को आपने सेव किया है, उसके लिए लिखें और वाक्य की लंबाई स्थिर रखें |
शुरू करने से पहले
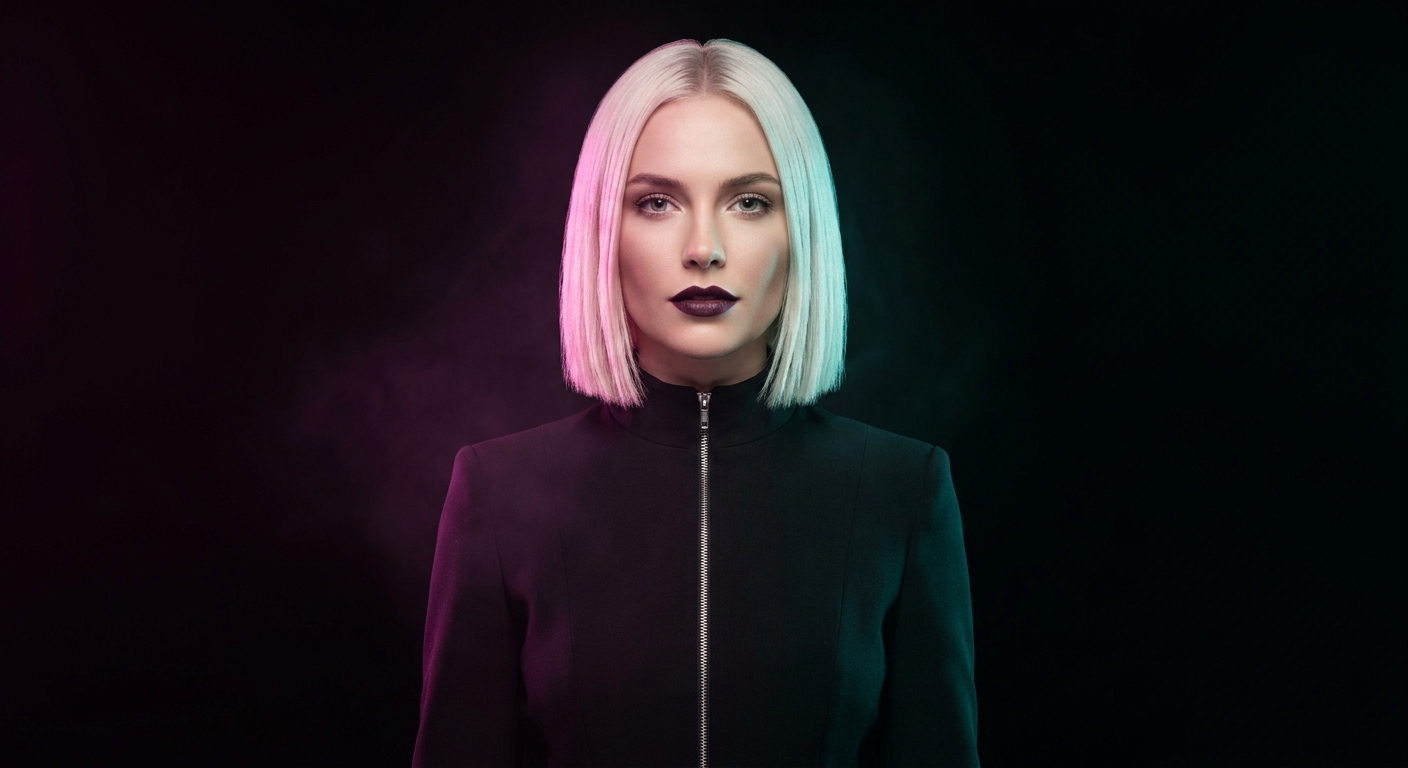
- Characters page पर एक कैरैक्टर। एक बनाने के लिए नाम और कम से कम एक फोटो की ज़रूरत होती है: रेफ़रेंस इमेज जोड़ें दबाएं, फोटो अपलोड करें, कैरैक्टर का नाम दें और कैरैक्टर बनाएं दबाएं। हमारा एक जनरेटेड पोर्ट्रेट है, इसलिए इसमें कोई वास्तविक व्यक्ति शामिल नहीं है।
- नामित वॉइस के साथ एक स्पीच मॉडल। वॉइस डायलॉग केवल उन्हीं को दिखाता है: ElevenLabs मॉडल्स और Kokoro।
- आपकी लाइब्रेररी में वे क्लिप्स जिन्हें आप नैरेट करना चाहते हैं। हमारे पास तीन पांच सेकंड की बिना आवाज़ वाली क्लिप्स हैं: Kling v3 पर रनवे और रूफटॉप, Seedance 2.5 पर नाइट ड्राइव।
कैरैक्टर पर वॉइस सेव करें
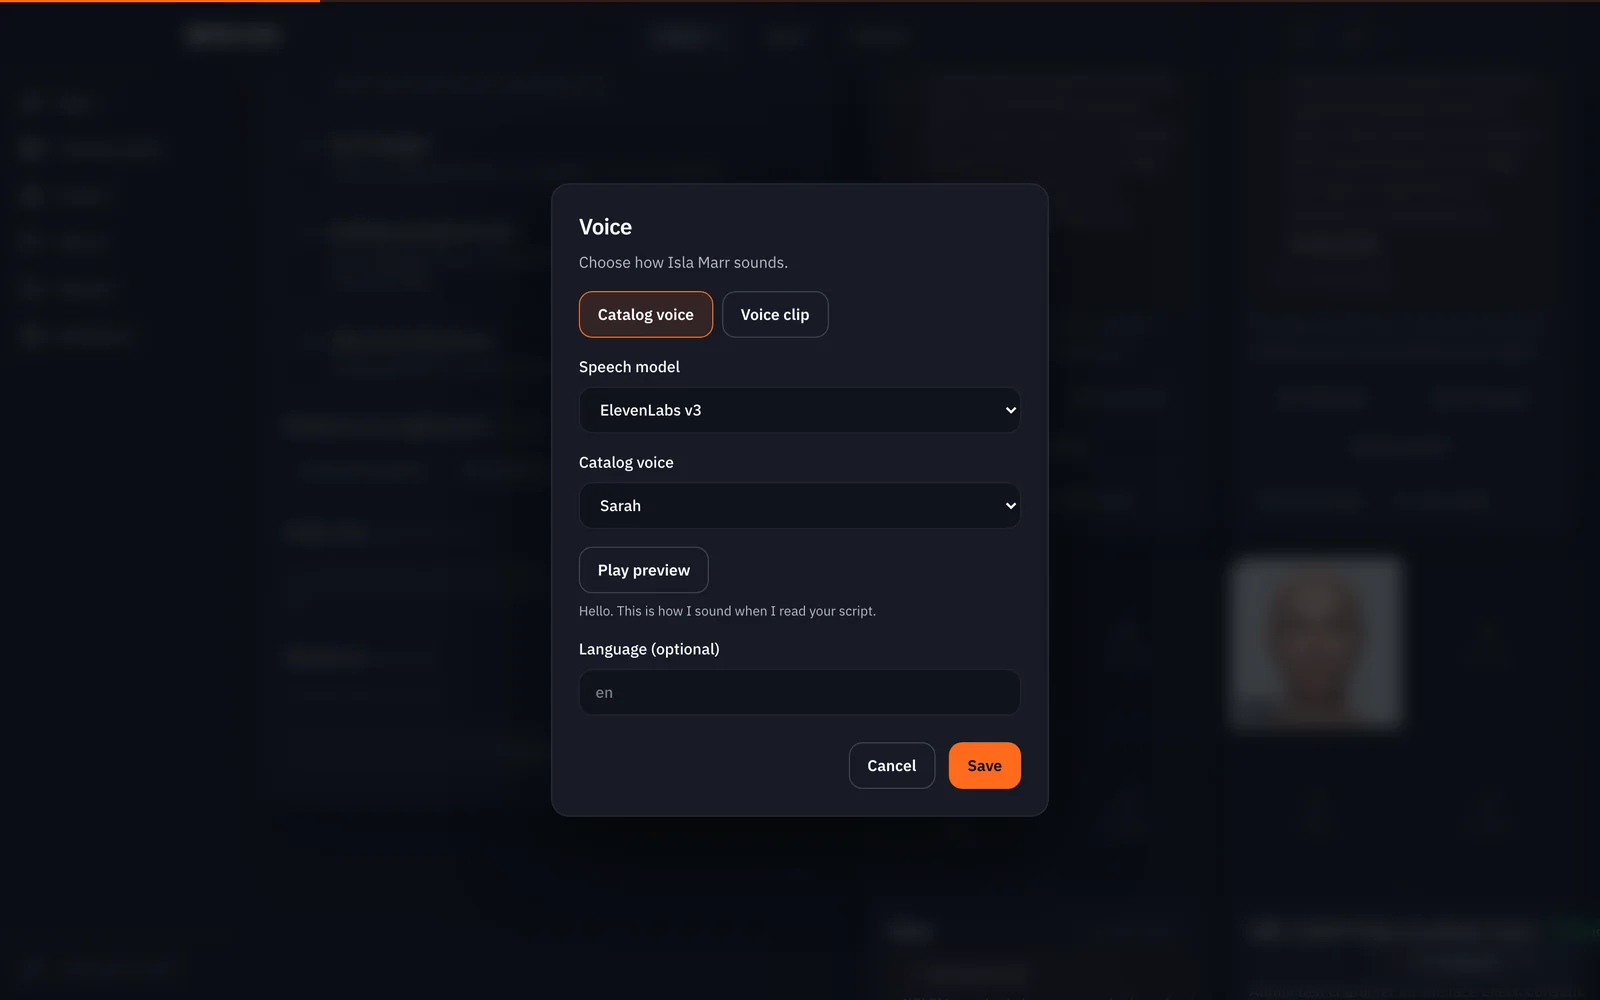
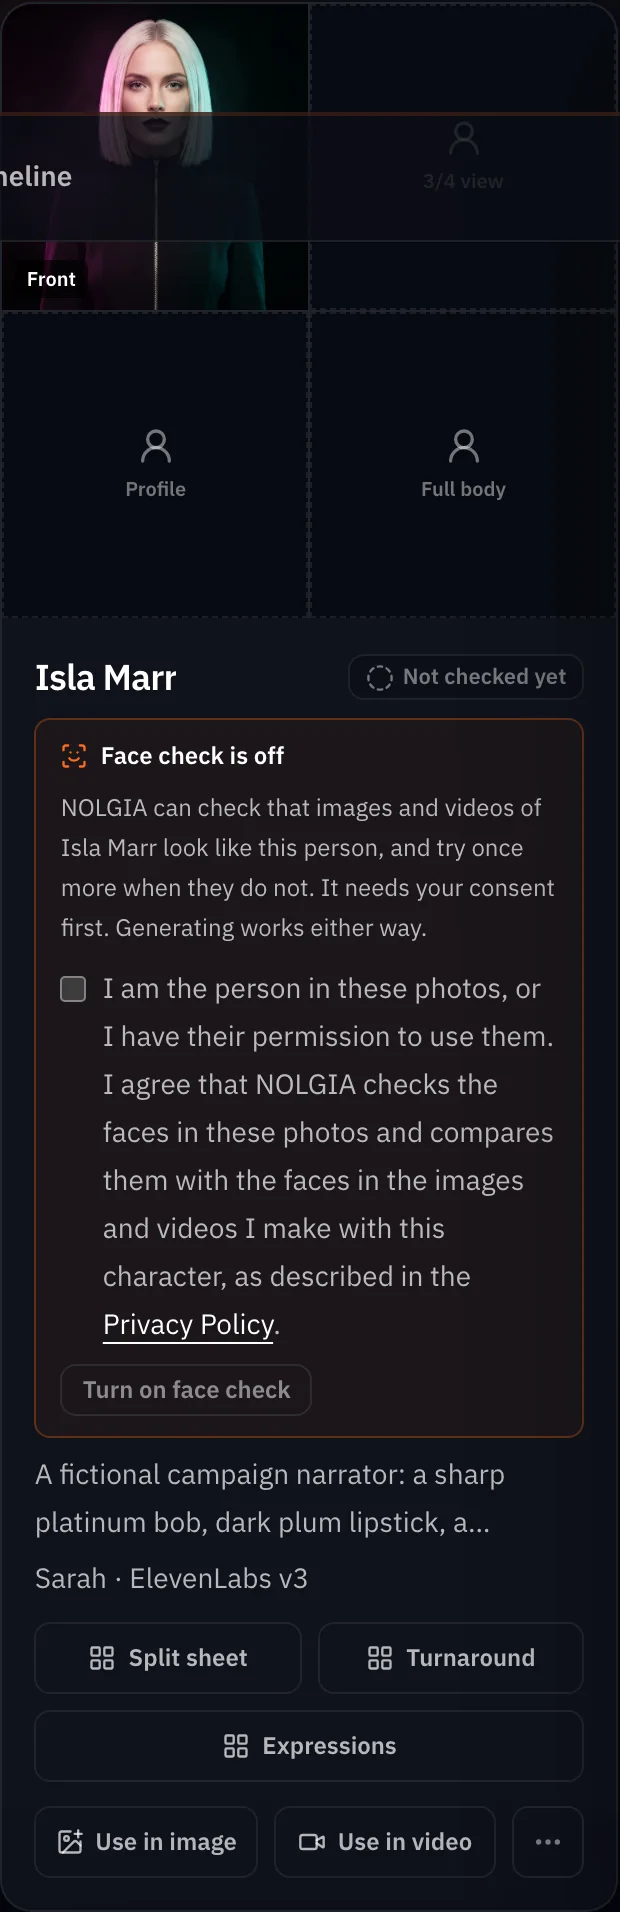
कैरेक्टर्स पेज पर, कैरेक्टर के कार्ड पर ... मेनू खोलें और वॉइस चुनें। डायलॉग दो प्रकार के विकल्प देता है: कैटलॉग वॉइस और वॉइस क्लिप। कैटलॉग वॉइस ही रखें। पहले स्पीच मॉडल चुनें, फिर कैटलॉग वॉइस; प्रीव्यू चलाएं बटन उस वॉइस का एक रिकॉर्ड किया हुआ सैंपल मुफ्त में चलाता है। यदि आप चाहें तो एक भाषा जोड़ें, फिर सेव करें। अब कार्ड में विवरण के नीचे वॉइस दिखाई देगी।
इस आवाज़ में बोलें से नैरेशन करें
Voiceover टास्क पर ऑडियो कंपोज़र खोलें और इस आवाज़ में बोलें दबाएं। कैरेक्टर चुनें। मॉडल पिकर सेव किए गए मॉडल पर और वॉइस लिस्ट सेव की गई वॉइस पर स्विच हो जाती है, और बटन के नीचे एक लाइन इसकी पुष्टि करती है: Speaking as Isla Marr · Sarah। लाइन टाइप करें और ऑडियो जनरेट करें दबाएं। हमने दो गाइड्स के लिए इसे लगातार पांच बार किया, और यह पेयर कभी नहीं बदला।
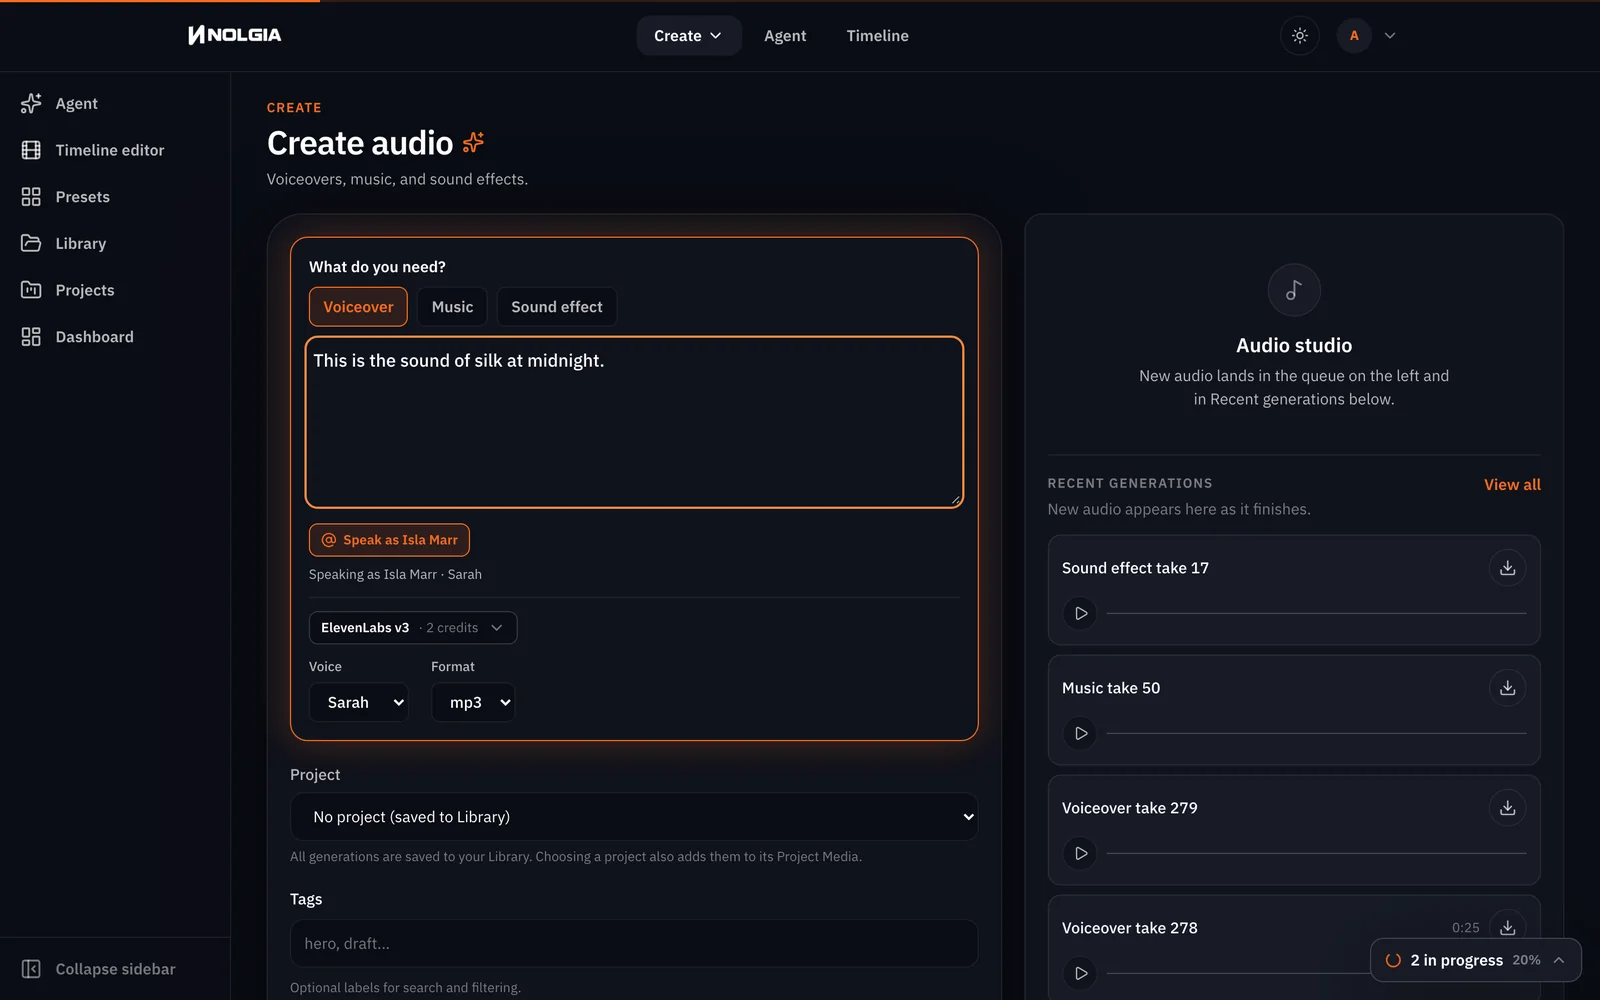
This is the sound of silk at midnight.Nothing here was built to stand still.You already know the ending. Wear it anyway.ध्यान दें:अगर नोट कहता है कि वॉइस उपलब्ध नहीं है. Speak as यह जांचता है कि सेव किया गया मॉडल अब भी सेव की गई वॉइस पब्लिश करता है या नहीं। अगर कोई वॉइस कैटलॉग से हट जाती है, तो नोट आपको Characters पेज पर कोई दूसरी वॉइस चुनने के लिए कहता है, न कि किसी स्टैंड-इन के साथ पढ़ने के लिए।
वॉइस के नीचे एक बेड और एक क्यू रखें
अकेली लाइन खाली लगती है। ऑडियो कंपोज़र के म्यूज़िक टास्क में एक म्यूज़िक बेड और साउंड इफ़ेक्ट में एक साउंड क्यू बनाएं, फिर स्टूडियो में हर क्लिप की टाइमलाइन बनाएं: टाइमलाइन्स, नई टाइमलाइन, और बाईं पैनल के लइब्रेरि टैब में + के साथ क्लिप, जहां लाइन शुरू होती है वहां प्लेहेड पर टेक, बेड, और क्यू।
सुझाव:स्टूडियो आवज़ के नीचे बेड को धीमा कर देता है. आज बनाई गई टाइमलाइन एक्सपोर्ट पर मिक्स हो जाती है: जब कोई बोलता है तो म्यूज़िक लगभग 12 dB तक गिर जाता है, अंत में बेड फ़ेड आउट होता है, और लॉउडनेस बराबर हो जाती है। खुद लेवल सेट करने के लिए, एक साउंड चुनें और ऑडियो इंस्पेक्टर खोलें: क्लिप वॉल्यूम, फ़ेड इन और फ़ेड आउट, आवज़ के नीचे धीमा करें, और लेन का ट्रैक वॉल्यूम। हमारी तीन टाइमलाइन्स तब काटी गई थीं जब स्टूडियो में ये फीचर्स नहीं थे, इसलिए हमने हर बेड का एक शांत हिस्सा चुना: म्यूज़िक मॉडल से मजबूत डायनैमिक्स मांगें, सोर्स प्रीव्यू में ट्रैक चलाएं, जहां एक पूरा बार शांत हिस्से की ओर ले जाता है वहां मार्क इन दबाएं, पांच सेकंड बाद मार्क आउट दबाएं, और प्लेहेड 0 पर रखते हुए + दबाएं। इससे लाइन को जगह मिलती है बिना सुनाई देने वाले ड्रॉप के।
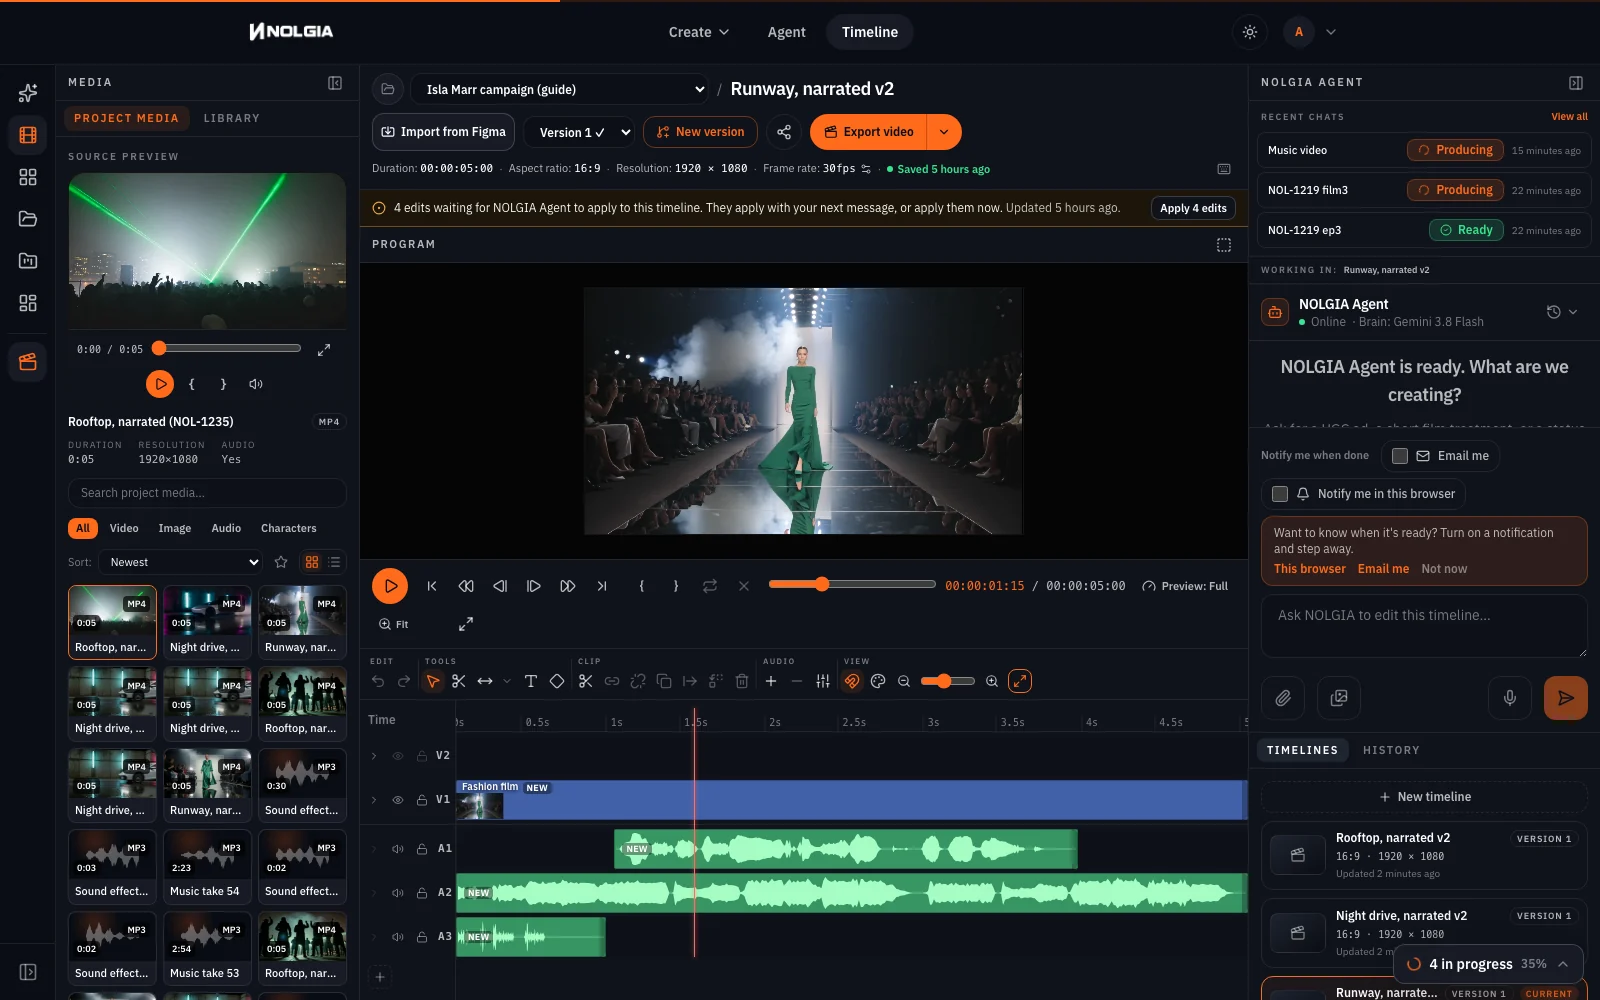
Sleek fashion-show runway track, 120 bpm, deep kick and a crisp clicking hi-hat, glossy synth stabs, instrumental, no vocals. Strong dynamics: two seconds of the full groove, then four seconds of a hushed, near-silent filtered pulse, then the full groove slams back in, and that shape repeats through the track.Dark synthwave night-drive track, 100 bpm, driving analog bass arpeggio, gated snare, cold pads, instrumental, no vocals. Strong dynamics: two seconds of the full drive, then four seconds of a sparse, hushed passage with only a low filtered bass, then the full drive returns, and that shape repeats through the track.Warehouse rave build for a rooftop party at night, 128 bpm, instrumental, no vocals: a soft muffled kick and a quiet rising filtered riser that builds for five seconds, then a huge drop with open hi-hats and a big supersaw lead, and that quiet build and big drop repeat through the track.क्यू ElevenLabs Sound Effects v2 पर एक छोटी लाइन हैं, जिन्हें Mark Out से ट्रिम किया गया है ताकि वे वॉइस से अलग रहें: रनवे के पहले सेकंड के लिए कैमरा शटर, ड्राइव की लाइन के बाद इंजन और स्प्रे, और रूफटॉप कॉन्फेटी गिरने पर भीड़ की जयकारा। प्ले दबाएं: तीनों में वॉइस एक जैसी है क्योंकि मॉडल और वॉइस हर बार एक ही रिक्वेस्ट थे, और यह म्यूजिक के ऊपर है।
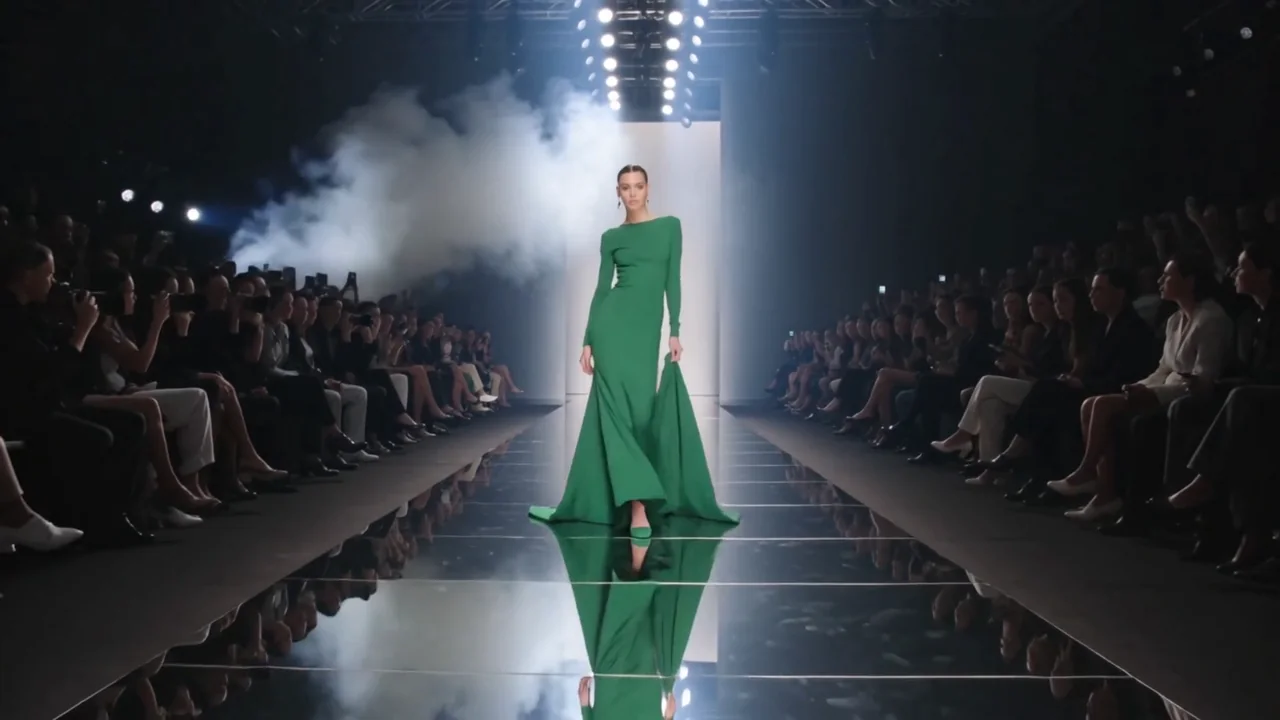
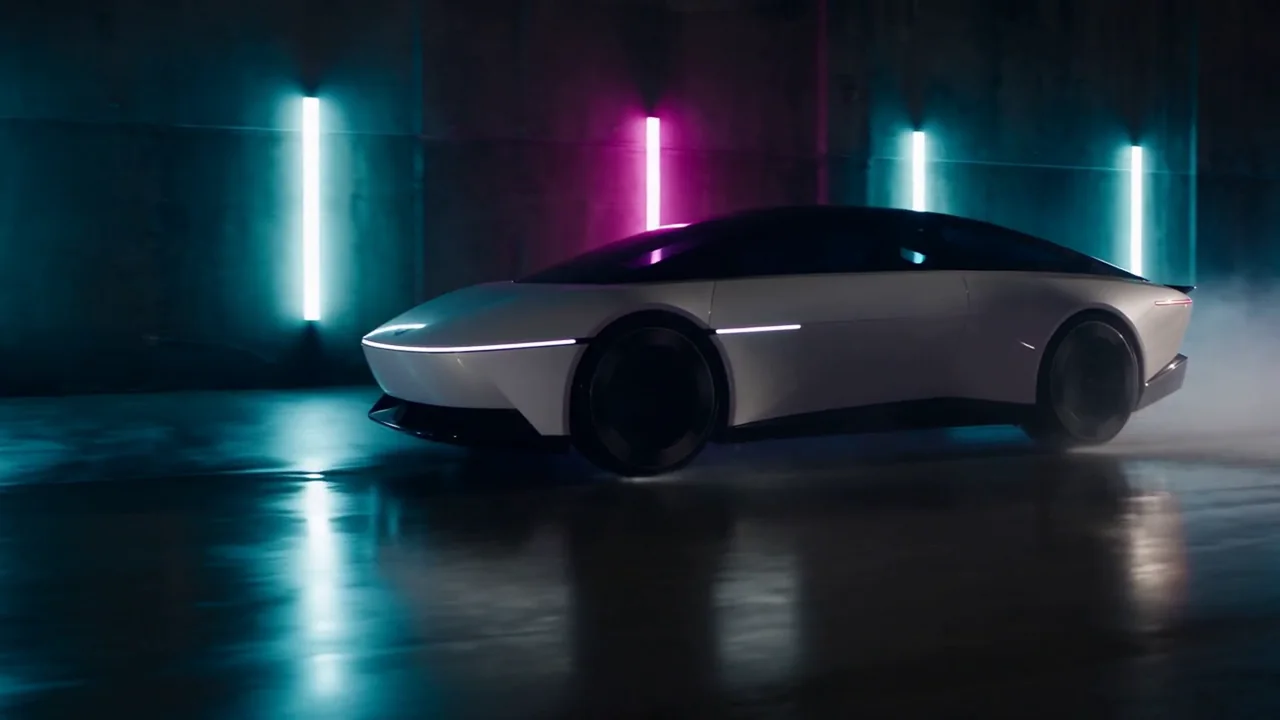
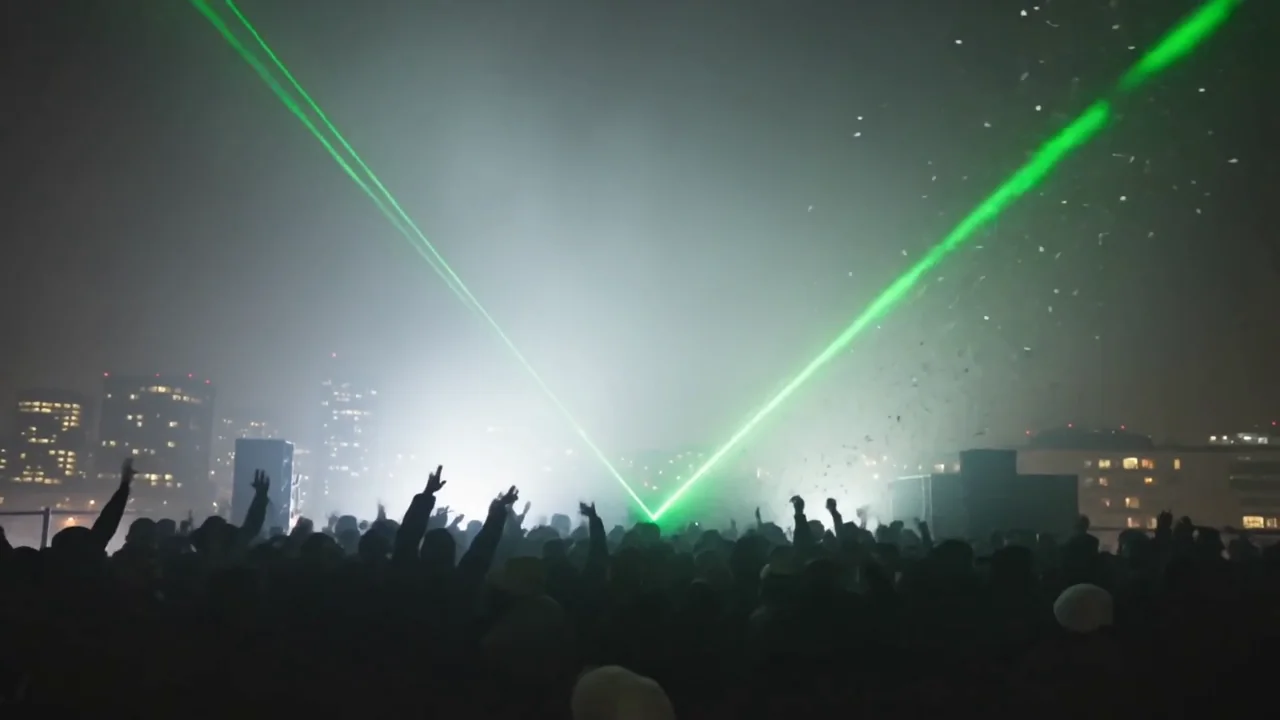
हमने हर एक्सपोर्ट को मापा: आधा सेकंड से अधिक का कोई सन्नाटा नहीं, और जब वह बोलती हैं तो आवाज़ बाकी सब कुछ से कम से कम 3 dB ऊपर। उन टाइमलाइन में हर लेन को एक ही स्तर पर मिक्स किया गया था, इसलिए ये आंकड़े हमारे द्वारा चुने गए हिस्सों से आते हैं, किसी सेटिंग से नहीं।
इसे चलाने के तीन तरीके
| पाथ | कैसे | कब सबसे अच्छा |
|---|---|---|
| सबसे तेज़ | ऑडियो कंपोजर, Speak as, एक बार में एक लाइन | अभी बनाई जा रही कट के लिए कुछ लाइनें |
| बिना हस्तक्षेप के | चरित्र के नाम के साथ NOLGIA Agent को ब्रीफ करें; यह आपके चरित्रों की सूची बना सकता है और सहेजी गई आवाज़ के साथ ऑडियो जनरेट कर सकता है | स्क्रिप्ट से एपिसोड की एक सीरीज़ |
| सबसे अधिक नियंत्रण | एपीआई: POST /generate/audio के साथ कैरेक्टर का id, या अपने कोड से nolgia_text_to_audio MCP टूल | डॉक्यूमेंट या पाइपलाइन से बैच नैरेशन |
एपीआई पाथ Characters and locations के तहत डॉक्यूमेंटेड है: कैरेक्टर की वॉइस का उपयोग ऑडियो जेनरेशन में कैरेक्टर id के साथ, और वीडियो जेनरेशन में तब होता है जब आप कैरेक्टर की वॉइस मांगते हैं। हमने इस गाइड के लिए कंपोजर पाथ चलाया, अन्य दो नहीं।
जहाँ आप अभी भी रीजनरेट करते हैं
- डिलीवरी अभी भी थोड़ी भिन्न होती है। वही वॉइस, वही मॉडल, लेकिन हर टेक एक नया रीड है। अगर कोई लाइन फ्लैट लगती है, तो उसे दोबारा चलाएं; वॉइस नहीं बदलेगी।
- एक बेड जो अभी भी एक शब्द को ढकता है। एक्सपोर्ट वॉइस के नीचे म्यूजिक को डक करता है, लेकिन एक तेज पैसेज अभी भी एक लाइन को भीड़ दे सकता है। ऑडियो इंस्पेक्टर में बेड का क्लिप वॉल्यूम कम करें, या Mark In को एक शांत पैसेज पर ले जाएं।
- आपकी अपनी आवाज़ चुनी जाती है। पेड प्लान पर, ऑडियो कंपोजर की वॉइस लिस्ट में कस्टम आवाज़ बनाएं ElevenLabs स्पीच मॉडल्स पर 10 सेकंड से 5 मिनट की रिकॉर्डिंग से आपकी आवाज़ को क्लोन करता है। कैरेक्टर्स पेज का वॉइस डायलॉग केवल कैटलॉग वॉइस और वॉइस क्लिप्स को सेव करता है, इसलिए Speak as अभी तक कस्टम वॉइस को नहीं ले जा सकता: इसे हर बार वॉइस लिस्ट में चुनें। एक कैरेक्टर पर वॉइस क्लिप उन मॉडल्स के लिए एक रेफरेंस है जो इसे स्वीकार करते हैं, यह टेक्स्ट टू स्पीच वॉइस नहीं है।
- स्पीड केवल API में है। कंपोजर में आज कोई स्पीड कंट्रोल नहीं है।
इसकी कीमत क्या है
आवाज़ सेव करना मुफ्त है; आवाज़ का प्रीव्यू देखना मुफ्त है। प्रत्येक लाइन मॉडल की प्रति कैरेक्टर दर के अनुसार न्यूनतम राशि के साथ बिल होती है। प्रत्येक म्यूजिक बेड और प्रत्येक क्यू एक फ्लैट चार्ज है। क्लिप्स की कीमत लंबाई के अनुसार थी, और Studio एक्सपोर्ट्स पर बिल नहीं लगाया जाता है।
ElevenLabs v3Every plan
Per 1,000 characters
Standard 6 क्रेडिट
Lyria 3.5Every plan
Per generation
Standard 5 क्रेडिट
Stable Audio 3 MediumEvery plan
Per generation
Standard 3 क्रेडिट
ElevenLabs SFXEvery plan
Per generation
Standard 4 क्रेडिट
Kling v3Pro and up
Per 5s clip (audio on by default)
720p 35 क्रेडिट · 1080p 47 क्रेडिट · 4K 117 क्रेडिट
Seedance 2.5Pro and up
Per 5s clip
480p 26 क्रेडिट · 720p 56 क्रेडिट · 1080p 137 क्रेडिट
1080p renders at 16:9 and 9:16
यह पेज लोड होते ही कैटलॉग से लाइव पढ़ा जाता है। जनरेट करने से पहले हर कीमत दिखाई जाती है। सभी दरें देखें.
इसे खुद आज़माएं
नैरेटर का पोर्ट्रेट
- Isla Marr पोर्ट्रेट, 1408x768 JPEGJPEG फ़ोटो · 1408x768 · 483 KBडाउनलोड करें
Fashion film, one continuous shot. A model in a sculpted emerald green floor-length gown with long sleeves walks down a mirrored runway toward the camera, camera strobes flashing from the crowd in silhouette on both sides, white haze, slow motion, low tracking shot moving backwards, anamorphic flares, deep blacks. No text, no logo.Premium car commercial, one continuous shot. An original concept coupe that resembles no production car: a low, wide, wedge-shaped matte white body with a single thin continuous light bar across the nose, no grille, no badges, a smooth flush glass canopy, enclosed rear wheel arches and a sharp ducktail rear. It slides sideways through a wet night street lined with bare concrete walls and plain vertical neon tubes in teal and magenta, no shop windows, no signs, no lettering anywhere. Rain streaks in the air, neon reflections stretched across the asphalt, low side tracking shot, spray from the tyres, motion blur on the passing lights, cinematic contrast.Music video, one continuous shot. A rooftop rave at night: a dense crowd in silhouette wearing long dark coats, hoodies and bucket hats, arms raised, under sharp green laser beams fanning through a thick haze layer, confetti bursting in slow motion, a city skyline of blurred lights behind them, low handheld camera looking up, backlit, high contrast. No text, no logo.आपकी क्लिप्स और बेड्स हमारे से मैच नहीं करेंगे; एक प्रॉम्प्ट मॉडल को सीन या मूड देता है, टेक नहीं, इसलिए Mark In के लिए अपना खुद का शांत पैसेज ढूंढें। वॉइस मैच करेगी, क्योंकि कैरेक्टर इसे कैरी करता है।
चेकलिस्ट
- कैरेक्टर एक नाम और फोटो के साथ मौजूद है।
- वॉइस डायलॉग: कैटलॉग वॉइस, नामित वॉइस वाला एक मॉडल, प्रीव्यू चलाया गया, सेव किया गया।
- ऑडियो कम्पोज़र: Speak as कैरेक्टर दिखाता है और नोट वॉइस का नाम बताता है।
- प्रति लाइन एक जेनरेशन; काटने से पहले हर टेक की जांच करें।
- मजबूत डायनैमिक्स के साथ मांगा गया एक म्यूजिक बेड, और प्रति क्लिप एक क्यू।
- Studio: क्लिप, प्लेहेड पर टेक, एक शांत पैसेज से पांच सेकंड का बेड विंडो, वॉइस से साफ क्यू, Export video।
सवाल और जवाब
- कौन से मॉडल एक कैरेक्टर की वॉइस हो सकते हैं?
- जो मॉडल नामित वॉइस (named voices) प्रकाशित करते हैं: ElevenLabs स्पीच मॉडल जिनमें दस वॉइस हैं और Kokoro जिसमें बीस हैं। MiniMax Speech, Inworld, Dia और Orpheus में वॉइस की सूची नहीं होती, इसलिए डायलॉग उन्हें नहीं दिखाता।
- क्या हर टेक (take) बिल्कुल एक जैसा सुनाई देगा?
- वॉइस और मॉडल एक जैसे होते हैं। लेकिन रीडिंग (read) हर बार नई तैयार होती है, इसलिए अलग-अलग टेक में गति और जोर थोड़ा बदल सकता है। अगर आपको कोई लाइन पसंद नहीं आई तो उसे दोबारा चलाएं; वॉइस वही रहेगा।
- क्या मैं अपनी खुद की वॉइस इस्तेमाल कर सकता हूँ?
- हाँ, पेड प्लान पर। ऑडियो कंपोजर में, किसी ElevenLabs स्पीच मॉडल पर, वॉइस लिस्ट खोलें और 'Create custom voice' चुनें: एक व्यक्ति की 10 सेकंड से 5 मिनट तक की बातचीत रिकॉर्ड करें या अपलोड करें, पुष्टि करें कि यह आपकी वॉइस है या आपको स्पीकर की अनुमति है, और फिर यह कोई भी स्क्रिप्ट पढ़ेगा। अभी एक कैरेक्टर कस्टम वॉइस नहीं रख सकता, इसलिए इसे वॉइस लिस्ट में चुनें। कैरेक्टर पर 3 से 30 सेकंड की वॉइस क्लिप उन मॉडलों के लिए एक रेफरेंस है जो रेफरेंस ट्रैक लेते हैं।
- क्या एक वीडियो मॉडल कैरेक्टर की वॉइस इस्तेमाल कर सकता है?
- वीडियो जनरेशन के लिए API में इसके लिए एक स्विच है। हमने इस गाइड के लिए इसे नहीं चलाया, इसलिए हम नहीं बता सकते कि यह कैसे सुनाई देता है।
- लैंग्वेज फील्ड का क्या उपयोग है?
- एक वैकल्पिक टैग जैसे en या en-US जो वॉइस के साथ स्टोर होता है, यह बताता है कि कैरेक्टर किस भाषा में बोलता है। यदि आप निश्चित नहीं हैं तो इसे खाली छोड़ दें।
- क्या Studio वॉइस के लिए म्यूजिक को कम कर सकता है?
- हाँ। आज बनाई गई टाइमलाइन पर, जब कोई बोल रहा होता है तो एक्सपोर्ट के दौरान म्यूजिक लगभग 12 dB तक कम हो जाता है, क्योंकि म्यूजिक के लिए 'Duck under voice' डिफ़ॉल्ट रूप से चालू होता है। आप इसे बंद कर सकते हैं, या Audio inspector में Clip volume, Fade in, Fade out और Track volume को स्वयं सेट कर सकते हैं।
किसी कैरेक्टर के लिए वॉइस पिन करें
Characters खोलेंसंबंधित गाइड
ऑडियो
आपके वीडियो के लिए वॉइस, म्यूजिक और साउंड इफेक्ट्स
ऑडियो कंपोजर में एक नैरेशन लाइन, एक म्यूजिक बेड और एक साउंड इफेक्ट बनाएं, फिर उन्हें स्टूडियो में अपने क्लिप के नीचे रखें। कौन सा मॉडल कौन सा काम करता है, और हर एक की कितनी लागत है।
· 10 मिनट में पढ़ें
चैनल
एक फेसलेस नैरेटेड चैनल: टूल्स, वर्कफ्लो, और अगला एपिसोड
स्क्रिप्ट, एक सेव किया गया नैरेटर वॉइस, वीडियो कंपोजर से लॉक्ड लुक में बी-रोल, स्टूडियो में कट, और अगले एपिसोड के लिए NOLGIA Agent। दो छोटे एपिसोड वास्तव में बनाए गए।
· 12 मिनट में पढ़ें
एजेंट
NOLGIA Agent का कुकबुक: क्या कहें, और आगे क्या होता है
दस संदेश जो आप NOLGIA Agent को भेज सकते हैं, वह हर एक के साथ क्या करता है और उसके पीछे का प्रॉम्प्ट, प्रोडक्ट फोटो और लिस्टिंग सेट से लेकर हुक स्कोर और ग्रेडेड कट तक।
· 6 मिनट में पढ़ें