

すべての動画で同じ声を使う
エピソードごとに声が異なるナレーターは、ナレーターとはいえません。キャラクターに声を保存し、手動で選択するのをやめましょう。
- 11 分で読めます
英語から自動翻訳されています。原文を読む
キャラクターに音声を保存することで、動画ごとに同じ声を維持できます。NOLGIAのキャラクターには、音声(スピーチモデルとそのモデルの指定された音声)が紐付けられています。オーディオコンポーザーでナレーションを作成する際、話す声ボタンでキャラクターを選択すると、保存されたモデルと音声のペアが自動的に設定されます。手動で選択し直す必要がなくなるため、来月録音したセリフも今日録音したセリフと同じ声で読み上げられます。
このガイドでは、架空のキャンペーンボイスとして「Isla Marr」というナレーターを作成し、ランウェイ、夜のドライブ、屋上のレイブという3つの無関係なクリップで彼女にセリフを読ませます。各クリップには、Studioで音声の下に配置されたBGMと1つの効果音も追加されています。すべてのクリップとセリフは実際の出力結果であり、モデルや音声は変更されていません。
よくある失敗と修正方法
| ミス | 問題点 | 修正 |
|---|---|---|
| 毎回手動で音声を選択する | あるセッションではv3、次ではTurboを使用すると、同じ名前でも読み上げが異なって聞こえます | モデルと音声をキャラクターに保存し、話す声を使用する |
| 音声リストがないモデルを選択する | MiniMax Speech、Inworld、Dia、Orpheusには指定された音声がないため、固定できません | 繰り返し使用するナレーターにはElevenLabsまたはKokoroを使用する |
| キャラクターに音声クリップを与えてナレーションを期待する | クリップ音声は参照トラックを受け取るモデル用です。テキスト読み上げにはカタログ音声が必要です | ナレーションにはカタログ音声を設定し、動画モデルが要求する場合のみクリップを使用します |
| テイクごとに速度を変更する | 同じ声でもペースが異なると、2人の人物が話しているように聞こえます | 速度は変更せず、代わりにスクリプトをクリップに合わせて調整してください |
| 声に似せるためにセリフを書き直す | 声は固定されており、言葉の方が変数です | 保存した声に合わせて書き、文の長さを一定に保ってください |
開始前に
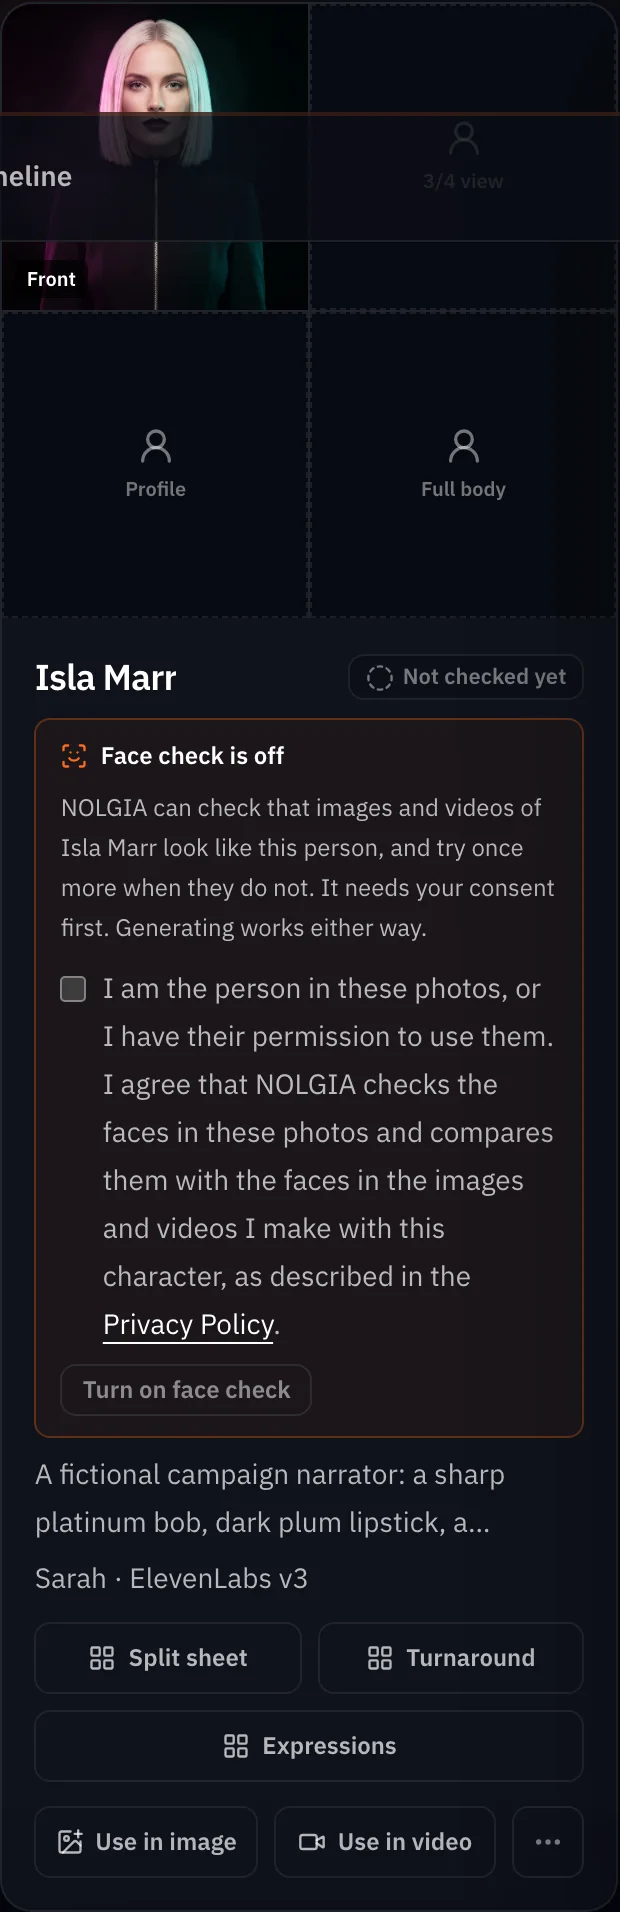
- キャラクターページ上のキャラクター。作成には名前と少なくとも1枚の写真が必要です。参照画像を追加を押して写真をアップロードし、キャラクターに名前を付けてキャラクターを作成を押します。当社のキャラクターは生成されたポートレートなので、実在の人物は関与していません。
- 名前付き音声を持つ音声モデル。ボイスダイアログには、ElevenLabsモデルとKokoroのみが表示されます。
- ナレーションしたいクリップをライブラリに用意します。当社の場合は、音声なしの5秒クリップ3本です。Kling v3で撮影したランウェイと屋上、Seedance 2.5で撮影した夜のドライブです。
キャラクターに声を保存する
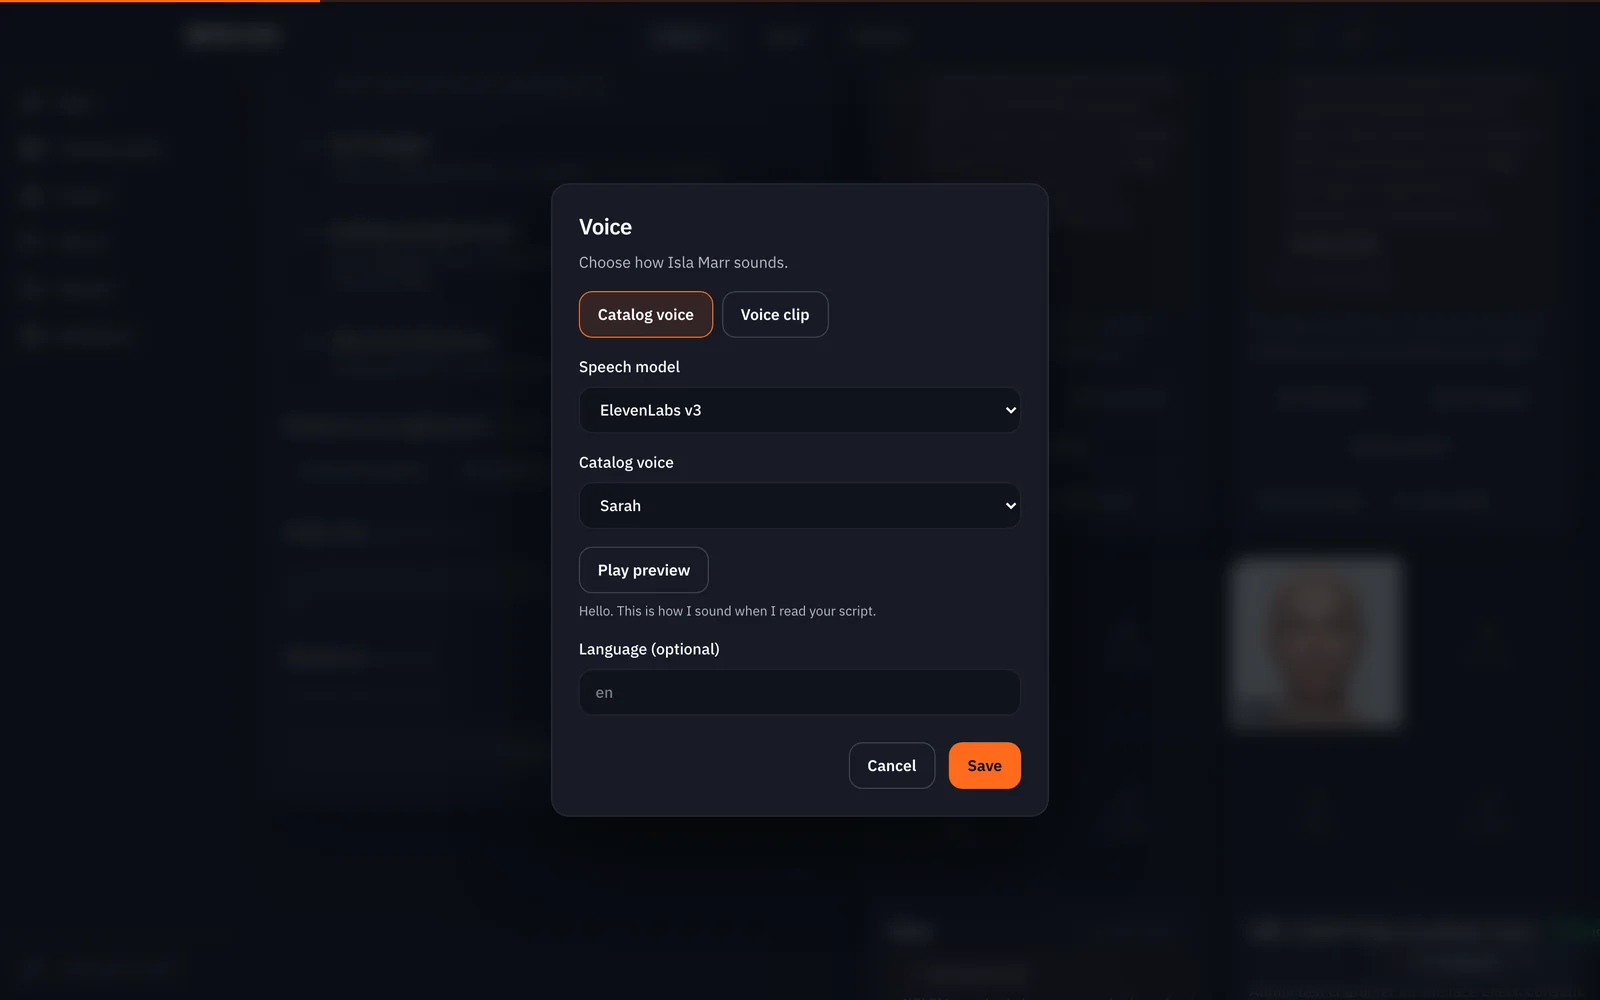
キャラクターページで、キャラクターカードの ... メニューを開き、ボイス を選択します。ダイアログには カタログボイス と ボイスクリップ の2種類があります。カタログボイス を選択してください。音声モデル を選び、次に カタログボイス を選択します。プレビューを再生 ボタンを押すと、そのボイスの録音サンプルを無料で再生できます。必要に応じて言語を追加し、保存 をクリックします。カードの説明の下にボイスが表示されます。
「話す声」でナレーションを作成する
オーディオコンポーザーを開き、ナレーションタスクで話す声を押します。キャラクターを選択します。モデルピッカーが保存済みのモデルに、ボイスリストが保存済みのボイスに切り替わり、ボタン下の行で確認できます:Isla Marr · Sarah で話しています。セリフを入力し、オーディオを生成を押します。2つのガイドでこれを5回連続で行いましたが、ペアは変わりませんでした。
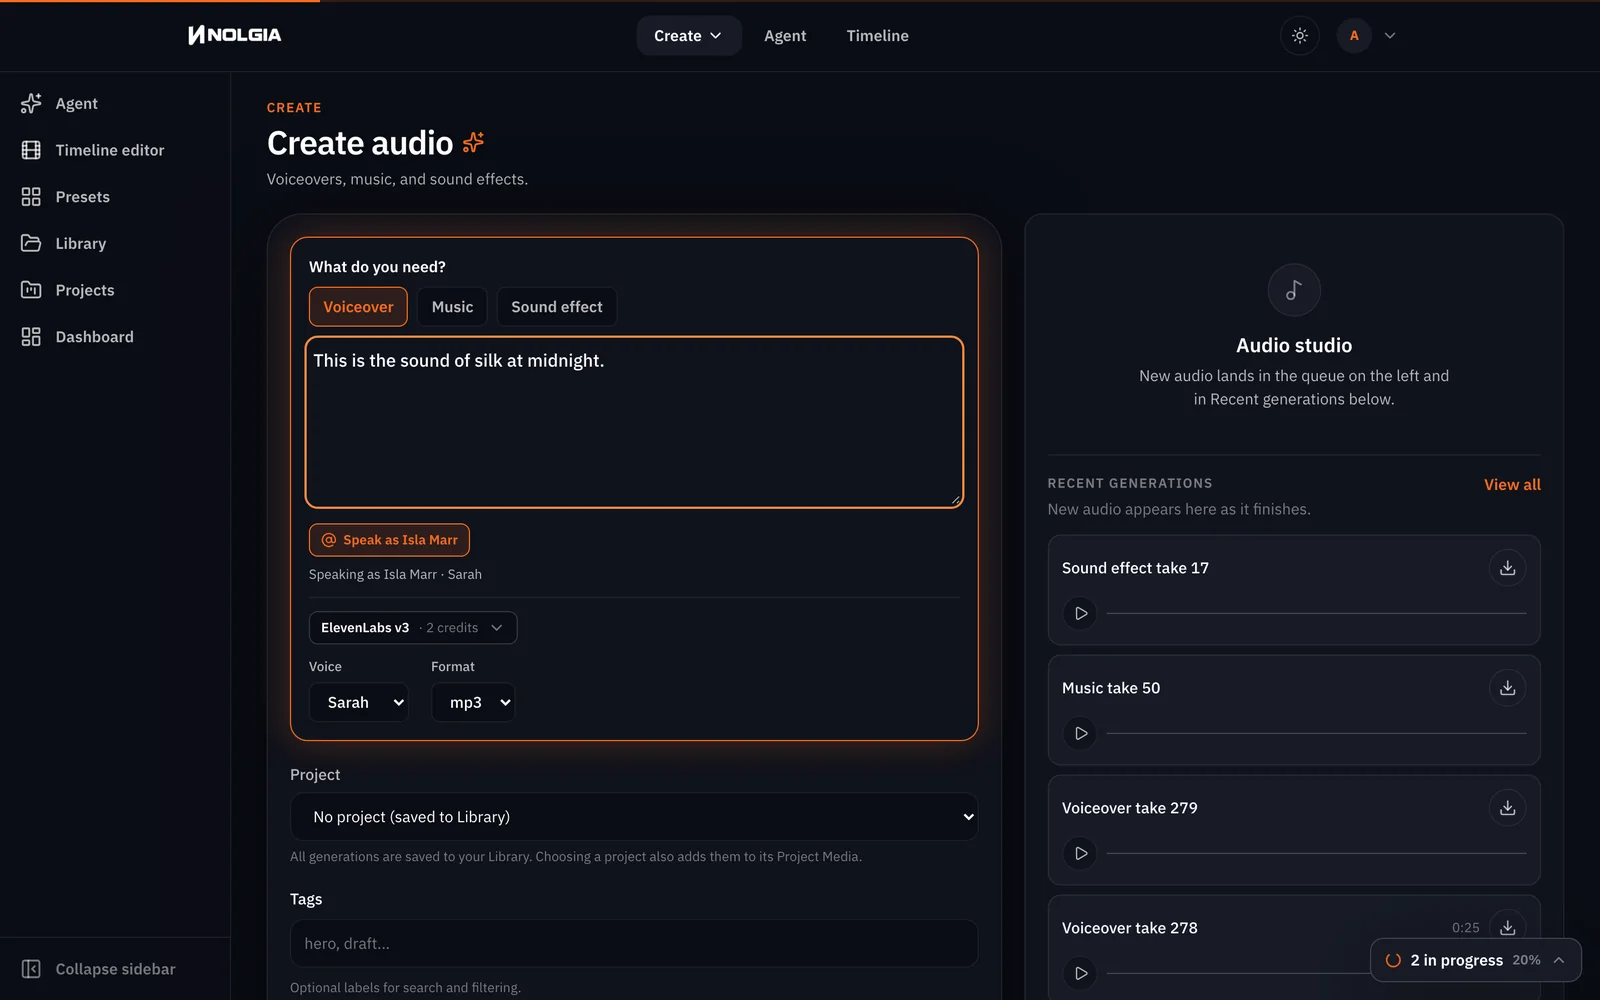
This is the sound of silk at midnight.Nothing here was built to stand still.You already know the ending. Wear it anyway.注意:ボイスが利用不可と表示される場合. 話す声は、保存済みのモデルがまだ保存済みのボイスを提供しているかを確認します。ボイスがカタログから削除された場合、代役で読み上げるのではなく、キャラクターページで別のボイスを選択するよう注記が表示されます。
ボイスの下に背景音とキューを配置する
一行だけの音声は寂しく聞こえます。オーディオコンポーザーの音楽タスクで音楽のベースを作り、効果音で1つのサウンドキューを作成してから、Studioで各クリップのタイムラインを構築します。タイムライン、新しいタイムラインを選択し、左パネルのライブラリタブでクリップの+をクリックします。次に、セリフが始まる再生ヘッドの位置にあるテイク、ベース、およびキューを追加します。
ヒント:Studioがボイスの下で音楽をダッキングします. 今日作成したタイムラインは、書き出し時にミックスされます。誰かが話している間、音楽は約12 dB下がり、ベースは最後にフェードアウトし、ラウドネスが均一になります。レベルを手動で設定するには、サウンドを選択してオーディオインスペクターを開き、クリップの音量、フェードインとフェードアウト、ボイスの下でダッキング、およびレーンのトラックの音量を調整します。私たちの3つのタイムラインは、Studioにこれらの機能がない状態でカットされたため、代わりに各ベースの静かな部分を選びました。音楽モデルに強いダイナミクスをリクエストし、ソースプレビューでトラックを再生します。フルバーから静かな部分へつながる箇所でインをマークし、5秒後にアウトをマークして、再生ヘッドが0の位置で+を押します。これにより、聞こえるようなダッキングなしで、セリフにスペースを残すことができます。
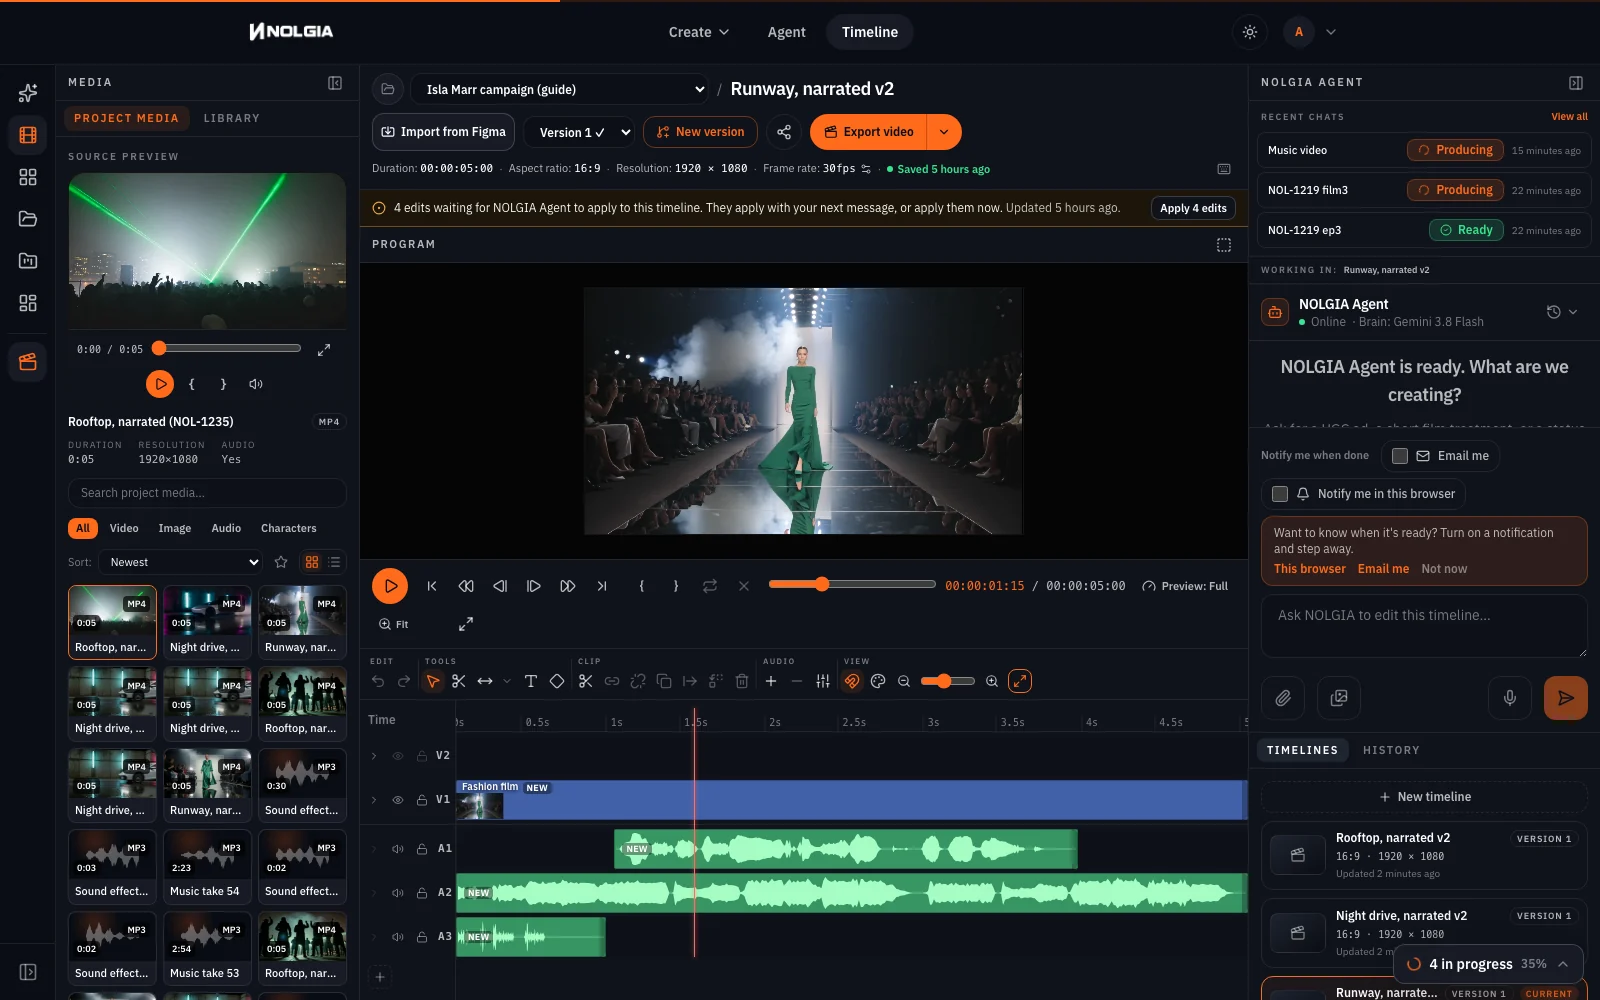
Sleek fashion-show runway track, 120 bpm, deep kick and a crisp clicking hi-hat, glossy synth stabs, instrumental, no vocals. Strong dynamics: two seconds of the full groove, then four seconds of a hushed, near-silent filtered pulse, then the full groove slams back in, and that shape repeats through the track.Dark synthwave night-drive track, 100 bpm, driving analog bass arpeggio, gated snare, cold pads, instrumental, no vocals. Strong dynamics: two seconds of the full drive, then four seconds of a sparse, hushed passage with only a low filtered bass, then the full drive returns, and that shape repeats through the track.Warehouse rave build for a rooftop party at night, 128 bpm, instrumental, no vocals: a soft muffled kick and a quiet rising filtered riser that builds for five seconds, then a huge drop with open hi-hats and a big supersaw lead, and that quiet build and big drop repeat through the track.キューはそれぞれElevenLabs Sound Effects v2で短い1行で、Mark Outでトリミングして音声と重ならないようにしています。ランウェイの最初の1秒間のカメラシャッター、ドライブのセリフ後のエンジンと水しぶき、そしてルーフトップの紙吹雪が舞う際の観客の歓声です。再生ボタンを押してください。モデルと音声設定が毎回同じリクエストだったため、3つの動画すべてで同じ声が使われており、音楽の上に配置されています。
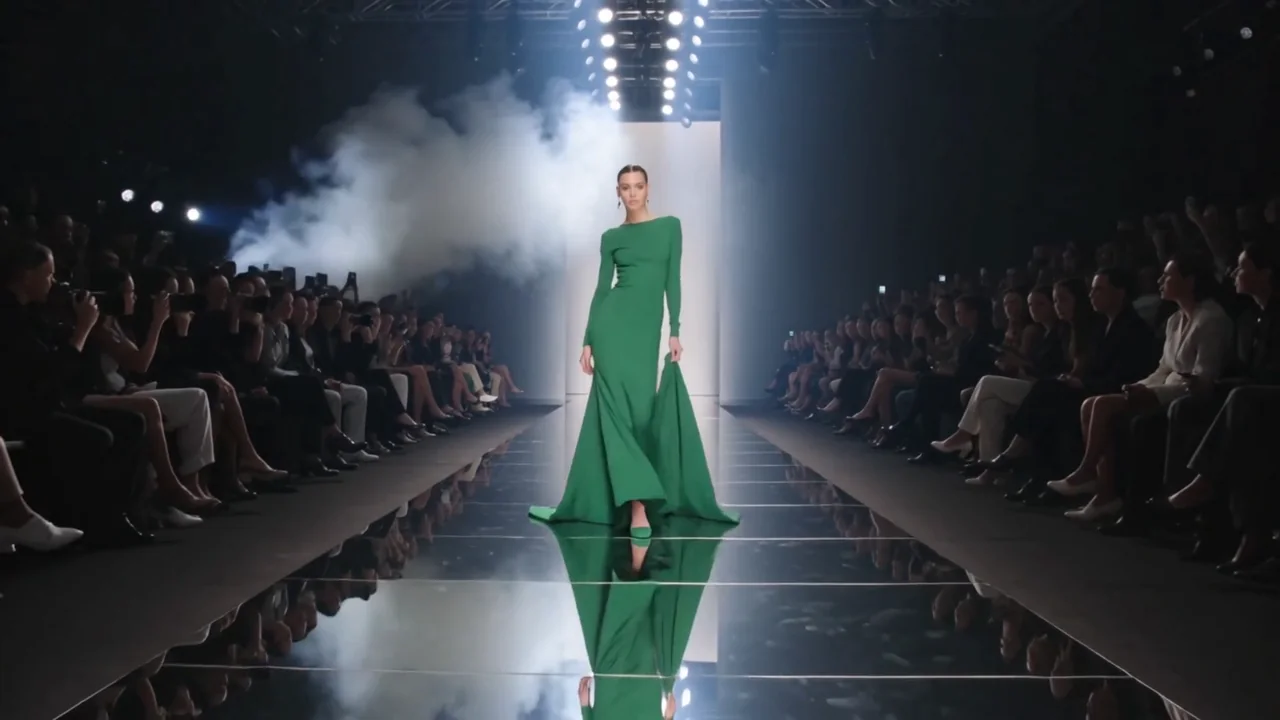
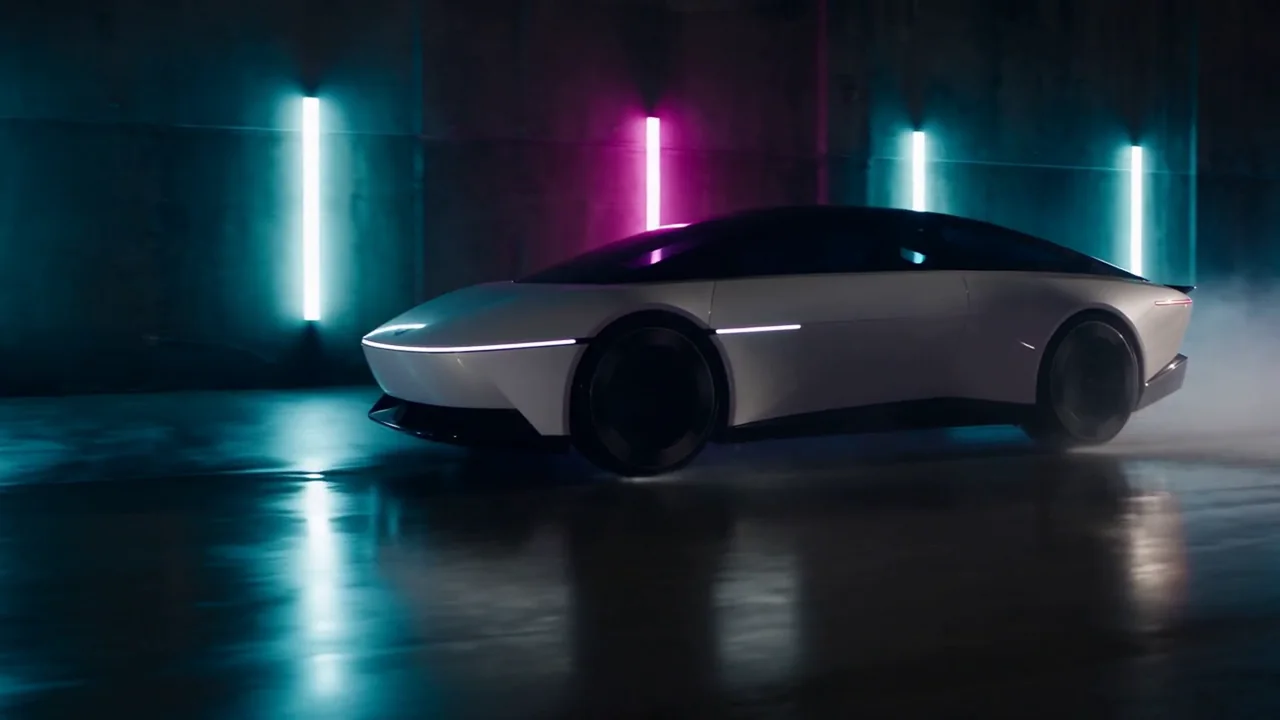
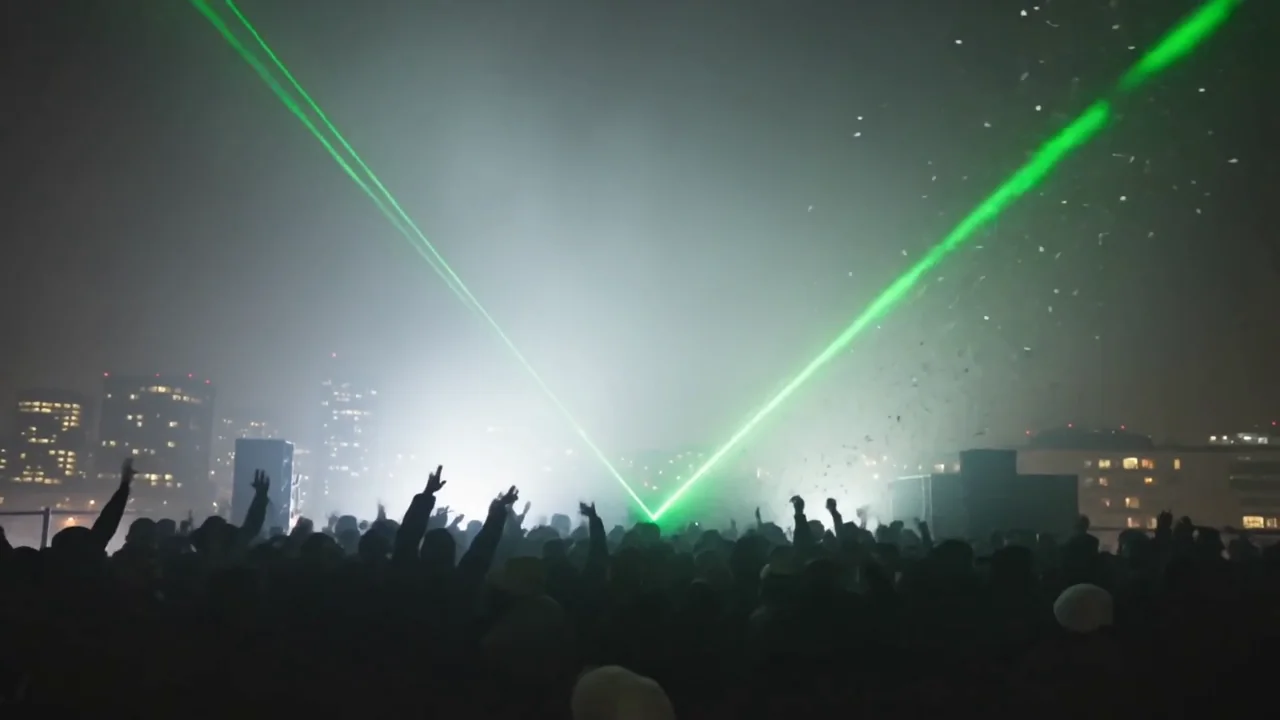
各エクスポートを測定しました。無音のギャップは0.5秒を超えず、彼女が話している間は声が他のすべての音より少なくとも3 dB高くなっています。これらのタイムラインではすべてのレーンを同じレベルでミックスしていたため、これらの数値は設定によるものではなく、選択した部分に基づいています。
実行方法3選
| パス | 方法 | 最適な場面 |
|---|---|---|
| 最速 | オーディオコンポーザー、Speak as、1行ずつ | 現在制作中のカットに数行のセリフが必要な場合 |
| 手間なし | NOLGIA Agentにキャラクター名を指定します。キャラクターの一覧を表示し、保存された声でオーディオを生成できます | スクリプトからのシリーズエピソード |
| 最も制御可能 | API: キャラクターのIDを指定して POST /generate/audio を実行するか、独自コードから MCP ツール nolgia_text_to_audio を使用します | ドキュメントまたはパイプラインからのナレーションの一括生成 |
API については キャラクターとロケーション に記載されています。キャラクターの音声は、キャラクターIDを使った音声生成と、キャラクターの音声を指定した動画生成で使用されます。このガイドではコンポーザーパスを実行しました。他の2つのパスではありません。
再生成が必要な場合
- 納品物は依然としてわずかに異なります。 音声とモデルは同じでも、各テイクは新しい読み上げになります。セリフが平坦に聞こえる場合は、もう一度実行してください。音声自体は変わりません。
- BGM がまだ言葉を覆っている場合。 エクスポート時に音声の下で音楽は自動的に下げられますが、音量の大きい部分ではセリフがかき消される可能性があります。オーディオインスペクターでBGMの クリップの音量 を下げるか、マークインを静かな部分に移動してください。
- 自分の声は手動で選択します。有料プランでは、オーディオコンポーザーの「Voice」リストにあるカスタムボイスを作成を使用すると、ElevenLabsの音声モデルで10秒から5分間の録音から声をクローン化できます。「Characters」ページの音声ダイアログは、カタログ音声と音声クリップのみを保存するため、「Speak as」ではカスタムボイスをまだ使用できません。毎回「Voice」リストから選択してください。キャラクターの音声クリップは、それを受け取るモデル用の参照であり、テキスト読み上げ音声ではありません。
- 速度はAPIのみで調整可能です。現在、コンポーザーに速度調整機能はありません。
費用について
音声の保存は無料です。プレビューも無料です。各行は、モデルの文字単位の料金が最低料金付きで課金されます。各音楽ベッドと各キューは一律の料金です。クリップは長さによって価格が決まっており、Studioのエクスポートは課金対象外です。
ElevenLabs v3Every plan
Per 1,000 characters
Standard 6 クレジット
Lyria 3.5Every plan
Per generation
Standard 5 クレジット
Stable Audio 3 MediumEvery plan
Per generation
Standard 3 クレジット
ElevenLabs SFXEvery plan
Per generation
Standard 4 クレジット
Kling v3Pro and up
Per 5s clip (audio on by default)
720p 35 クレジット · 1080p 47 クレジット · 4K 117 クレジット
Seedance 2.5Pro and up
Per 5s clip
480p 26 クレジット · 720p 56 クレジット · 1080p 137 クレジット
1080p renders at 16:9 and 9:16
このページを開いたときにカタログから最新の値を読み込みます。 料金はすべて生成前に表示されます。 すべての料金を見る.
試してみる
ナレーターのポートレート
- Isla Marrのポートレート、1408x768 JPEGJPEG 写真 · 1408x768 · 483 KBダウンロード
Fashion film, one continuous shot. A model in a sculpted emerald green floor-length gown with long sleeves walks down a mirrored runway toward the camera, camera strobes flashing from the crowd in silhouette on both sides, white haze, slow motion, low tracking shot moving backwards, anamorphic flares, deep blacks. No text, no logo.Premium car commercial, one continuous shot. An original concept coupe that resembles no production car: a low, wide, wedge-shaped matte white body with a single thin continuous light bar across the nose, no grille, no badges, a smooth flush glass canopy, enclosed rear wheel arches and a sharp ducktail rear. It slides sideways through a wet night street lined with bare concrete walls and plain vertical neon tubes in teal and magenta, no shop windows, no signs, no lettering anywhere. Rain streaks in the air, neon reflections stretched across the asphalt, low side tracking shot, spray from the tyres, motion blur on the passing lights, cinematic contrast.Music video, one continuous shot. A rooftop rave at night: a dense crowd in silhouette wearing long dark coats, hoodies and bucket hats, arms raised, under sharp green laser beams fanning through a thick haze layer, confetti bursting in slow motion, a city skyline of blurred lights behind them, low handheld camera looking up, backlit, high contrast. No text, no logo.あなたのクリップと音楽ベッドは、私たちのものとは一致しないでしょう。プロンプトはモデルにシーンやムードを伝えるものであり、テイクを指定するものではないため、Mark In 用に自分だけの静かな部分を見つけてください。キャラクターがボイスを保持しているため、ボイスは一致します。
チェックリスト
- 名前と写真のあるキャラクターが存在します。
- ボイスダイアログ:カタログボイス、名前付きボイスを持つモデル、プレビュー再生、保存済み。
- オーディオコンポーザー:「Speak as」にキャラクターが表示され、ノートにボイス名が記載されています。
- 各行につき1回の生成。カットする前に各テイクを確認してください。
- 強いダイナミクスを指定して作成した音楽ベッドと、クリップごとに1つのキュー。
- Studio:クリップ、再生ヘッド位置でのテイク、静かな部分からの5秒間のベッドウィンドウ、ボイスと重ならないキュー、動画のエクスポート。
よくある質問
- キャラクターのボイスとして使用できるモデルはどれですか?
- 名前付きのボイスを提供するモデルです。ElevenLabs の音声モデルは10種類のボイス、Kokoro は20種類を提供しています。MiniMax Speech、Inworld、Dia、Orpheus にはボイスリストがないため、ダイアログでは選択できません。
- すべてのテイクで同じ音になりますか?
- ボイスとモデルは同一です。読み上げ自体はそのたびに新しく生成されるため、テンポや強調はテイクごとにわずかに変わる可能性があります。気に入らない行があれば再生成してください。ボイスは変わりません。
- 自分の声を使うことはできますか?
- はい、有料プランで可能です。オーディオコンポーザーで ElevenLabs の音声モデルを選択し、Voice リストを開いて「Create custom voice」を選びます。1人の話者が10秒から5分間話している音声を録音またはアップロードし、それが自分の声であること、または話者の許可があることを確認すると、それ以降は任意の台本を読み上げます。キャラクターにはまだカスタムボイスを設定できないため、Voice リストで選択してください。キャラクターに3秒から30秒のボイスクリップを設定するのは、リファレンストラックを受け取るモデル用の参照音声です。
- 動画モデルでキャラクターのボイスを使用できますか?
- API には動画生成用のスイッチがありますが、このガイドでは試していないため、その音質については説明しません。
- 言語フィールドは何のためにありますか?
- en や en-US などの任意のタグで、そのボイスが話すキャラクターの言語を示します。不明な場合は空欄のままにしてください。
- Studio で音楽をボイスの下に下げることができますか?
- はい。今日作成したタイムラインでは、誰かが話している間、音楽は約 12 dB 下がります。音楽の「Duck under voice」はデフォルトでオンになっています。これをオフにしたり、Audio inspector で「Clip volume」「Fade in」「Fade out」「Track volume」を手動で設定したりできます。
キャラクターにボイスを固定する
Characters を開く関連ガイド
オーディオ
動画のためのボイス、音楽、サウンドエフェクト
オーディオコンポーザーでナレーション、BGM、サウンドエフェクトを作成し、Studioでクリップの下に配置します。どのモデルがどの作業を担当し、それぞれいくらかかるかをご説明します。
· 10 分で読めます
チャンネル
顔出しなしのナレーションチャンネル:ツール、ワークフロー、次のエピソード
脚本、保存されたナレーターの声、ビデオコンポーザーによる統一されたルックのBロール、Studioでのカット編集、そして次のエピソード用のNOLGIA Agent。実際に制作した2つの短いエピソード。
· 12 分で読めます
Agent
NOLGIA Agent クックブック: 何を伝えるか、そして次に何が起きるか
商品写真やリスティングセットからフックスコアやグレーディング済みカットまで、NOLGIA Agent に送信できる10件のメッセージ、それぞれの処理内容、そしてその背後にあるプリセットについて解説します。
· 6 分で読めます