

모든 영상에 동일한 목소리
에피소드마다 다른 목소리를 내는 내레이터는 진정한 내레이터가 아닙니다. 캐릭터에 음성을 저장하고 수동으로 선택하는 일을 멈추세요.
- 11분 분량
영어에서 자동 번역되었습니다. 원문 보기
동일한 캐릭터에 음성을 저장하면 모든 영상에서 같은 목소리를 유지할 수 있습니다. NOLGIA의 캐릭터는 음성( speech 모델과 해당 모델의 지정된 음성 중 하나)을 포함합니다. 오디오 컴포저에서 내레이션을 만들 때 화자 버튼을 누르면 캐릭터를 선택하고 저장된 모델과 음성 쌍으로 설정됩니다. 이후에는 수동으로 선택할 필요가 없으므로, 다음 달에 녹음한 대사와 오늘 녹음한 대사가 동일한 목소리로 읽힙니다.
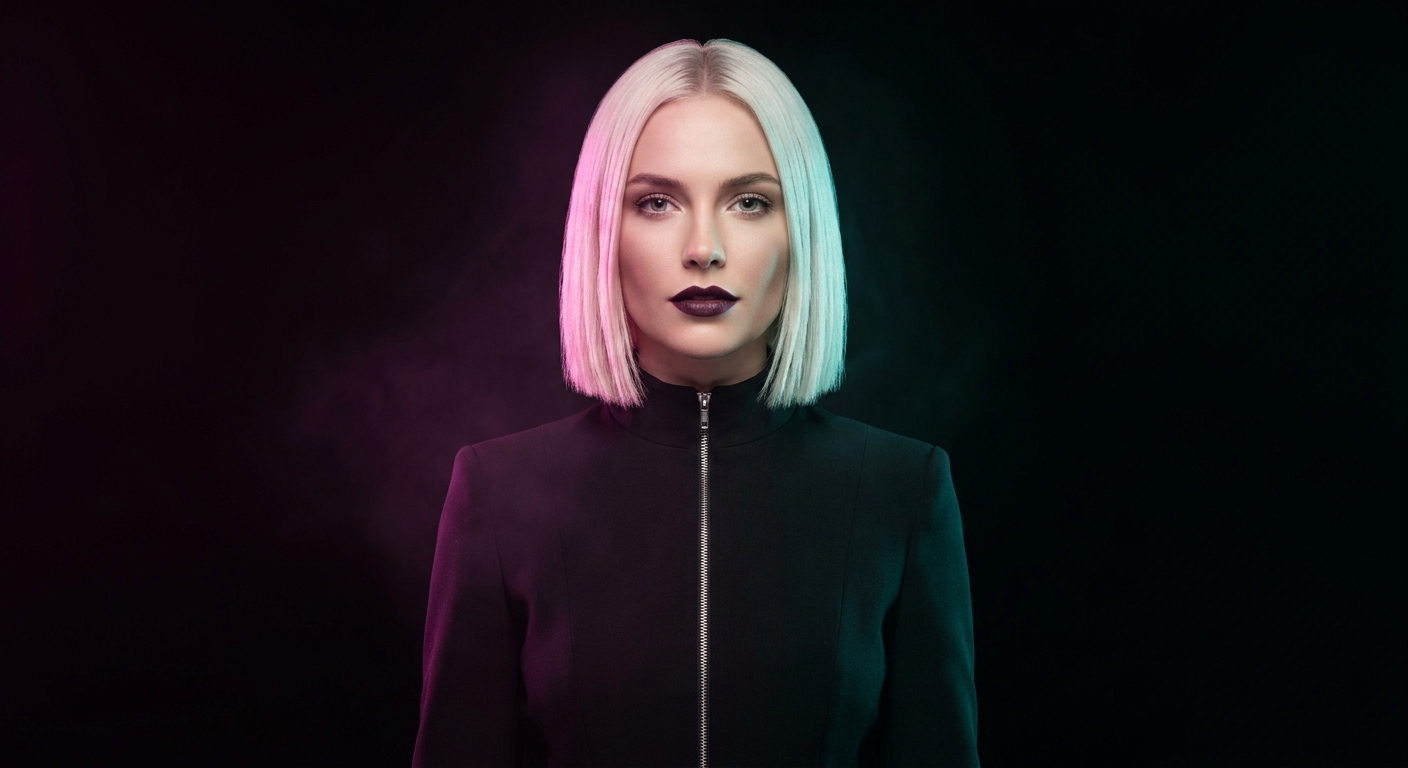
이 가이드에서는 가상의 캠페인 음성인 Isla Marr이라는 한 명의 내레이터를 만들고, 그녀가 런웨이, 야간 드라이브, 루프탑 레이브라는 세 개의 관련 없는 클립에 대한 대사를 읽게 합니다. 각 클립에는 Studio에서 음성 아래에 배치된 음악 베드와 하나의 사운드 큐도 포함됩니다. 모든 클립과 대사는 실제 출력이며, 모델과 음성은 그 사이에서 변경되지 않았습니다.
문제가 되는 점과 해결 방법
| 실수 | 문제를 일으키는 이유 | 수정 |
|---|---|---|
| 매번 수동으로 음성을 선택함 | 한 세션에서는 v3, 다음 세션에서는 Turbo를 사용하면 같은 이름이 다르게 읽힘 | 모델과 음성을 캐릭터에 저장하고 화자 사용 |
| 음성 목록이 없는 모델을 선택함 | MiniMax Speech, Inworld, Dia, Orpheus는 지정된 음성을 제공하지 않으므로 고정할 수 없음 | 반복적인 내레이터에는 ElevenLabs 또는 Kokoro 사용 |
| 캐릭터에 음성 클립을 주고 내레이션을 기대하기 | 클립 음성은 참조 트랙을 사용하는 모델용이며, 텍스트 음성 변환에는 카탈로그 음성이 필요합니다 | 내레이션에는 카탈로그 음성을 설정하고, 비디오 모델이 요청할 때만 클립을 사용하세요 |
| 테이크마다 속도 변경하기 | 같은 음성이라도 속도가 다르면 두 사람처럼 들립니다 | 속도는 그대로 두고, 스크립트를 클립에 맞게 조정하세요 |
| 음성에 더 잘 어울리도록 대사를 다시 쓰기 | 음성은 고정되어 있고, 단어는 변수입니다 | 저장한 음성에 맞춰 작성하고 문장 길이를 일정하게 유지하세요 |
시작하기 전에
- 캐릭터 페이지의 캐릭터. 캐릭터를 만들려면 이름과 최소 한 장의 사진이 필요합니다. 레퍼런스 이미지 추가를 누르고 사진을 업로드한 후 캐릭터 이름을 지정하고 캐릭터 만들기를 누르세요. 여기서는 생성된 초상화를 사용하므로 실제 인물은 포함되지 않습니다.
- 이름이 지정된 음성이 있는 음성 모델. 보이스 대화 상자는 ElevenLabs 모델과 Kokoro만 나열합니다.
- 내레이션할 클립이 라이브러리에 있어야 합니다. 여기서는 소리가 없는 5초 길이의 클립 세 개를 사용했습니다. Kling v3의 활주로와 옥상, Seedance 2.5의 야간 드라이브입니다.
캐릭터에 음성 저장하기
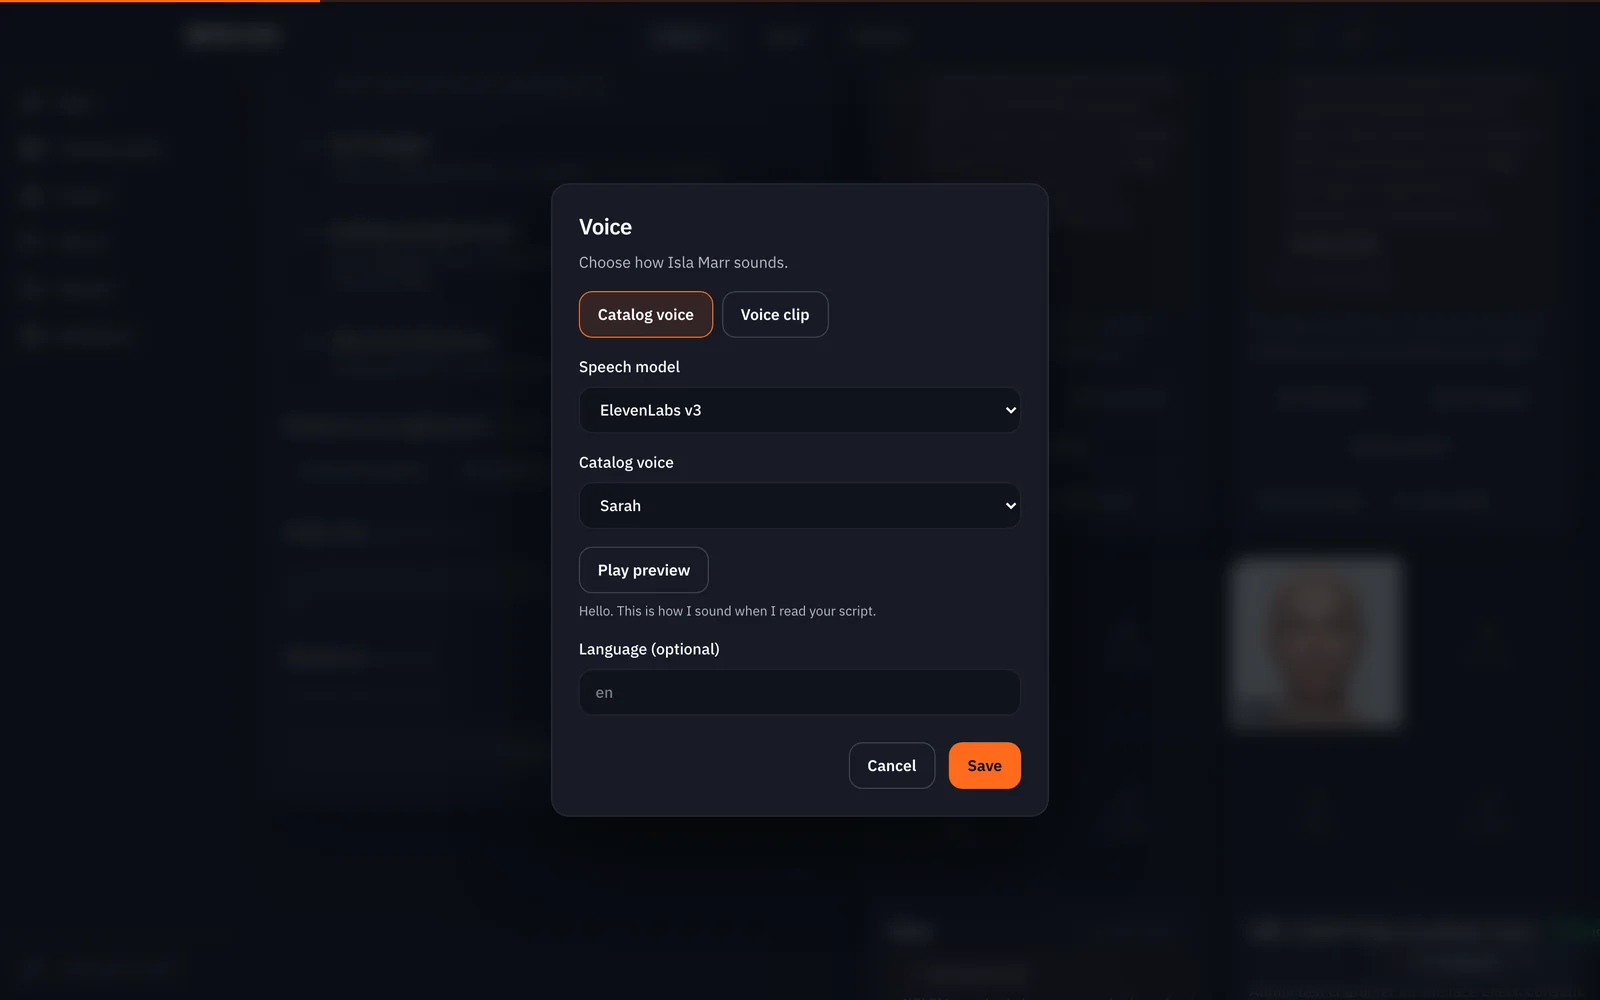
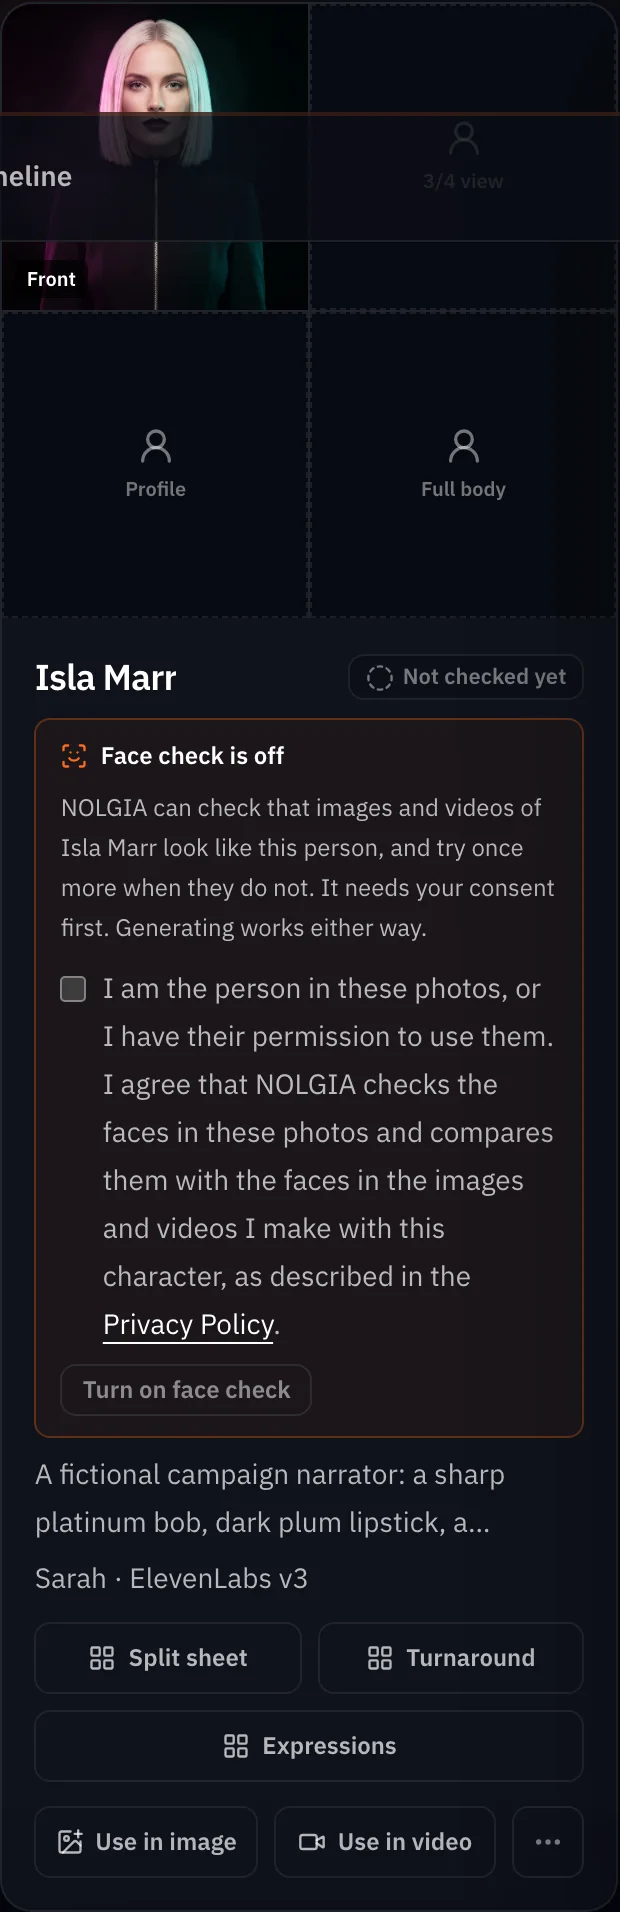
Characters 페이지에서 캐릭터 카드의 ... 메뉴를 열고 보이스를 선택하세요. 대화상자에는 카탈로그 보이스와 보이스 클립 두 가지 유형이 있습니다. 카탈로그 보이스를 유지하세요. 음성 모델을 선택한 다음 카탈로그 보이스를 선택하세요. 미리보기 재생 버튼을 누르면 해당 보이스의 녹음된 샘플을 무료로 들을 수 있습니다. 원한다면 언어를 추가한 후 저장을 누르세요. 이제 카드에 설명 아래에 보이스가 표시됩니다.
화자로 내레이션하기
Voiceover 작업에서 오디오 컴포저를 열고 화자를 누르세요. 캐릭터를 선택하면 모델 선택기가 저장된 모델로, Voice 목록이 저장된 목소리로 전환되고 버튼 아래에 확인 문구가 표시됩니다: Speaking as Isla Marr · Sarah. 대사를 입력하고 오디오 생성을 누르세요. 두 가이드에서 이 과정을 다섯 번 연속으로 진행했지만, 설정이 한 번도 바뀌지 않았습니다.
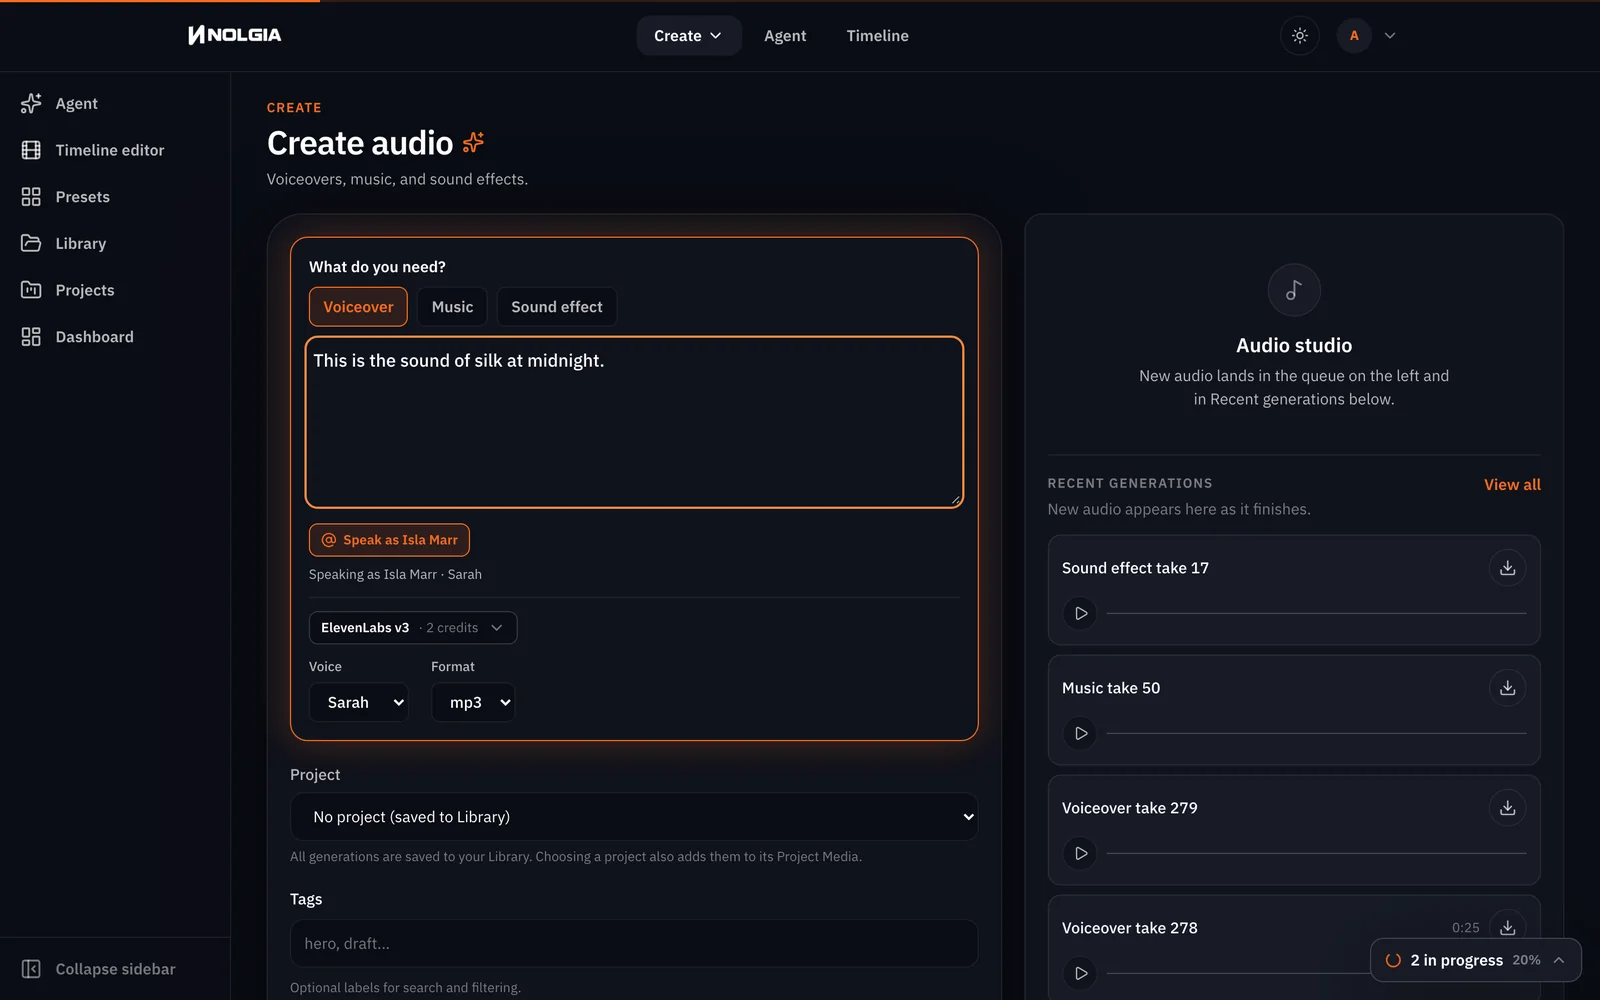
This is the sound of silk at midnight.Nothing here was built to stand still.You already know the ending. Wear it anyway.주의:목소리를 사용할 수 없다는 안내가 표시될 경우. 화자 기능은 저장된 모델이 여전히 저장된 목소리를 지원하는지 확인합니다. 만약 목소리가 카탈로그에서 삭제되면, 대신 다른 목소리로 읽는 대신 캐릭터 페이지에서 다른 목소리를 선택하라는 안내가 표시됩니다.
목소리 아래에 배경음과 큐를 배치하세요
한 줄만 있으면 허전해 보입니다. 오디오 컴포저의 음악 작업에서 음악 베드를 만들고 효과음에서 사운드 큐 하나를 만든 다음, Studio에서 각 클립의 타임라인을 구성하세요. 타임라인, 새 타임라인을 선택하고 왼쪽 패널의 라이브러리 탭에서 클립의 +를 누른 후, 대사가 시작되는 재생 위치의 테이크, 베드, 큐를 추가합니다.
팁:Studio가 보이스 아래로 베드를 낮춥니다. 오늘 만든 타임라인은 내보낼 때 믹싱됩니다: 누군가 말할 때 음악이 약 12 dB 낮아지고, 끝부분에서 베드가 페이드 아웃되며, 라우드니스가 균일해집니다. 직접 레벨을 설정하려면 소리를 선택하고 오디오 인스펙터를 여세요. 클립 볼륨, 페이드 인 및 페이드 아웃, 보이스 아래로 더킹, 레인의 트랙 볼륨을 조정할 수 있습니다. 저희의 세 타임라인은 Studio에 이러한 기능이 없었을 때 편집되었으므로, 대신 각 베드의 조용한 부분을 선택했습니다. 음악 모델에 강한 다이내믹스를 요청하고, 원본 미리보기에서 트랙을 재생한 후, 한 마디가 조용한 구간으로 이어지는 지점에 시작 표시를 누르고 5초 뒤에 끝 표시를 누른 다음, 재생 위치가 0일 때 +를 누르세요. 이렇게 하면 들리는 더킹 없이도 대사에 공간을 줄 수 있습니다.
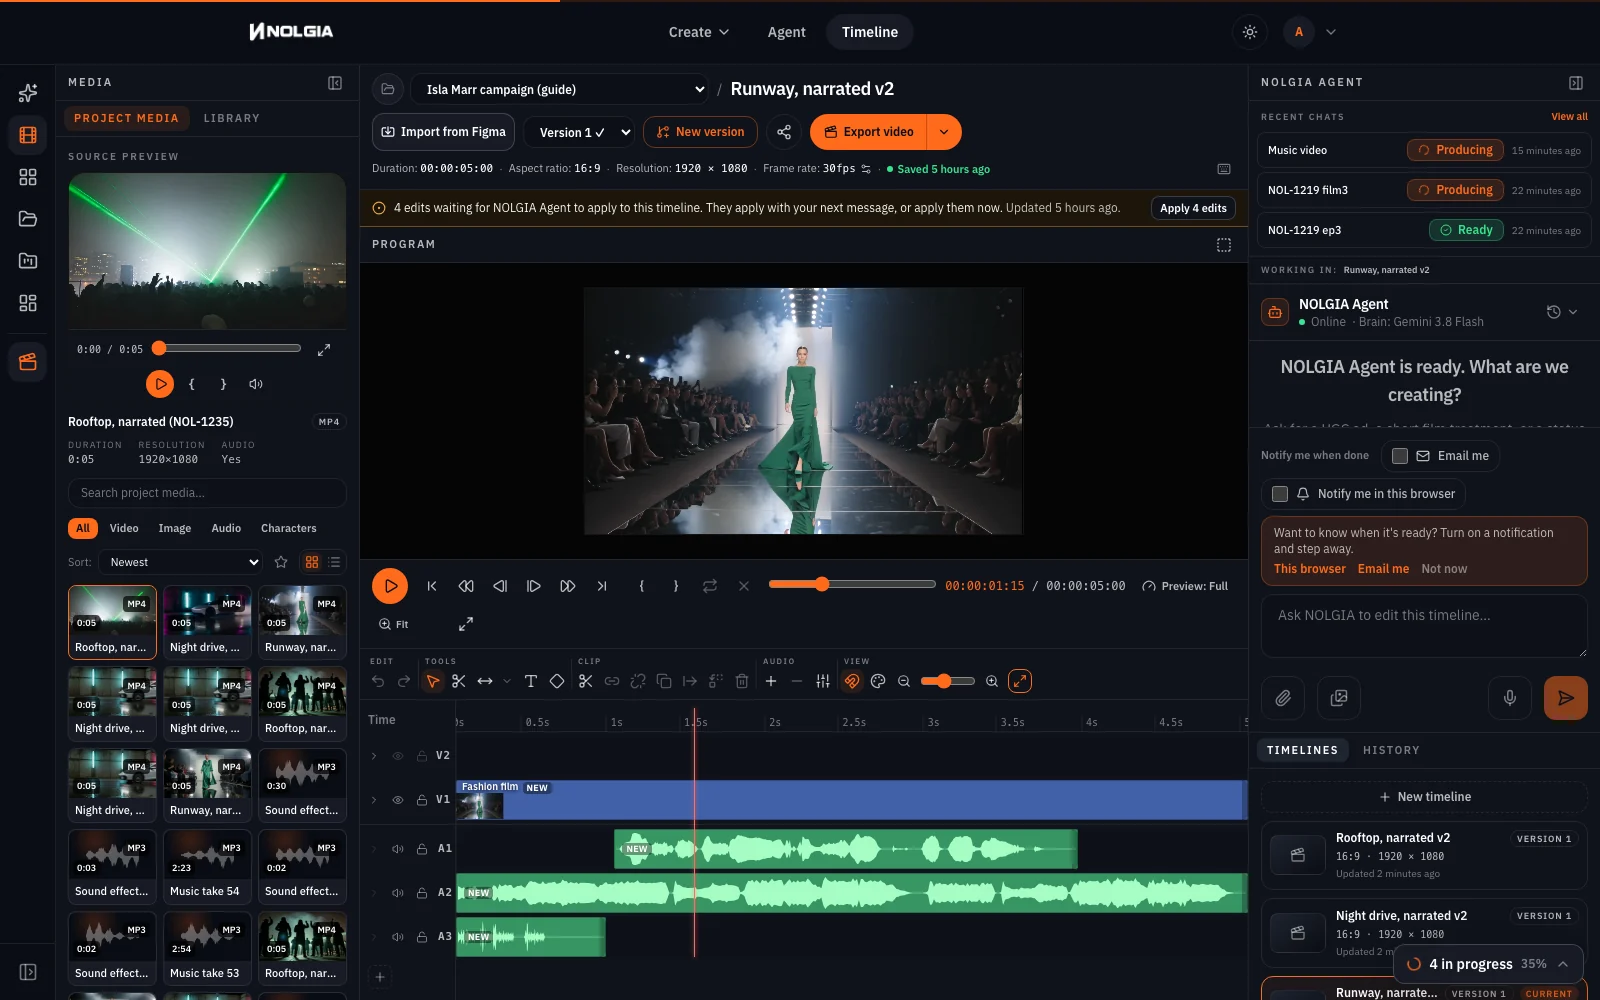
Sleek fashion-show runway track, 120 bpm, deep kick and a crisp clicking hi-hat, glossy synth stabs, instrumental, no vocals. Strong dynamics: two seconds of the full groove, then four seconds of a hushed, near-silent filtered pulse, then the full groove slams back in, and that shape repeats through the track.Dark synthwave night-drive track, 100 bpm, driving analog bass arpeggio, gated snare, cold pads, instrumental, no vocals. Strong dynamics: two seconds of the full drive, then four seconds of a sparse, hushed passage with only a low filtered bass, then the full drive returns, and that shape repeats through the track.Warehouse rave build for a rooftop party at night, 128 bpm, instrumental, no vocals: a soft muffled kick and a quiet rising filtered riser that builds for five seconds, then a huge drop with open hi-hats and a big supersaw lead, and that quiet build and big drop repeat through the track.각 큐는 ElevenLabs Sound Effects v2로 한 줄씩 짧게 만들고, Mark Out으로 다듬어 목소리와 겹치지 않게 합니다. 런웨이 첫 1초에는 카메라 셔터 소리, 드라이브 대사 이후에는 엔진과 물보라 소리, 루프탑의 색종이가 떨어질 때는 군중 함성 소리를 넣습니다. 재생 버튼을 누르면 세 영상 모두 모델과 목소리가 매번 동일한 요청으로 생성되었기 때문에 목소리가 동일하며, 음악 위에 위치합니다.
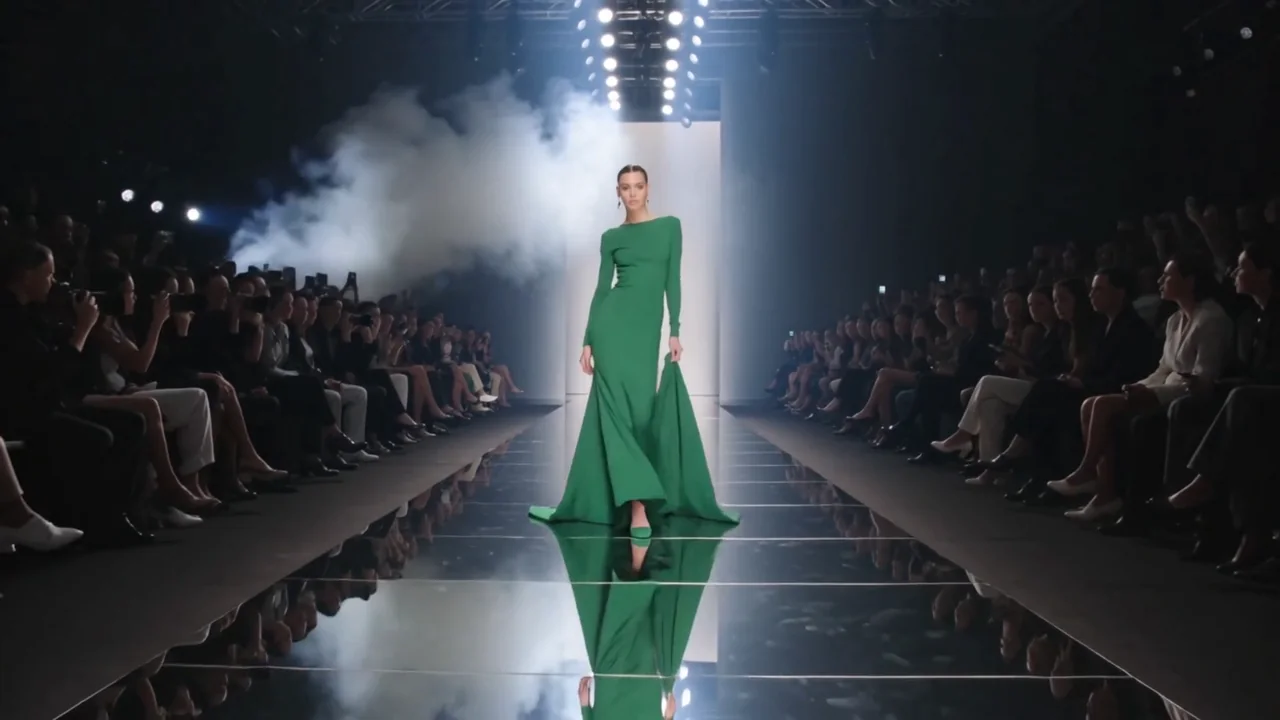
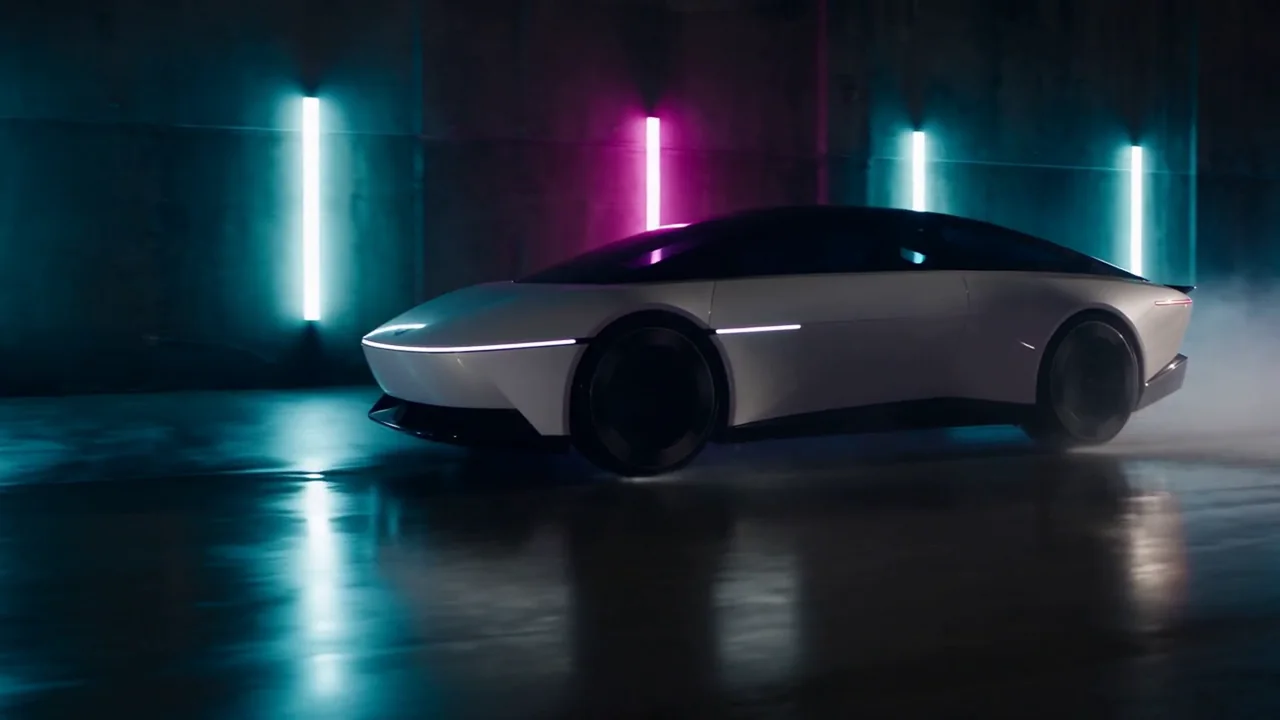
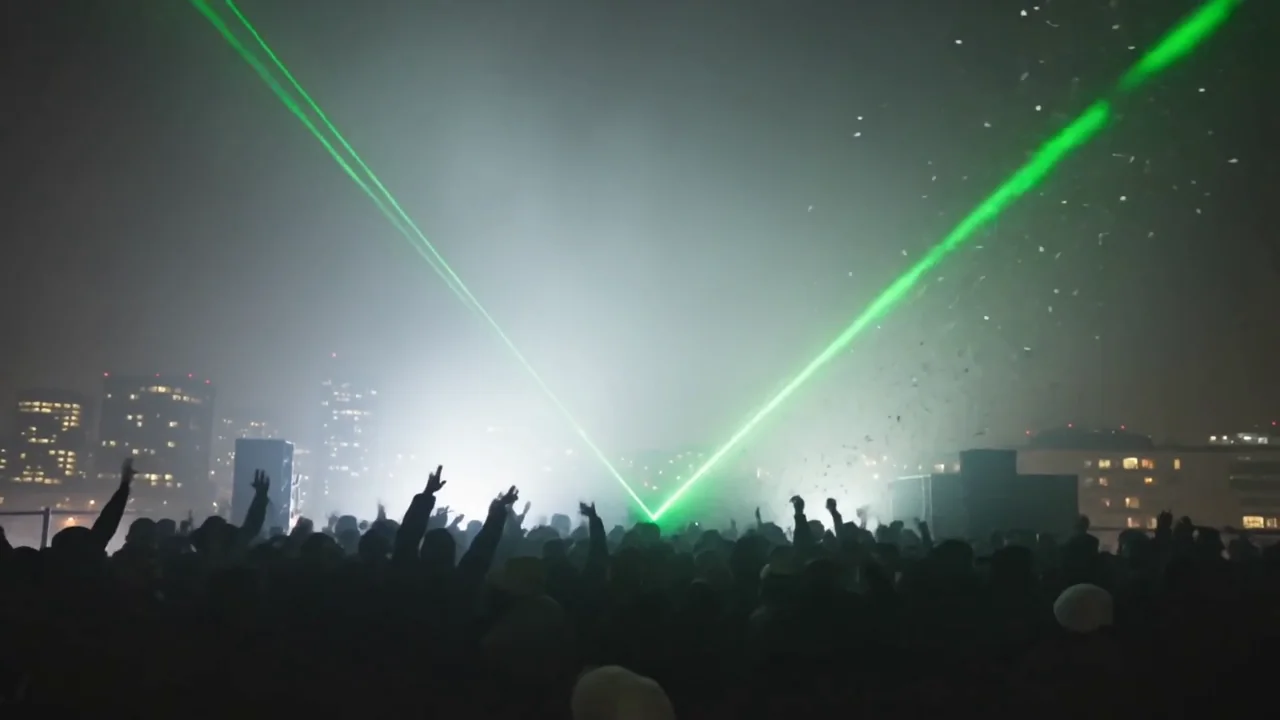
각 내보낸 파일을 측정했습니다. 0.5초보다 긴 무음 구간은 없으며, 그녀가 말할 때 목소리는 다른 모든 소리보다 최소 3 dB 높습니다. 해당 타임라인에서는 모든 트랙을 같은 수준으로 믹싱했으므로, 이 수치는 우리가 선택한 구간에서 나온 것이며 설정값에서 나온 것이 아닙니다.
실행하는 세 가지 방법
| 경로 | 방법 | 적합한 경우 |
|---|---|---|
| 가장 빠름 | 오디오 컴포저, Speak as, 한 줄씩 | 지금 편집 중인 컷을 위한 몇 줄의 대사 |
| 자동화 | NOLGIA Agent에 캐릭터 이름을 지정하세요. 캐릭터 목록을 확인하고 저장된 목소리로 오디오를 생성할 수 있습니다. | 대본 기반의 에피소드 시리즈 |
| 가장 높은 제어 | API: 캐릭터 ID로 POST /generate/audio를 호출하거나, 자체 코드에서 MCP 도구 nolgia_text_to_audio 사용 | 문서나 파이프라인에서 일괄 내레이션 생성 |
API 경로는 캐릭터 및 장소에 문서화되어 있습니다: 캐릭터의 목소리는 캐릭터 ID를 사용하는 오디오 생성과 캐릭터의 목소리를 요청하는 비디오 생성에 사용됩니다. 이 가이드에서는 컴포저 경로를 실행했으며, 다른 두 경로는 실행하지 않았습니다.
다시 생성해야 하는 경우
- 전달 방식은 여전히 약간씩 다릅니다. 같은 목소리, 같은 모델이지만 각 테이크는 새로운 낭독입니다. 대사가 밋밋하게 들리면 다시 실행하세요. 목소리는 변하지 않습니다.
- 여전히 단어를 가리는 배경음. 내보내기 시 음악이 목소리 아래로 낮아지지만, 큰 소리의 구간이 대사를 가릴 수 있습니다. 오디오 인스펙터에서 배경음의 클립 볼륨을 낮추거나, 마크 인을 더 조용한 구간으로 이동하세요.
- 내 목소리는 직접 선택합니다. 유료 요금제에서는 오디오 컴포저의 Voice 목록에서 사용자 지정 보이스 만들기를 통해 10초에서 5분 분량의 녹음으로 내 목소리를 복제할 수 있으며, ElevenLabs 음성 모델을 사용합니다. Characters 페이지의 음성 대화상자는 카탈로그 음성 및 음성 클립만 저장하므로 Speak as 기능은 아직 사용자 지정 음성을 지원하지 않습니다: 매번 Voice 목록에서 선택하세요. 캐릭터의 음성 클립은 이를 지원하는 모델용 참조일 뿐, 텍스트 음성 변환(TTS) 음성이 아닙니다.
- 속도는 API로만 조정 가능합니다. 현재 컴포저에는 속도 조절 기능이 없습니다.
비용 안내
음성 저장은 무료이며, 미리 듣기도 무료입니다. 각 대사는 모델의 문자당 요금에 최소 금액이 적용되어 과금됩니다. 각 음악 베드와 각 큐는 정액으로 과금됩니다. 클립은 길이에 따라 책정되며, Studio 내보내기 파일은 과금 대상이 아닙니다.
ElevenLabs v3Every plan
Per 1,000 characters
Standard 6 크레딧
Lyria 3.5Every plan
Per generation
Standard 5 크레딧
Stable Audio 3 MediumEvery plan
Per generation
Standard 3 크레딧
ElevenLabs SFXEvery plan
Per generation
Standard 4 크레딧
Kling v3Pro and up
Per 5s clip (audio on by default)
720p 35 크레딧 · 1080p 47 크레딧 · 4K 117 크레딧
Seedance 2.5Pro and up
Per 5s clip
480p 26 크레딧 · 720p 56 크레딧 · 1080p 137 크레딧
1080p renders at 16:9 and 9:16
이 페이지를 열 때 카탈로그에서 실시간으로 불러옵니다. 모든 가격은 생성하기 전에 표시됩니다. 모든 요금 보기.
직접 해보세요
내레이터의 초상화
- Isla Marr 초상화, 1408x768 JPEGJPEG 사진 · 1408x768 · 483 KB다운로드
Fashion film, one continuous shot. A model in a sculpted emerald green floor-length gown with long sleeves walks down a mirrored runway toward the camera, camera strobes flashing from the crowd in silhouette on both sides, white haze, slow motion, low tracking shot moving backwards, anamorphic flares, deep blacks. No text, no logo.Premium car commercial, one continuous shot. An original concept coupe that resembles no production car: a low, wide, wedge-shaped matte white body with a single thin continuous light bar across the nose, no grille, no badges, a smooth flush glass canopy, enclosed rear wheel arches and a sharp ducktail rear. It slides sideways through a wet night street lined with bare concrete walls and plain vertical neon tubes in teal and magenta, no shop windows, no signs, no lettering anywhere. Rain streaks in the air, neon reflections stretched across the asphalt, low side tracking shot, spray from the tyres, motion blur on the passing lights, cinematic contrast.Music video, one continuous shot. A rooftop rave at night: a dense crowd in silhouette wearing long dark coats, hoodies and bucket hats, arms raised, under sharp green laser beams fanning through a thick haze layer, confetti bursting in slow motion, a city skyline of blurred lights behind them, low handheld camera looking up, backlit, high contrast. No text, no logo.사용자 클립과 배경 음악은 예시와 일치하지 않을 수 있습니다. 프롬프트는 모델에게 장면이나 분위기를 전달할 뿐, 구체적인 촬영본을 지정하지는 않으므로 Mark In을 위해 조용한 부분을 직접 찾아보세요. 캐릭터가 음성을 담당하므로 목소리는 일치할 것입니다.
체크리스트
- 이름과 사진이 있는 캐릭터가 존재합니다.
- 음성 대화: 카탈로그 음성, 이름이 지정된 음성이 있는 모델, 미리보기 재생, 저장 완료.
- 오디오 컴포저: Speak as에 캐릭터가 표시되고 노트에 음성 이름이 명시됩니다.
- 줄마다 한 번씩 생성하며, 편집 전에 각 테이크를 확인하세요.
- 강한 다이내믹스를 요청한 배경 음악과 클립당 하나의 큐.
- Studio: 클립, 재생 헤드 위치의 테이크, 조용한 부분에서 5초 길이의 배경 음악 구간, 음성에서 명확히 분리된 큐, Export video(비디오 내보내기).
자주 묻는 질문
- 어떤 모델이 캐릭터의 음성이 될 수 있나요?
- 이름이 지정된 보이스를 제공하는 모델입니다. ElevenLabs 음성 모델은 10개의 보이스를, Kokoro는 20개의 보이스를 지원합니다. MiniMax Speech, Inworld, Dia, Orpheus는 보이스 목록이 없으므로 대화 상자에 표시되지 않습니다.
- 모든 테이크가 똑같이 들릴까요?
- 보이스와 모델은 동일합니다. 하지만 읽기 자체는 매번 새로 생성되므로, 테이크마다 속도와 강조점이 조금씩 달라질 수 있습니다. 마음에 들지 않는 대사는 다시 실행하세요. 보이스는 그대로 유지됩니다.
- 제 목소리를 사용할 수 있나요?
- 네, 유료 요금제에서 가능합니다. 오디오 컴포저에서 ElevenLabs 음성 모델을 선택하고 Voice 목록을 연 뒤 Create custom voice를 선택하세요. 한 사람이 말하는 10초부터 5분까지의 음성을 녹음하거나 업로드하고, 본인 목소리이거나 화자의 허락을 받았음을 확인하면 이후 모든 대본을 읽을 수 있습니다. 아직 캐릭터에는 사용자 지정 보이스를 적용할 수 없으므로 Voice 목록에서 선택하세요. 캐릭터에 3초부터 30초까지의 음성 클립을 설정하면, 참조 트랙을 사용하는 모델에 대한 참조로 활용됩니다.
- 비디오 모델이 캐릭터의 목소리를 사용할 수 있나요?
- 비디오 생성 API에는 이를 위한 스위치가 있습니다. 이 가이드에서는 해당 기능을 실행해 보지 않았으므로, 그 결과로 나오는 소리에 대해서는 설명하지 않습니다.
- 언어 필드는 무엇인가요?
- 음성에 저장되는 en 또는 en-US 같은 선택적 태그로, 캐릭터가 말하는 언어를 나타냅니다. 확실하지 않으면 비워 두세요.
- Studio에서 음성 아래로 음악 볼륨을 자동으로 낮출 수 있나요?
- 네. 오늘 생성한 타임라인에서는 누군가 말할 때 음악이 약 12dB 낮아지며, 음악의 기본 설정은 'Duck under voice'가 켜져 있습니다. 이 기능을 끄거나 Audio 인스펙터에서 Clip volume, Fade in, Fade out, Track volume을 직접 설정할 수 있습니다.
캐릭터에 음성 고정하기
캐릭터 열기관련 가이드
오디오
동영상을 위한 음성, 음악 및 효과음
오디오 컴포저에서 내레이션, 배경 음악, 효과음을 만든 후 Studio에서 클립 아래에 배치하세요. 각 모델이 어떤 작업을 수행하며 비용은 얼마인지 확인해 보세요.
· 10분 분량
채널
얼굴 없는 내레이션 채널: 도구, 워크플로우, 다음 에피소드
대본, 저장된 한 명의 내레이터 목소리, 비디오 컴포저에서 고정된 룩으로 만든 B롤, Studio에서의 편집, 그리고 다음 에피소드를 위한 NOLGIA Agent. 실제 제작된 두 개의 짧은 에피소드입니다.
· 12분 분량
에이전트
NOLGIA Agent 레시피북: 무엇을 말해야 하고, 그 다음에는 어떤 일이 벌어지는가
제품 사진과 리스팅 세트부터 훅 점수와 색보정된 편집본까지, NOLGIA Agent에게 보낼 수 있는 10가지 메시지와 각 메시지에 대한 처리 내용, 그리고 그 뒤에 숨겨진 프리셋을 소개합니다.
· 6분 분량