

A mesma voz em todos os vídeos
Um narrador que soa diferente em cada episódio não é um narrador. Salve a voz em um personagem e pare de escolhê-la manualmente.
- 11 min de leitura
Traduzido automaticamente do inglês. Ler o original
Você mantém a mesma voz em todos os vídeos salvando-a em um personagem. Um personagem no NOLGIA carrega uma voz: um modelo de fala e uma das vozes nomeadas desse modelo. Ao criar a narração no compositor de áudio, o botão Falar como seleciona o personagem e define o modelo e a voz para o par salvo. Você nunca mais precisa escolhê-los manualmente, então uma fala gravada no mês próximo será lida pela mesma voz de uma fala gravada hoje.
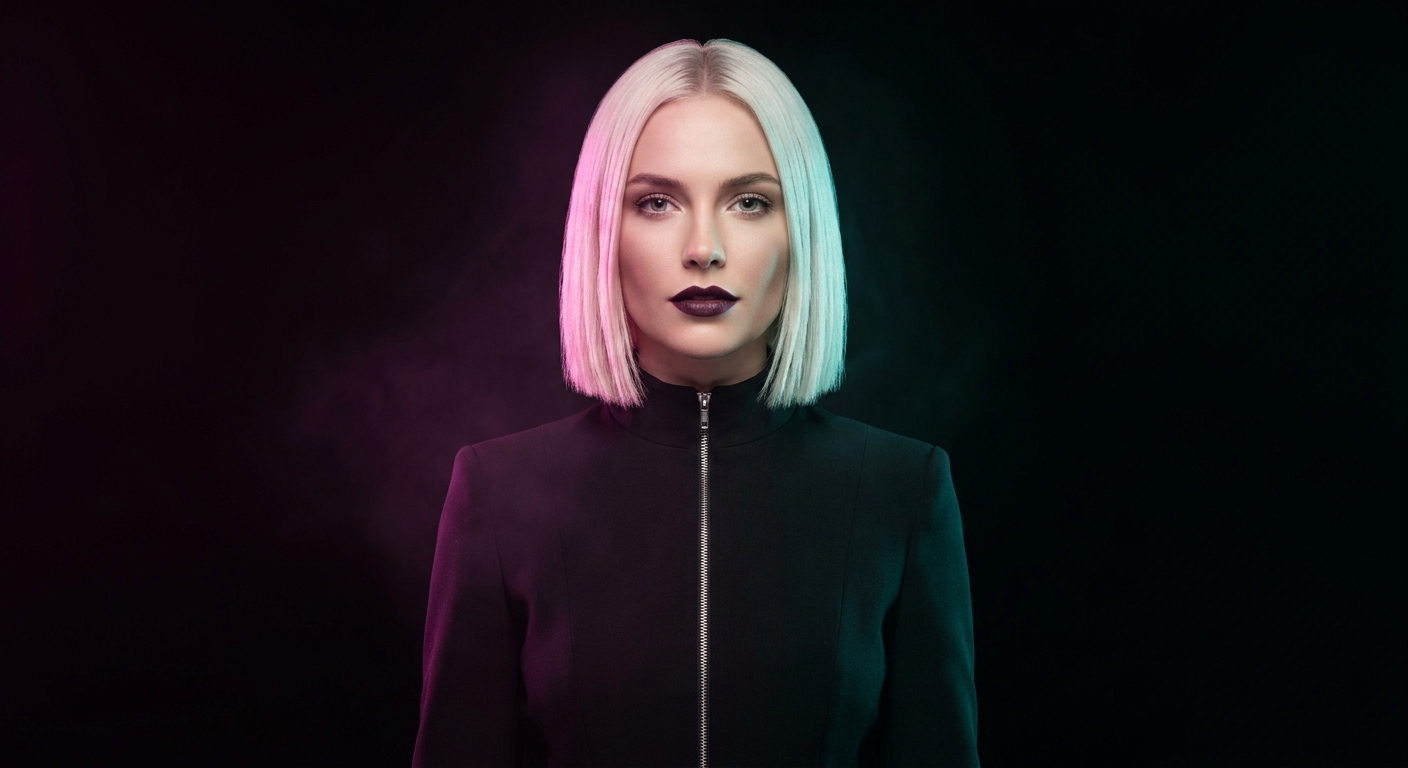
Este guia cria um narrador, uma voz fictícia de campanha que chamamos de Isla Marr, e faz com que ela leia uma fala sobre três clipes não relacionados: uma passarela, uma viagem noturna e uma festa na cobertura. Cada clipe também recebe uma trilha musical e um efeito sonoro, posicionados sob a voz no Studio. Cada clipe e cada fala são resultados reais; o modelo e a voz nunca mudaram entre eles.
O que dá errado e a correção
| Erro | Por que prejudica | Corrigir |
|---|---|---|
| Escolher a voz manualmente a cada vez | Uma sessão no v3, a próxima no Turbo, e o mesmo nome soa diferente | Salve o modelo e a voz em um personagem e use Falar como |
| Escolher um modelo sem lista de vozes | MiniMax Speech, Inworld, Dia e Orpheus não publicam vozes nomeadas, então não há nada para fixar | Use ElevenLabs ou Kokoro para um narrador recorrente |
| Dar ao personagem um clipe de voz e esperar narração | A voz de um clipe é para modelos que aceitam uma faixa de referência; a conversão de texto em fala precisa de uma voz do catálogo | Defina uma voz do catálogo para narração, use um clipe apenas quando um modelo de vídeo solicitar |
| Alterar a velocidade por take | Mesma voz, ritmo diferente, parece que são duas pessoas | Não altere a velocidade; ajuste o roteiro ao clipe em vez disso |
| Reescrever a fala para soar mais parecida com a voz | A voz é fixa; as palavras são a variável | Escreva para a voz que você salvou e mantenha o comprimento das frases constante |
Antes de começar
- Um personagem na página de Personagens. Para criar um, você precisa de um nome e pelo menos uma foto: clique em Adicionar imagens de referência, envie a foto, dê um nome ao personagem e clique em Criar personagem. O nosso é um retrato gerado, então nenhuma pessoa real está envolvida.
- Um modelo de fala com vozes nomeadas. O diálogo Voz lista apenas essas: os modelos ElevenLabs e Kokoro.
- Os clipes que você quer narrar, na sua Biblioteca. Os nossos são três clipes de cinco segundos sem som: a pista de decolagem e o terraço no Kling v3, a viagem noturna no Seedance 2.5.
Salve a voz no personagem
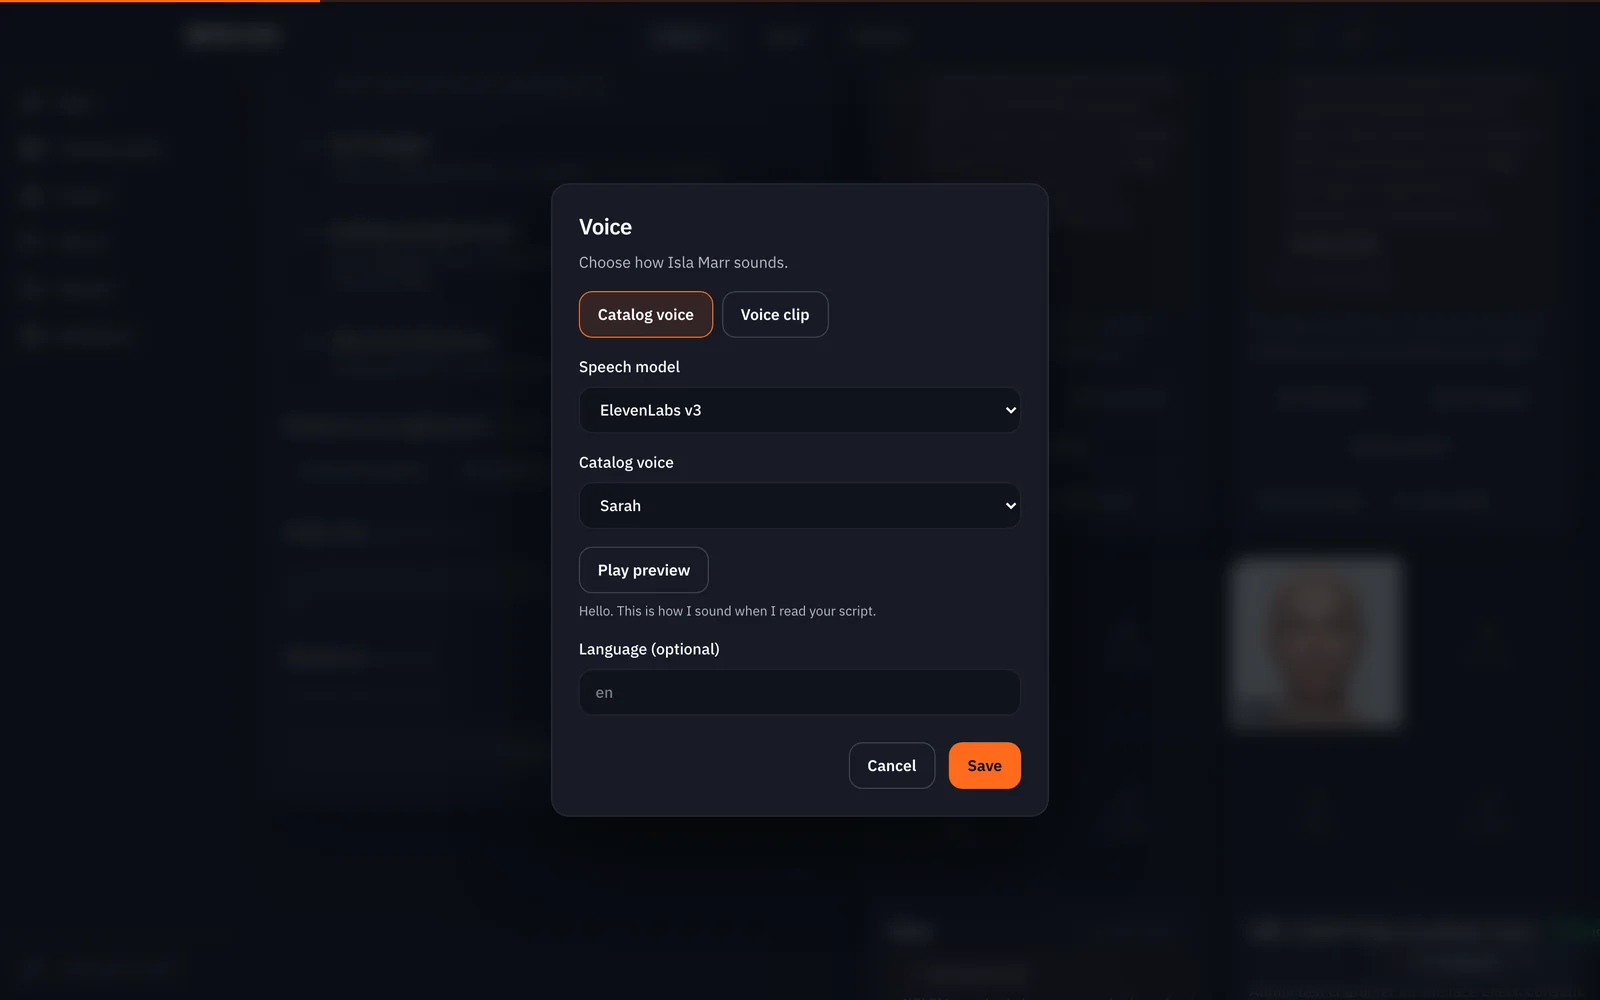
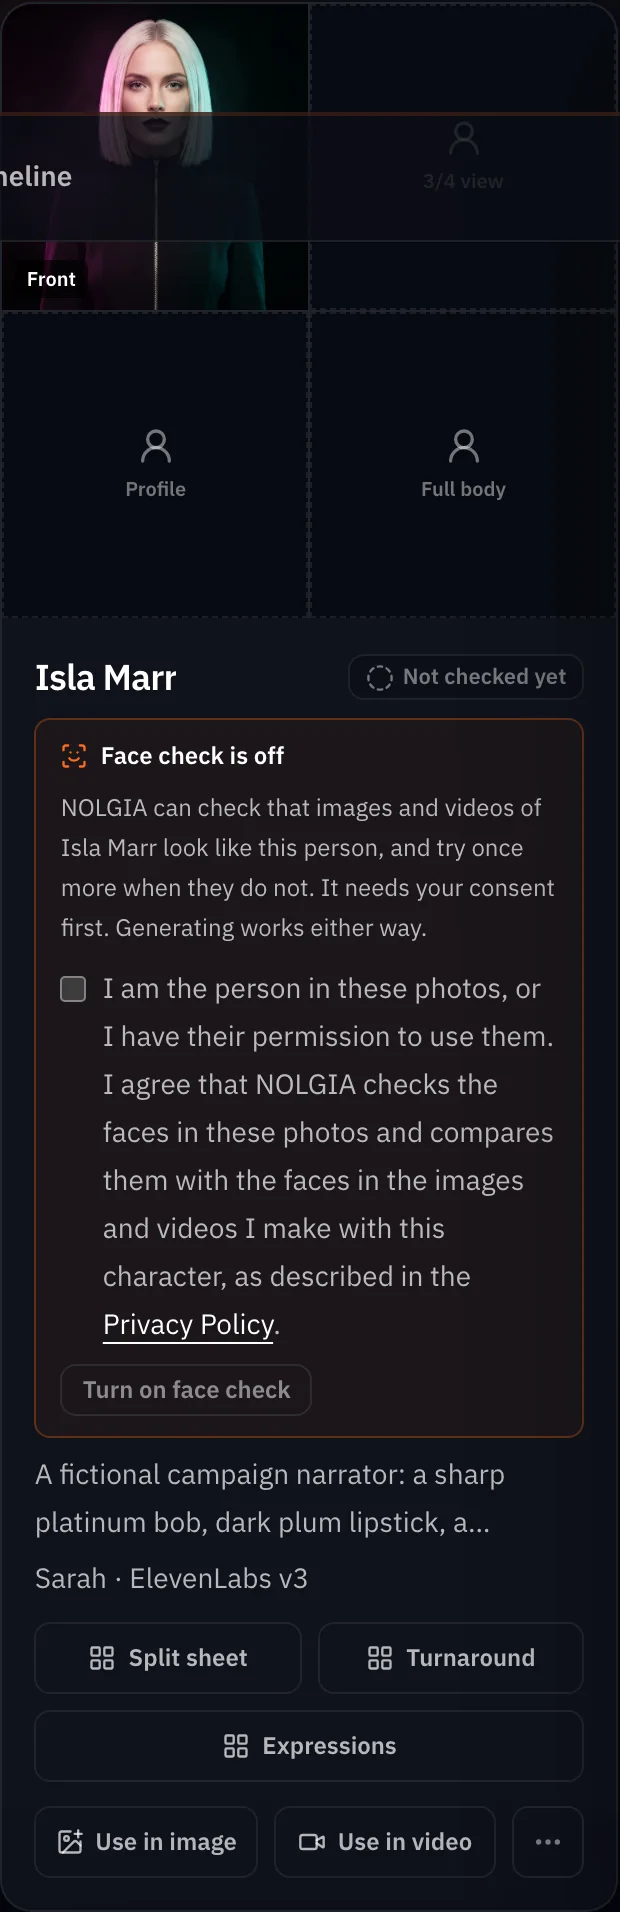
Na página Personagens, abra o menu ... no card do personagem e escolha Voz. O diálogo oferece dois tipos: Voz do catálogo e Clipe de voz. Mantenha Voz do catálogo. Escolha o Modelo de fala, depois a Voz do catálogo; um botão Reproduzir prévia toca uma amostra gravada dessa voz gratuitamente. Adicione um idioma se quiser, depois Salvar. O card agora mostra a voz abaixo da descrição.
Narre com Falar como
Abra o compositor de áudio na tarefa de Narração e pressione Falar como. Escolha o personagem. O seletor de modelos muda para o modelo salvo e a lista de Vozes para a voz salva, e uma linha abaixo do botão confirma: Falando como Isla Marr · Sarah. Digite a fala e pressione Gerar áudio. Fizemos isso cinco vezes seguidas para dois guias, e o par nunca mudou.
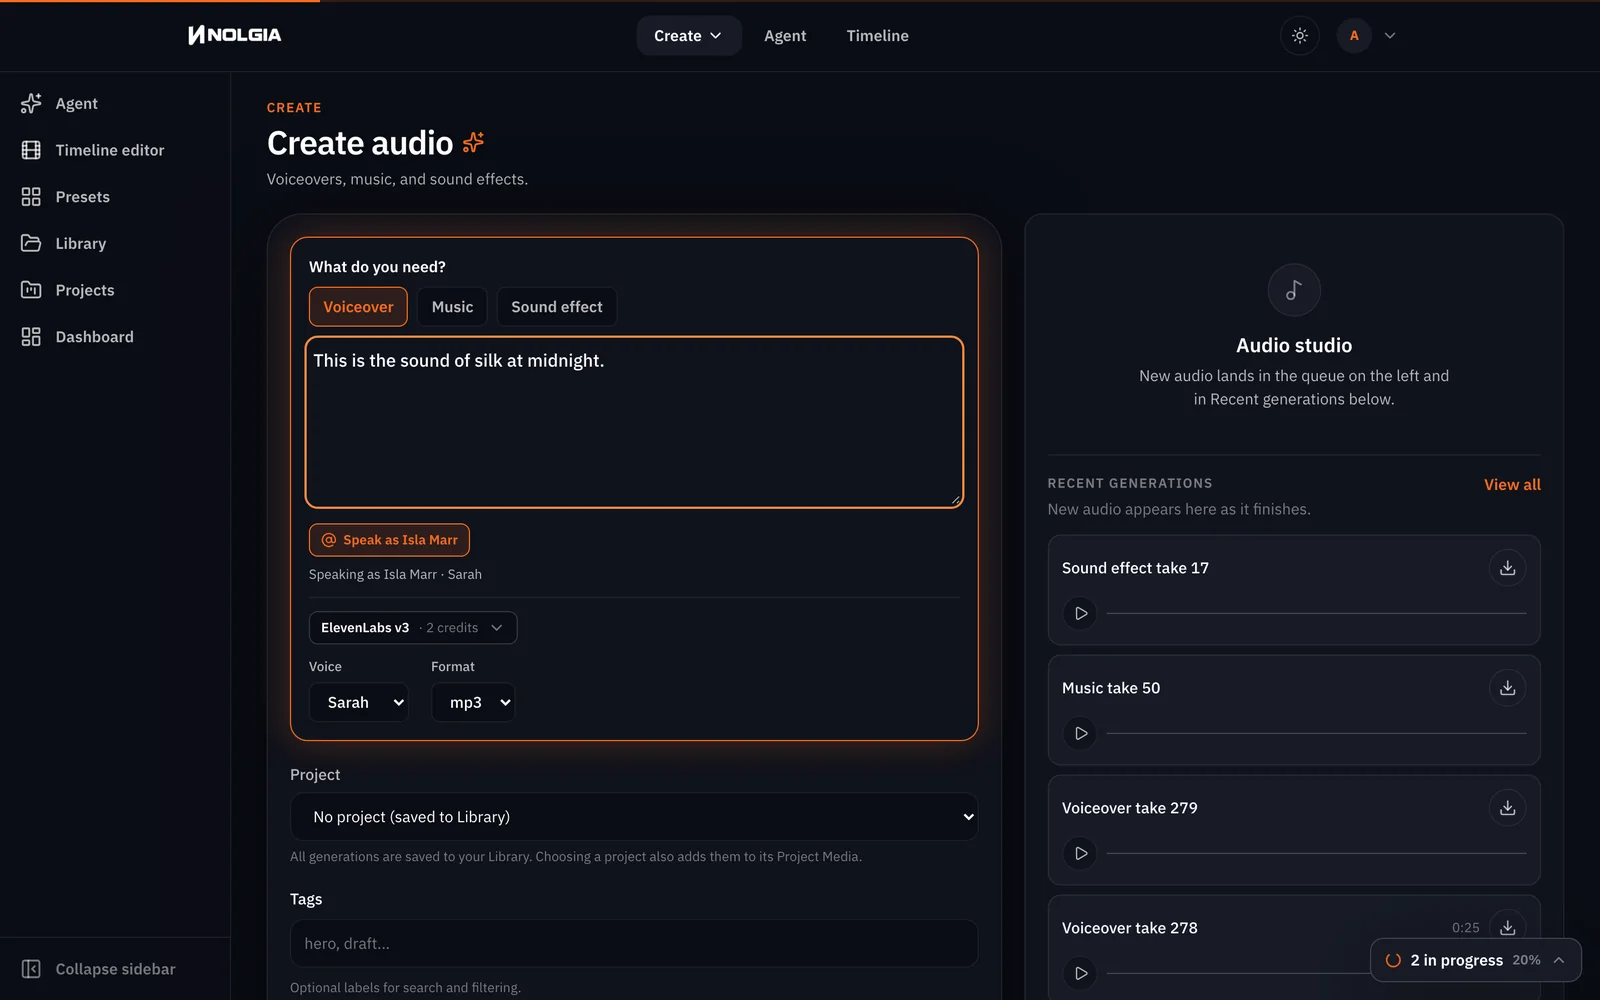
This is the sound of silk at midnight.Nothing here was built to stand still.You already know the ending. Wear it anyway.Atenção:Se a nota disser que a voz está indisponível. Falar como verifica se o modelo salvo ainda publica a voz salva. Se uma voz sair do catálogo, a nota pede que você escolha outra na página Personagens, em vez de ler com uma voz substituta.
Coloque uma trilha e um efeito sonoro sob a voz
Uma fala isolada soa vazia. Crie uma base musical na tarefa Música do compositor de áudio e um efeito sonoro em Efeito sonoro, depois monte a linha do tempo de cada clipe no Studio: Timelines, Nova linha do tempo, e na aba Biblioteca do painel esquerdo, o clipe com seu +, a tomada na posição do cursor onde a fala começa, a base e o efeito.
Dica:O Studio abaixa a base sob a voz. Uma linha do tempo criada hoje é mixada na exportação: a música abaixa cerca de 12 dB enquanto alguém fala, a base faz fade de saída no final e o volume é equalizado. Para definir um nível manualmente, selecione um som e abra o inspetor Áudio: Volume do clipe, Fade de entrada e Fade de saída, Abaixar sob a voz, e o Volume da faixa da trilha. Nossas três linhas do tempo foram cortadas antes de o Studio ter esses recursos, então escolhemos uma passagem suave de cada base: peça ao modelo de música por dinâmicas fortes, reproduza a faixa na Prévia da origem, pressione Marcar entrada onde um compasso completo leva a uma passagem suave, Marcar saída cinco segundos depois, e pressione + com o cursor em 0. Isso ainda dá espaço para a fala sem um abaixamento perceptível.
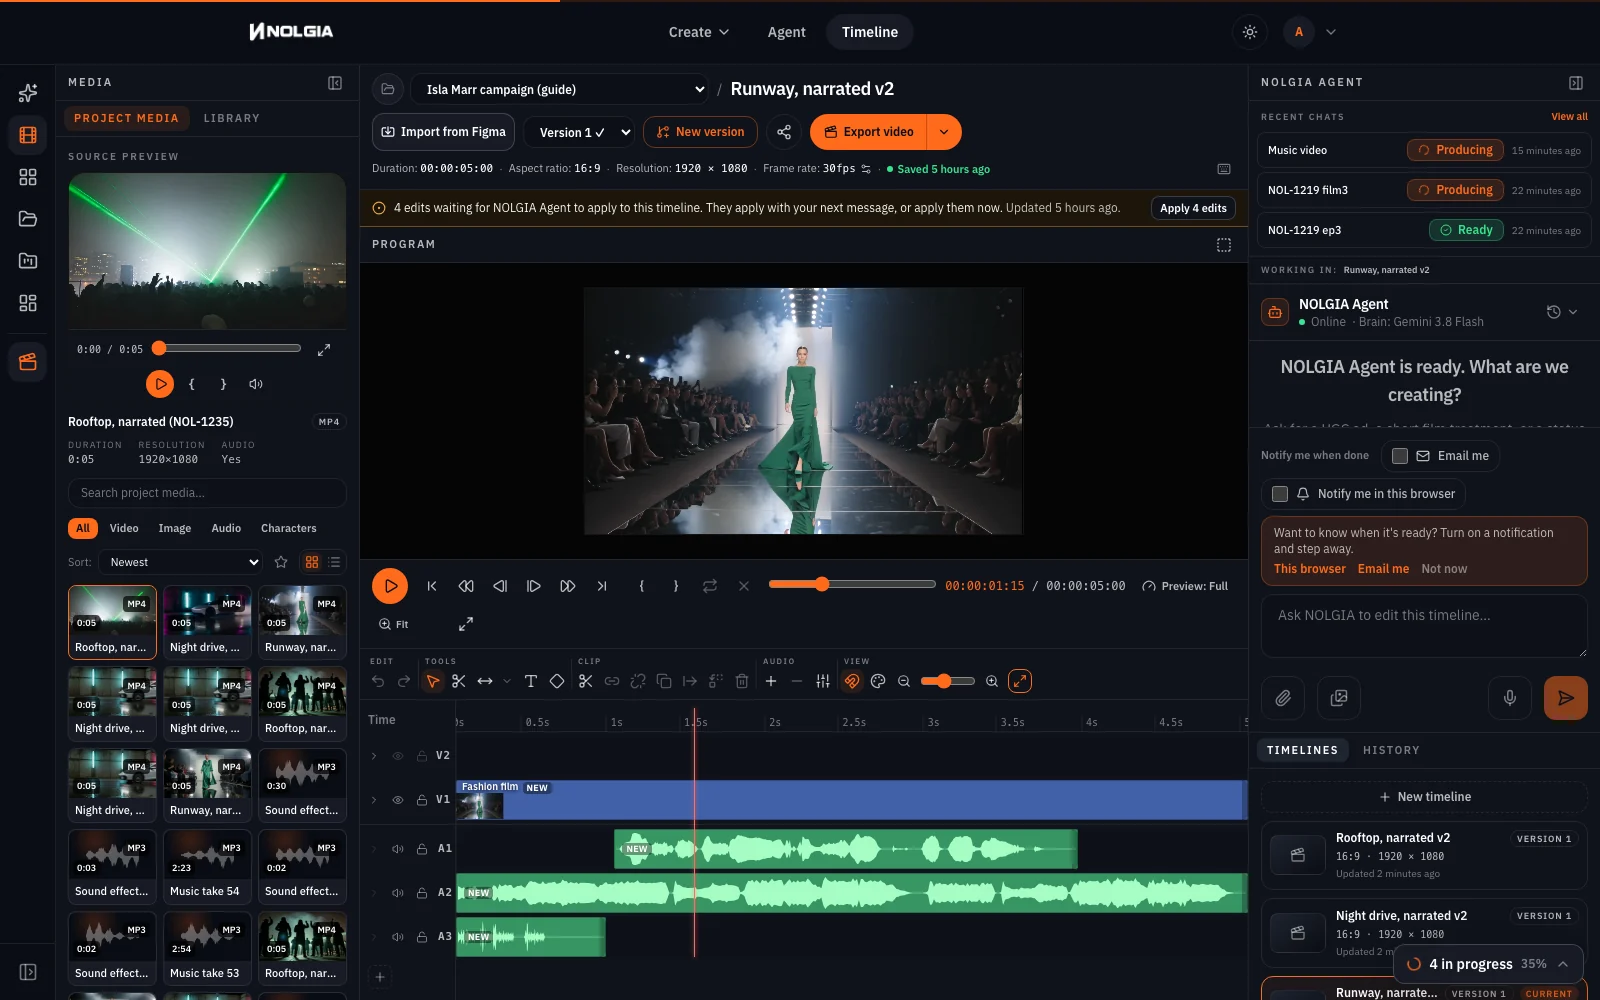
Sleek fashion-show runway track, 120 bpm, deep kick and a crisp clicking hi-hat, glossy synth stabs, instrumental, no vocals. Strong dynamics: two seconds of the full groove, then four seconds of a hushed, near-silent filtered pulse, then the full groove slams back in, and that shape repeats through the track.Dark synthwave night-drive track, 100 bpm, driving analog bass arpeggio, gated snare, cold pads, instrumental, no vocals. Strong dynamics: two seconds of the full drive, then four seconds of a sparse, hushed passage with only a low filtered bass, then the full drive returns, and that shape repeats through the track.Warehouse rave build for a rooftop party at night, 128 bpm, instrumental, no vocals: a soft muffled kick and a quiet rising filtered riser that builds for five seconds, then a huge drop with open hi-hats and a big supersaw lead, and that quiet build and big drop repeat through the track.As pistas são uma linha curta cada no ElevenLabs Sound Effects v2, cortadas com Mark Out para não interferir na voz: obturadores de câmera para o primeiro segundo da passarela, o motor e o jato d'água após a fala da cena de direção, e uma torcida da multidão enquanto os confetes do terraço caem. Pressione play: a voz é a mesma nas três cenas porque o modelo e a voz foram a mesma solicitação cada vez, e ela fica acima da música.
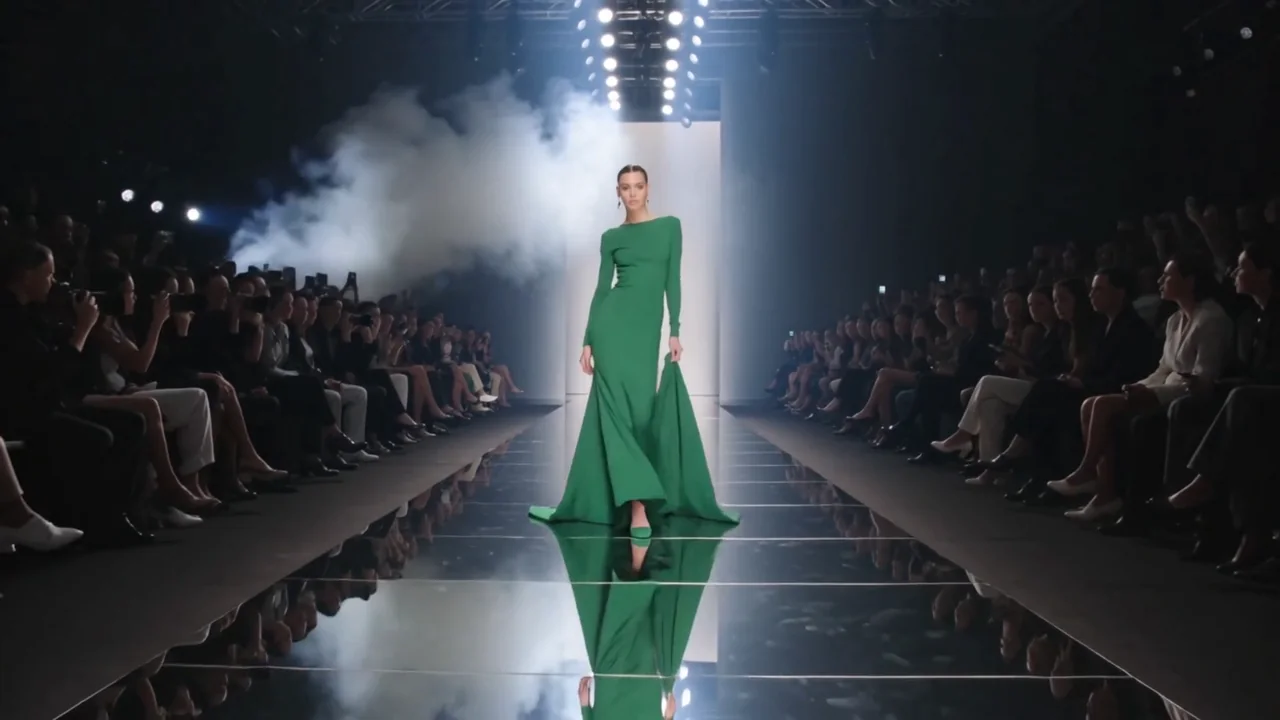
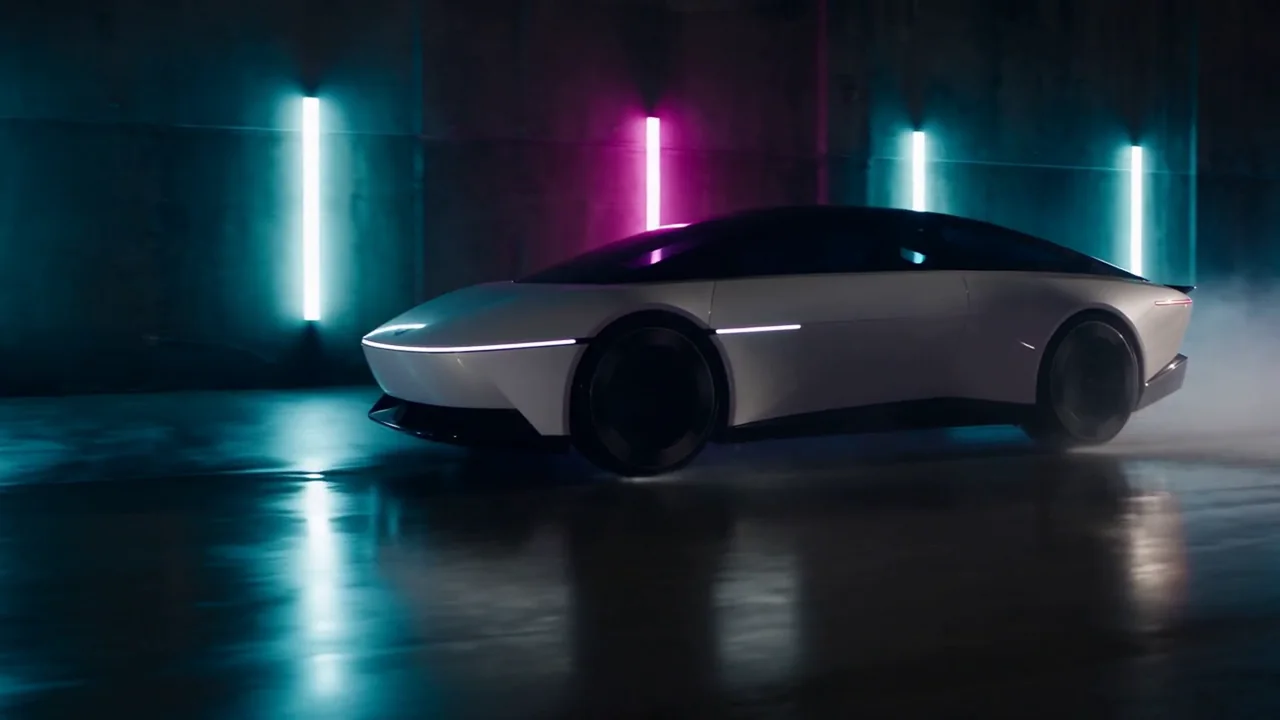
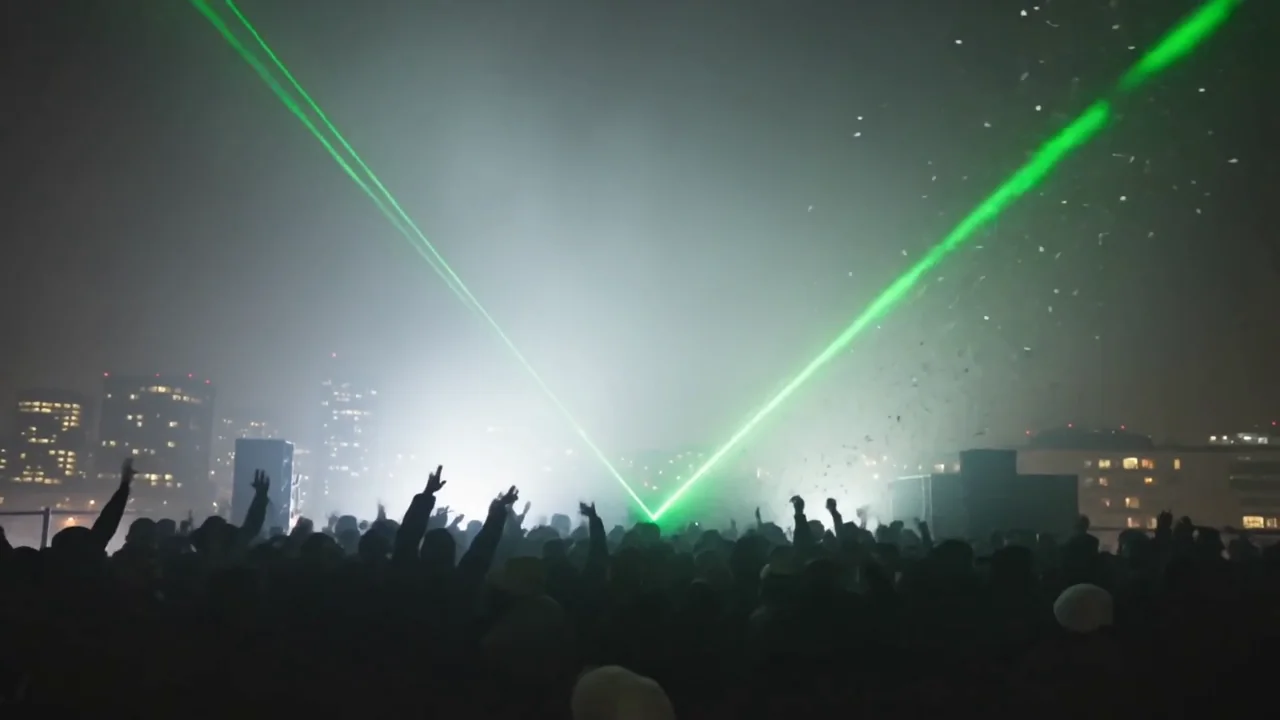
Medimos cada exportação: nenhum intervalo de silêncio maior que meio segundo, e a voz pelo menos 3 dB acima de tudo o mais enquanto ela fala. Essas linhas do tempo misturaram todas as faixas no mesmo nível, então esses números vêm das passagens que escolhemos, não de uma configuração.
Três formas de executar
| Caminho | Como | Melhor quando |
|---|---|---|
| Mais rápido | Compositor de áudio, Falar como, uma linha por vez | Um punhado de falas para uma edição que você está fazendo agora |
| Sem esforço | Dê instruções ao NOLGIA Agent com o nome do personagem; ele pode listar seus personagens e gerar áudio com a voz salva | Uma série de episódios a partir de um roteiro |
| Mais controle | A API: POST /generate/audio com o id do personagem, ou a ferramenta MCP nolgia_text_to_audio do seu próprio código | Narração em lote a partir de um documento ou de um pipeline |
O caminho da API está documentado em Personagens e locações: a voz de um personagem é usada pela geração de áudio com o id do personagem, e pela geração de vídeo quando você solicita a voz do personagem. Executamos o caminho do compositor para este guia, não os outros dois.
Onde você ainda precisa regenerar
- A entrega ainda varia um pouco. Mesma voz, mesmo modelo, mas cada gravação é uma nova leitura. Se uma fala soar plana, execute novamente; a voz não mudará.
- Uma trilha que ainda cobre uma palavra. A exportação abaixa a música sob a voz, mas uma passagem alta ainda pode abafar uma fala. Reduza o Volume do clipe da trilha no inspetor de Áudio, ou mova o Mark In para uma passagem mais calma.
- Sua própria voz é selecionada manualmente. Em um plano pago, Criar voz personalizada na lista de Vozes do compositor de áudio clona sua voz a partir de 10 segundos a 5 minutos de gravações, nos modelos de fala da ElevenLabs. O diálogo de voz da página de Personagens salva apenas vozes do catálogo e clipes de voz, então Falar como ainda não pode usar uma voz personalizada: escolha-a na lista de Vozes a cada vez. Um clipe de voz em um personagem é uma referência para modelos que aceitam uma, não uma voz de texto para fala.
- A velocidade é apenas via API. O compositor não possui controle de velocidade no momento.
Quanto custa
Salvar uma voz não custa nada; visualizar uma voz não custa nada. Cada linha cobra a taxa por caractere do modelo com um mínimo. Cada trilha musical e cada marcação são uma cobrança fixa. Os clipes foram cobrados por duração, e as exportações do Studio não são cobradas.
ElevenLabs v3Every plan
Per 1,000 characters
Standard 6 créditos
Lyria 3.5Every plan
Per generation
Standard 5 créditos
Stable Audio 3 MediumEvery plan
Per generation
Standard 3 créditos
ElevenLabs SFXEvery plan
Per generation
Standard 4 créditos
Kling v3Pro and up
Per 5s clip (audio on by default)
720p 35 créditos · 1080p 47 créditos · 4K 117 créditos
Seedance 2.5Pro and up
Per 5s clip
480p 26 créditos · 720p 56 créditos · 1080p 137 créditos
1080p renders at 16:9 and 9:16
Lido ao vivo do catálogo quando esta página carrega. Todo preço aparece antes de você gerar. Ver todas as tarifas.
Experimente você mesmo
O retrato do narrador
- Retrato de Isla Marr, JPEG 1408x768Foto JPEG · 1408x768 · 483 KBBaixar
Fashion film, one continuous shot. A model in a sculpted emerald green floor-length gown with long sleeves walks down a mirrored runway toward the camera, camera strobes flashing from the crowd in silhouette on both sides, white haze, slow motion, low tracking shot moving backwards, anamorphic flares, deep blacks. No text, no logo.Premium car commercial, one continuous shot. An original concept coupe that resembles no production car: a low, wide, wedge-shaped matte white body with a single thin continuous light bar across the nose, no grille, no badges, a smooth flush glass canopy, enclosed rear wheel arches and a sharp ducktail rear. It slides sideways through a wet night street lined with bare concrete walls and plain vertical neon tubes in teal and magenta, no shop windows, no signs, no lettering anywhere. Rain streaks in the air, neon reflections stretched across the asphalt, low side tracking shot, spray from the tyres, motion blur on the passing lights, cinematic contrast.Music video, one continuous shot. A rooftop rave at night: a dense crowd in silhouette wearing long dark coats, hoodies and bucket hats, arms raised, under sharp green laser beams fanning through a thick haze layer, confetti bursting in slow motion, a city skyline of blurred lights behind them, low handheld camera looking up, backlit, high contrast. No text, no logo.Seus clipes e trilhas não corresponderão aos nossos; um prompt fornece ao modelo a cena ou o clima, não a tomada, então encontre sua própria passagem suave para a Marca de Entrada. A voz corresponderá, porque o personagem a carrega.
Checklist
- O personagem existe com um nome e uma foto.
- Diálogo de voz: Voz do catálogo, um modelo com vozes nomeadas, prévia reproduzida, salva.
- Compositor de áudio: Falar como mostra o personagem e a nota nomeia a voz.
- Uma geração por linha; verifique cada tomada antes de cortar.
- Uma trilha musical solicitada com dinâmicas fortes, e uma marca por clipe.
- Studio: clipe, tomada na cabeça de reprodução, uma janela de trilha de cinco segundos de uma passagem suave, a marca livre da voz, Exportar vídeo.
Perguntas e respostas
- Quais modelos podem ser a voz de um personagem?
- Aqueles que publicam vozes com nome: os modelos de fala da ElevenLabs com dez vozes e o Kokoro com vinte. MiniMax Speech, Inworld, Dia e Orpheus não têm lista de vozes, então o diálogo não os oferece.
- Todas as tomadas soarão idênticas?
- A voz e o modelo são idênticos. A leitura em si é gerada do zero a cada vez, então o ritmo e a ênfase podem variar um pouco entre as tomadas. Repita uma linha que você não gostar; a voz permanece.
- Posso usar minha própria voz?
- Sim, em um plano pago. No compositor de áudio, em um modelo de fala da ElevenLabs, abra a lista de Vozes e escolha Criar voz personalizada: grave ou envie de 10 segundos a 5 minutos de uma pessoa falando, confirme que é a sua voz ou que você tem a permissão do falante, e ela lerá qualquer roteiro a partir de então. Um personagem ainda não pode ter uma voz personalizada, então escolha-a na lista de Vozes. Um clipe de voz em um personagem, de 3 a 30 segundos, é uma referência para modelos que aceitam uma faixa de referência.
- Um modelo de vídeo pode usar a voz do personagem?
- A API tem uma opção para isso na geração de vídeo. Não testamos isso para este guia, então não descrevemos como soa.
- Para que serve o campo de idioma?
- Uma tag opcional, como en ou en-US, armazenada com a voz, indicando o idioma que o personagem fala. Deixe em branco se não tiver certeza.
- O Studio pode baixar o volume da música sob a voz para mim?
- Sim. Em uma linha do tempo criada hoje, a exportação reduz a música em cerca de 12 dB enquanto alguém fala, com a opção Duck under voice ativada por padrão para a música. Você pode desativá-la ou ajustar Clip volume, Fade in, Fade out e Track volume manualmente no inspetor de Áudio.
Fixar uma voz a um personagem
Abrir PersonagensGuias relacionados
Áudio
Voz, música e efeitos sonoros para seu vídeo
Crie uma linha de narração, uma trilha musical e um efeito sonoro no compositor de áudio, depois coloque-os sob seu clipe no Studio. Qual modelo faz qual trabalho e quanto cada um custa.
· 10 min de leitura
Canais
Um canal narrado sem rosto: as ferramentas, o fluxo de trabalho, o próximo episódio
Roteiro, uma voz de narrador salva, b-roll com um visual fixo do compositor de vídeo, a edição no Studio e o NOLGIA Agent para o próximo episódio. Dois episódios curtos feitos de verdade.
· 12 min de leitura
Agente
O livro de receitas do NOLGIA Agent: o que dizer e o que acontece em seguida
Dez mensagens que você pode enviar ao NOLGIA Agent, o que ele faz com cada uma e o preset por trás delas, desde fotos de produtos e um conjunto de listagem até uma pontuação de gancho e uma edição avaliada.
· 6 min de leitura