

你可以通过将声音保存在角色上来在所有视频中保持一致的声音。NOLGIA 上的角色携带一个 voice:一个语音模型和该模型的一个命名声音。当你在 音频编辑器 中制作旁白时,说话角色 按钮会选择角色,并将模型和声音设置为已保存的组合。你再也不需要手动选择它们,因此下个月录制的一行台词和今天录制的一行台词将由同一个声音朗读。
本指南创建了一个旁白者,一个我们命名为 Isla Marr 的虚构广告声音,并让她在三个不相关的片段上朗读一行台词:T台、夜间驾驶和屋顶派对。每个片段还在 Studio 中添加了背景音乐和一个音效,铺在声音下方。每个片段和每行台词都是真实输出;它们之间的模型和声音从未改变。
常见错误及修正
| 错误 | 为何有害 | 修正 |
|---|---|---|
| 每次手动选择声音 | 一次会话用 v3,下一次用 Turbo,同一个名字听起来却不同 | 将模型和声音保存在角色上,并使用 说话角色 |
| 选择没有声音列表的模型 | MiniMax Speech、Inworld、Dia 和 Orpheus 不发布命名声音,因此没有可固定的选项 | 对于重复出现的旁白者,使用 ElevenLabs 或 Kokoro |
| 给角色上传语音片段并期望用于旁白 | 片段语音适用于需要参考音轨的模型;文本转语音需要目录语音 | 为旁白设置目录语音,仅在视频模型要求时使用片段语音 |
| 每次拍摄都改变语速 | 同一声音,不同语速,听起来像两个人 | 保持语速不变;调整脚本以适配片段 |
| 重写台词以使其更贴近该声音 | 声音是固定的;文字是可变的 | 为你保存的声音撰写内容,并保持句子长度稳定 |
开始之前
- 在角色页面上创建一个角色。创建角色需要名称和至少一张照片:点击添加参考图片,上传照片,为角色命名,然后点击创建角色。我们使用的是生成的人像,因此不涉及真实人物。
- 一个具有命名声音的语音模型。声音对话框仅列出这些模型:ElevenLabs 模型和 Kokoro。
- 你需要旁白的片段,已保存在你的素材库中。我们的是三个无声音的五秒片段:Kling v3 上的跑道和屋顶场景,Seedance 2.5 上的夜间驾驶场景。
在角色上保存声音
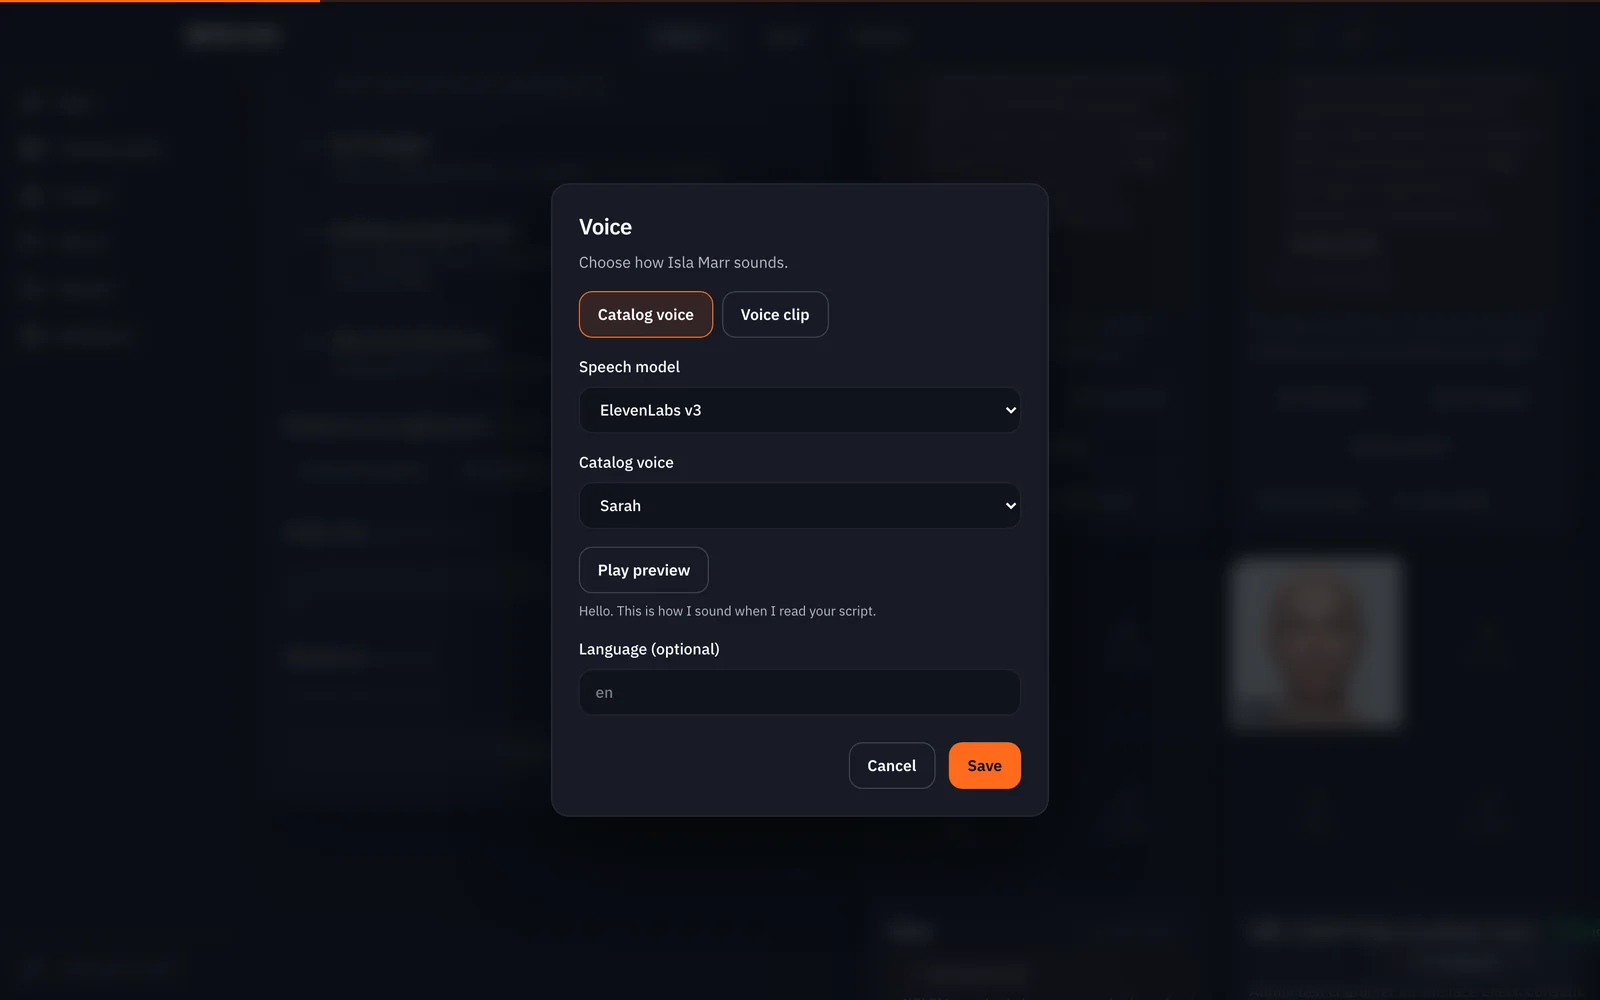
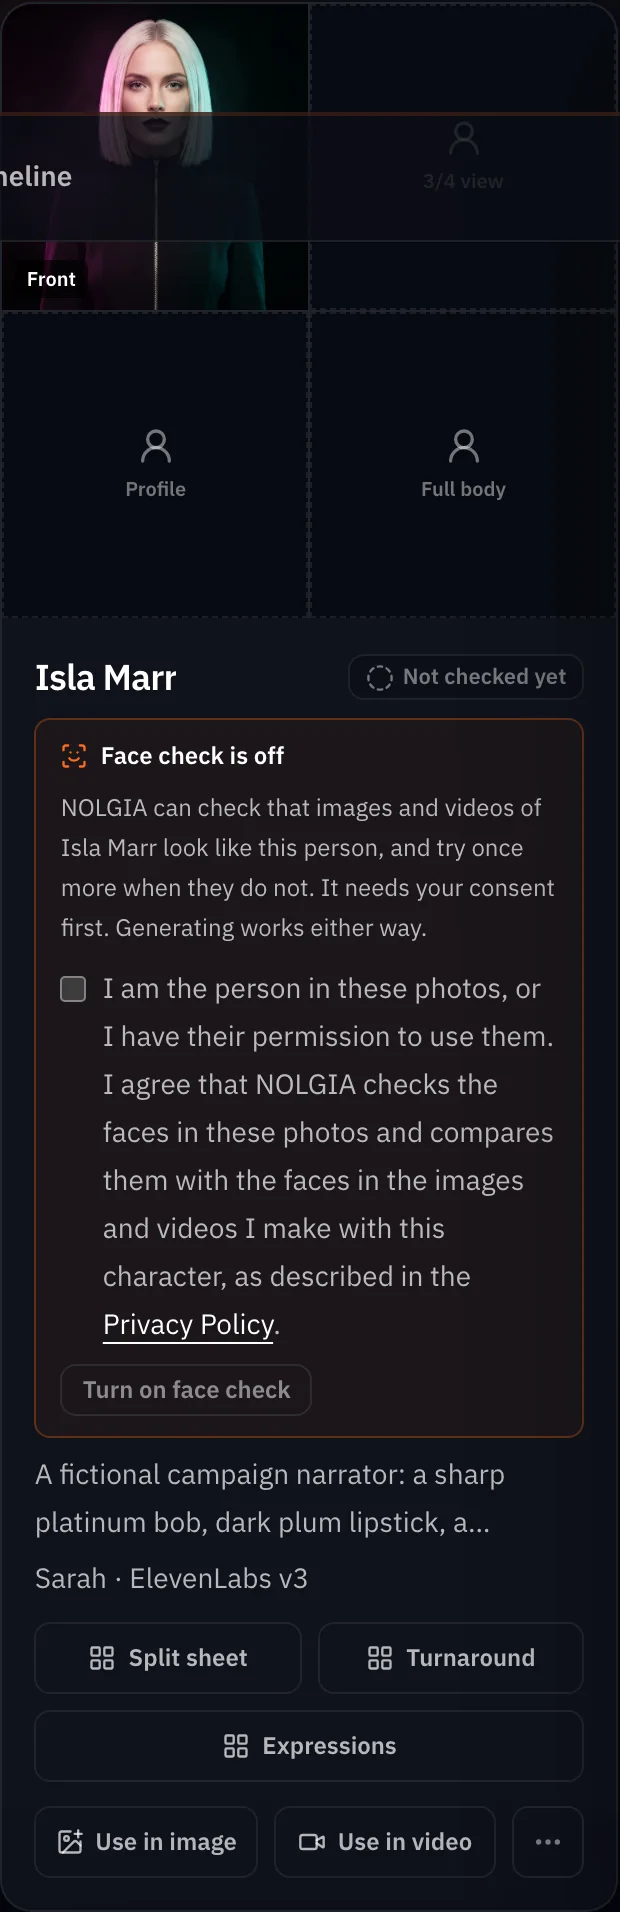
在“角色”页面上,打开角色卡片上的 ... 菜单,然后选择 声音。对话框提供两种类型:目录音色 和 语音片段。保持选择“目录音色”。选择 语音模型,然后选择 目录音色;点击 播放预览 按钮可免费播放该音色的录音样本。如果需要,可以添加语言,然后点击 保存。现在,卡片会在描述下方显示所选音色。
使用“说话角色”进行旁白
在配音任务中打开音频编辑器,然后按 说话角色。选择角色。模型选择器会切换到已保存的模型,语音列表会切换到已保存的语音,按钮下方的一行文字会确认这一点:正在以 Isla Marr · Sarah 的身份说话。输入台词并按 生成音频。我们在两个指南中连续这样做了五次,这对组合从未改变。
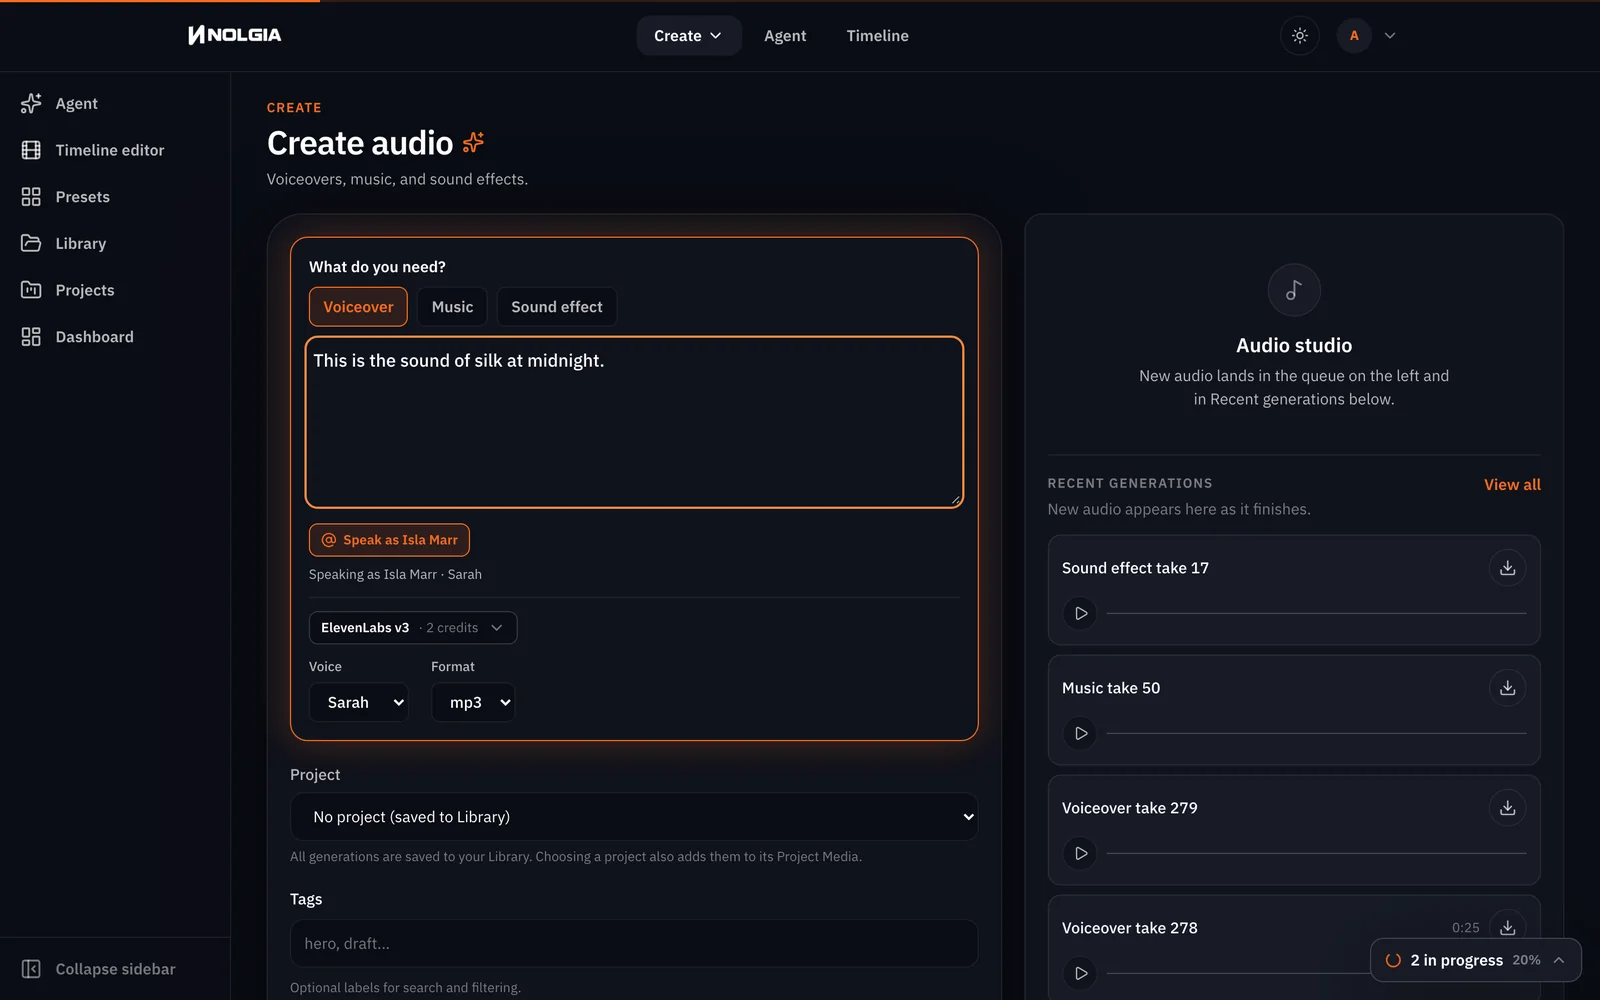
This is the sound of silk at midnight.Nothing here was built to stand still.You already know the ending. Wear it anyway.注意:如果提示显示语音不可用. “说话角色”会检查已保存的模型是否仍发布已保存的语音。如果某个语音从目录中移除,提示会告诉你在“角色”页面选择另一个语音,而不是使用替身语音朗读。
在语音下方添加背景音乐和音效
单独一句台词显得单薄。在音频合成器的 音乐 任务中制作背景音乐,在 音效 任务中制作一个音效提示,然后在 Studio 中为每个片段构建时间线:点击“时间线”、“新建时间线”,在左侧面板的“素材库”标签页中,通过 + 添加片段,将台词放置在播放头处(即台词开始的位置),然后添加背景音乐和音效提示。
提示:Studio 会在人声出现时降低背景音乐音量. 今天创建的时间线在导出时会自动混音:有人说话时音乐音量降低约 12 dB,背景音乐在结尾淡出,响度也会均衡。若要手动设置音量,请选择一个声音并打开 音频 检查器:使用 片段音量、淡入 和 淡出、在人声下闪避,以及轨道的 轨道音量。我们的三个时间线是在 Studio 具备这些功能之前剪辑的,因此我们选择了每段背景音乐中安静的部分:向音乐模型请求强烈的动态变化,在 源预览 中播放音轨,在完整小节进入安静段落的位置按 标记入点,五秒后按 标记出点,并将播放头置于 0 处按 +。这样既为台词留出了空间,又不会让人察觉到明显的音量降低。
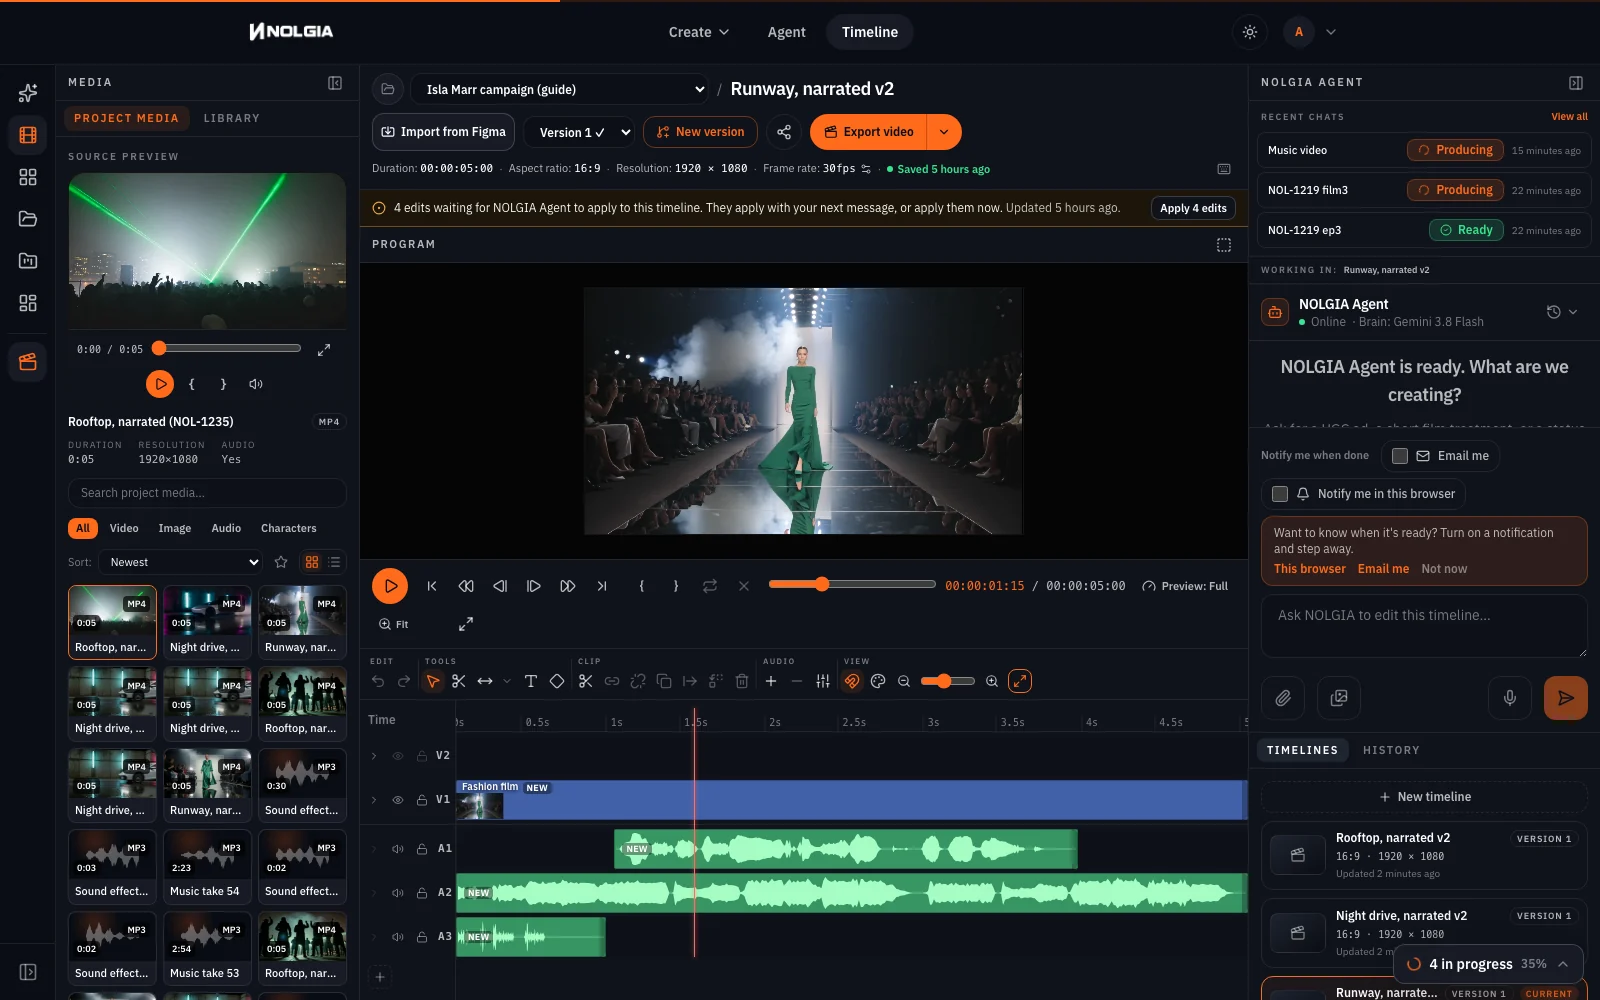
Sleek fashion-show runway track, 120 bpm, deep kick and a crisp clicking hi-hat, glossy synth stabs, instrumental, no vocals. Strong dynamics: two seconds of the full groove, then four seconds of a hushed, near-silent filtered pulse, then the full groove slams back in, and that shape repeats through the track.Dark synthwave night-drive track, 100 bpm, driving analog bass arpeggio, gated snare, cold pads, instrumental, no vocals. Strong dynamics: two seconds of the full drive, then four seconds of a sparse, hushed passage with only a low filtered bass, then the full drive returns, and that shape repeats through the track.Warehouse rave build for a rooftop party at night, 128 bpm, instrumental, no vocals: a soft muffled kick and a quiet rising filtered riser that builds for five seconds, then a huge drop with open hi-hats and a big supersaw lead, and that quiet build and big drop repeat through the track.音效在 ElevenLabs Sound Effects v2 中各为一行简短提示词,并使用 Mark Out 进行修剪,以免干扰人声:走秀前 1 秒的相机快门声,驾驶台词后的引擎和喷水声,以及屋顶彩带飘落时的欢呼声。点击播放:由于每次请求使用的模型和声音相同,因此三个片段中的人声保持一致,且位于音乐之上。
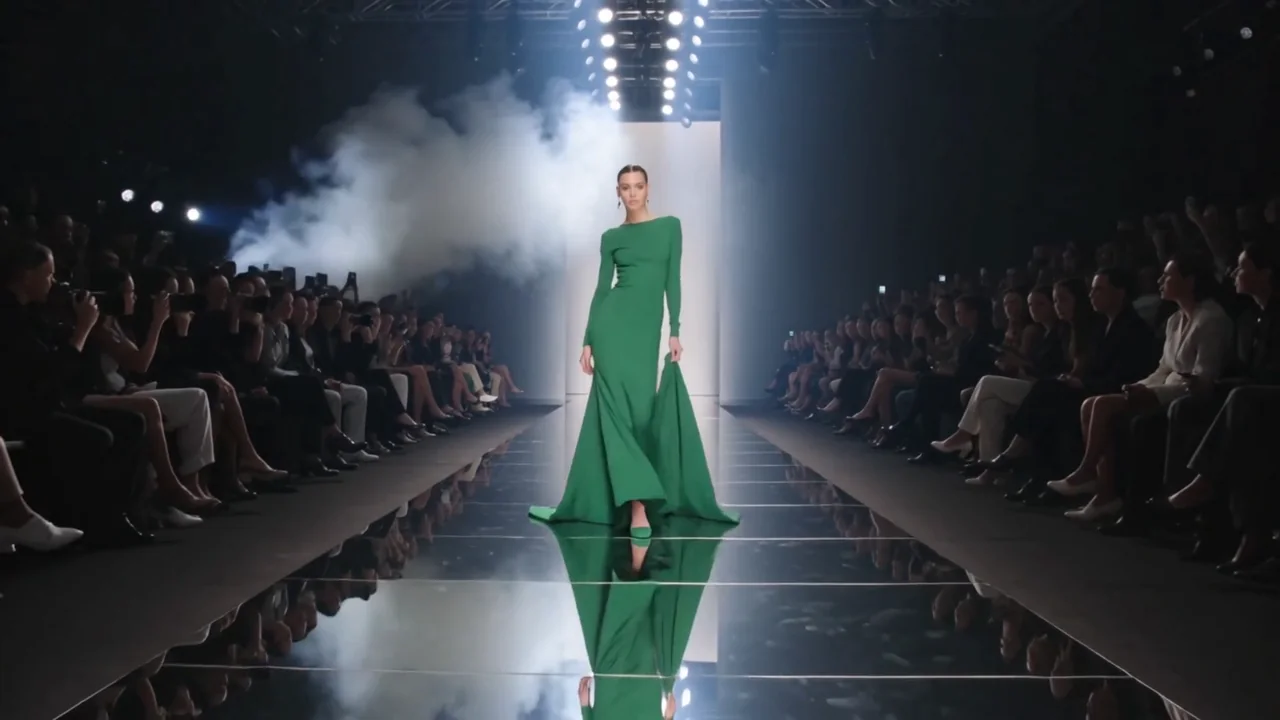
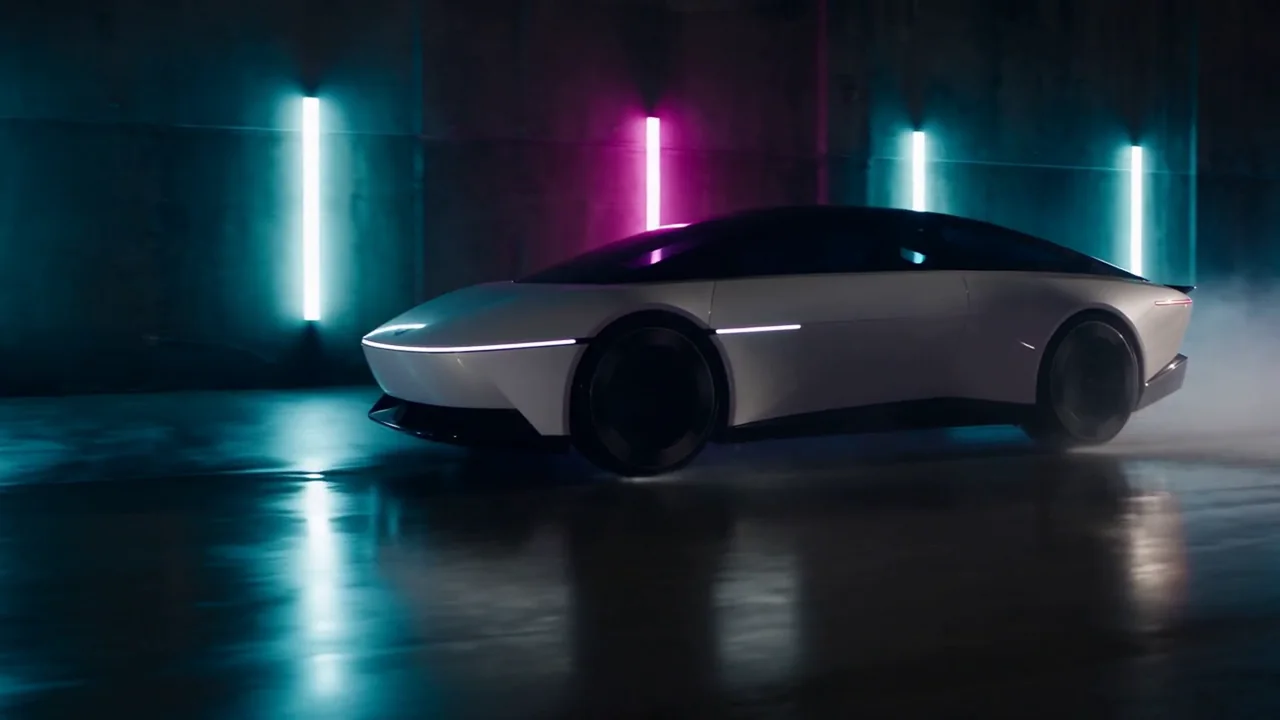
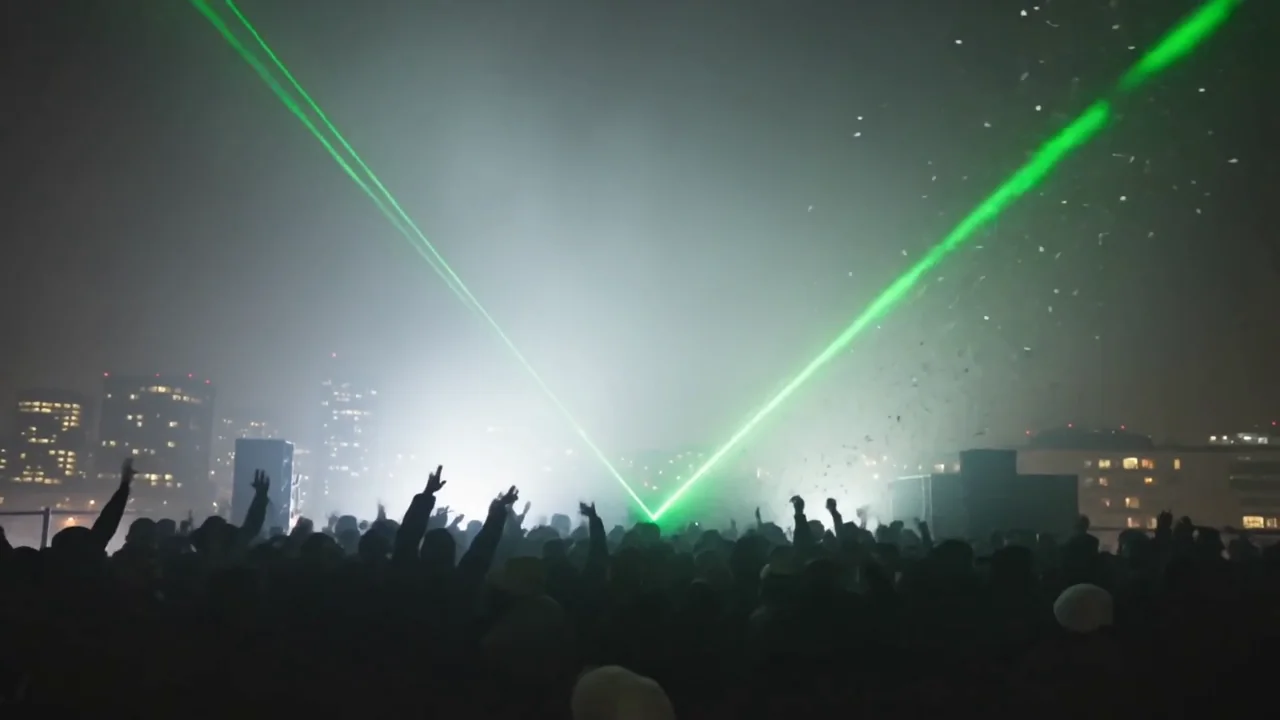
我们测量了每个导出文件:没有超过半秒的静音间隙,且在她说话时,人声至少比其他所有声音高 3 dB。这些时间线以相同电平混合了所有轨道,因此这些数字来自我们选择的片段,而非某个设置。
三种运行方式
| 路径 | 方法 | 最佳场景 |
|---|---|---|
| 最快 | 音频合成器,Speak as,一次一行 | 为你正在制作的剪辑添加几行台词 |
| 全自动 | 向 NOLGIA Agent 提供角色名称;它可以列出你的角色并使用保存的声音生成音频 | 根据脚本制作一系列剧集 |
| 控制最多 | API:使用角色 id 调用 POST /generate/audio,或在你的代码中使用 MCP 工具 nolgia_text_to_audio | 从文档或流程中批量生成旁白 |
API 路径记录在 角色和地点 中:音频生成会使用角色 id 来应用角色声音,视频生成时如果你请求使用角色声音也会应用。本指南运行的是作曲器路径,而非其他两个。
仍需重新生成的情况
- 交付效果仍有细微差异。 声音相同,模型相同,但每次录制都是新的演绎。如果某句台词表现平淡,请重新运行;声音本身不会改变。
- 背景音乐仍可能盖住某个词。 导出时音乐会在人声下自动降低音量,但响亮的乐段仍可能挤占台词空间。在音频检查器中降低背景的 片段音量,或将标记入点移至较安静的乐段。
- 你的专属声音由人工挑选。在付费套餐中,音频编辑器声音列表中的创建自定义音色功能,可基于 ElevenLabs 语音模型,使用 10 秒至 5 分钟的录音克隆你的声音。角色页面的声音对话框仅保存目录声音和声音片段,因此“以...身份说话”功能目前尚不支持自定义声音:每次使用时请在声音列表中选择。角色上的声音片段是供支持该功能的模型使用的参考,而非文本转语音的声音。
- 速度仅通过 API 控制。编辑器目前不提供速度控制选项。
费用说明
保存声音不收费;预览声音也不收费。每行文本按模型的每字符费率计费,并设有最低消费。每个背景音乐和每个提示音均为固定费用。视频片段按长度计费,而 Studio 导出不计费。
ElevenLabs v3Every plan
Per 1,000 characters
Standard 6 积分
Lyria 3.5Every plan
Per generation
Standard 5 积分
Stable Audio 3 MediumEvery plan
Per generation
Standard 3 积分
ElevenLabs SFXEvery plan
Per generation
Standard 4 积分
Kling v3Pro and up
Per 5s clip (audio on by default)
720p 35 积分 · 1080p 47 积分 · 4K 117 积分
Seedance 2.5Pro and up
Per 5s clip
480p 26 积分 · 720p 56 积分 · 1080p 137 积分
1080p renders at 16:9 and 9:16
页面加载时从目录实时读取。 所有价格都会在生成前显示。 查看所有费率.
亲自尝试
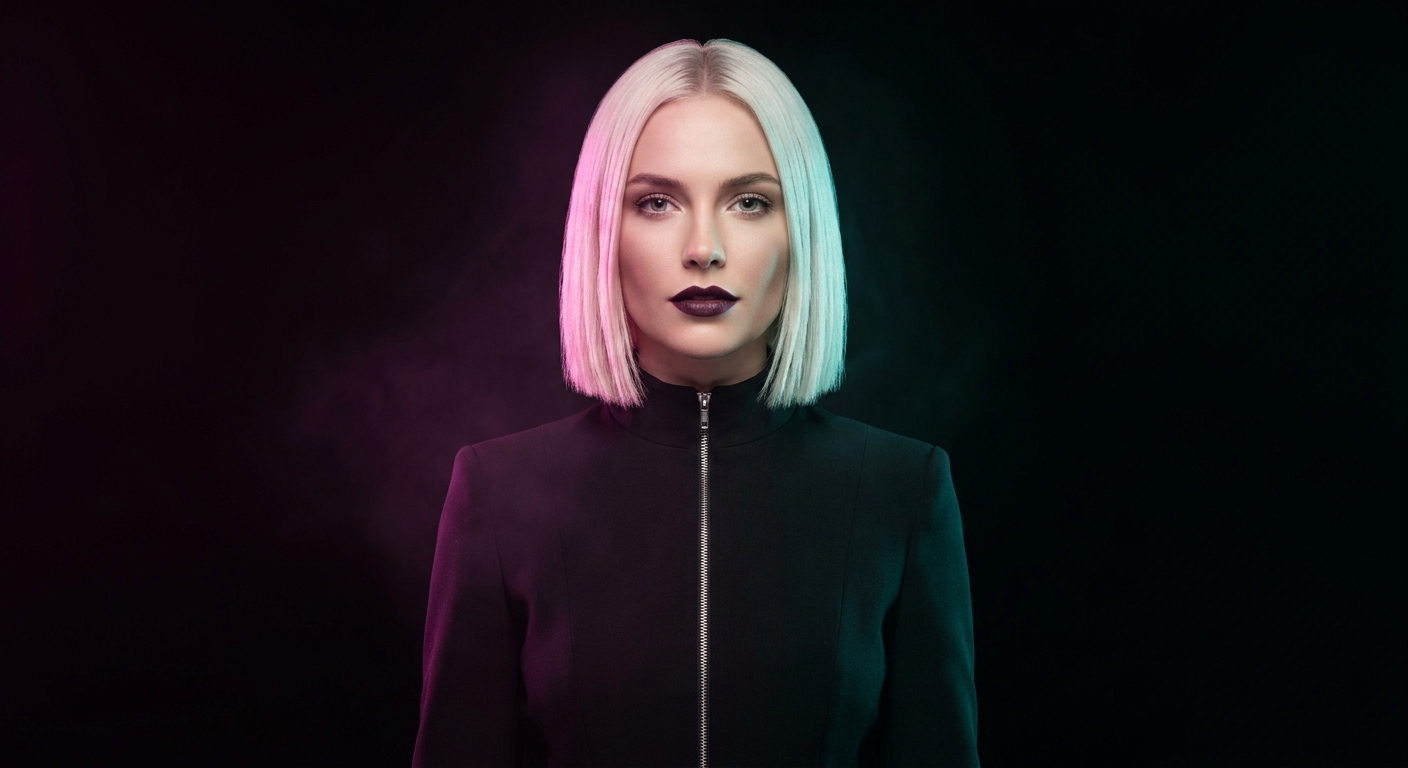
旁白者的肖像
- Isla Marr 肖像,1408x768 JPEGJPEG 照片 · 1408x768 · 483 KB下载
Fashion film, one continuous shot. A model in a sculpted emerald green floor-length gown with long sleeves walks down a mirrored runway toward the camera, camera strobes flashing from the crowd in silhouette on both sides, white haze, slow motion, low tracking shot moving backwards, anamorphic flares, deep blacks. No text, no logo.Premium car commercial, one continuous shot. An original concept coupe that resembles no production car: a low, wide, wedge-shaped matte white body with a single thin continuous light bar across the nose, no grille, no badges, a smooth flush glass canopy, enclosed rear wheel arches and a sharp ducktail rear. It slides sideways through a wet night street lined with bare concrete walls and plain vertical neon tubes in teal and magenta, no shop windows, no signs, no lettering anywhere. Rain streaks in the air, neon reflections stretched across the asphalt, low side tracking shot, spray from the tyres, motion blur on the passing lights, cinematic contrast.Music video, one continuous shot. A rooftop rave at night: a dense crowd in silhouette wearing long dark coats, hoodies and bucket hats, arms raised, under sharp green laser beams fanning through a thick haze layer, confetti bursting in slow motion, a city skyline of blurred lights behind them, low handheld camera looking up, backlit, high contrast. No text, no logo.你的片段和背景音乐可能与我们不同;提示词向模型提供的是场景或氛围,而非具体的镜头,因此请自行寻找一段安静的片段用于标记入点。声音会保持一致,因为角色承载了它。
检查清单
- 角色已存在,并设有名称和照片。
- 语音对话框:选择目录语音,即带有命名声音的模型,预览播放,保存。
- 音频合成器:“以...说话”显示角色,且备注注明了声音名称。
- 每行台词生成一次;在剪辑前检查每个镜头。
- 要求具有强烈动态变化的背景音乐,且每个片段对应一个音乐提示。
- Studio:片段,播放头处的镜头,从安静片段截取的五秒背景音乐窗口,音乐提示避开人声,导出视频。
常见问题
- 哪些模型可以作为角色的声音?
- 发布具名语音的模型:ElevenLabs 语音模型提供十种语音,Kokoro 提供二十种。MiniMax Speech、Inworld、Dia 和 Orpheus 没有语音列表,因此对话框中不会提供这些选项。
- 每次生成的音频听起来会完全一样吗?
- 语音和模型是相同的。但朗读内容每次都是新生成的,因此不同片段之间的节奏和重音可能会有细微差别。如果不喜欢某一行,可以重新生成;语音保持不变。
- 我可以使用自己的声音吗?
- 可以,但需要付费套餐。在音频编辑器中,选择 ElevenLabs 语音模型,打开“语音”列表并选择“创建自定义语音”:录制或上传 10 秒到 5 分钟的单人讲话,确认这是你的声音或你已获得说话者的许可,之后它就可以朗读任何脚本。目前角色尚不支持自定义语音,因此请在“语音”列表中选择。角色上的语音片段(3 到 30 秒)是供支持参考音轨的模型使用的参考。
- 视频模型可以使用角色的声音吗?
- API 在视频生成中有一个开关用于此功能。我们未在本指南中运行该功能,因此不描述其效果。
- “语言”字段有什么用?
- 一个可选标签,例如 en 或 en-US,随语音一起存储,表示角色所说的语言。如果不确定,请留空。
- Studio 能否在语音出现时自动降低背景音乐音量?
- 可以。对于今天创建的时间线,导出时会在有人说话时将音乐音量降低约 12 dB,且默认开启“语音下压低音乐”选项。你可以在音频检查器中关闭此功能,或自行设置“片段音量”、“淡入”、“淡出”和“轨道音量”。
为角色固定语音
打开角色相关教程
音频
为你的视频添加配音、音乐和音效
在音频编辑器中制作旁白、背景音乐和音效,然后在 Studio 中将它们铺在片段下方。了解哪个模型负责哪项任务,以及每项任务的费用。
· 10 分钟阅读
渠道
无人出镜的旁白频道:工具、工作流与下一集
脚本、一个保存好的旁白声音、视频合成器中风格统一的空镜、在 Studio 中剪辑,以及用 NOLGIA Agent 制作下一集。实际制作了两集短片。
· 12 分钟阅读
Agent
NOLGIA Agent 指南:该说什么,以及接下来会发生什么
你可以发送给 NOLGIA Agent 的十条消息、它对每条消息的处理方式及其背后的预设,从产品照片和商品列表套装到钩子评分和调色剪辑。
· 6 分钟阅读