

透過將語音儲存於角色上,你可以在所有影片中保持一致的語音。NOLGIA 上的角色帶有 語音:一個語音模型及該模型的一個具名語音。當你在 音訊編輯器 中製作旁白時,以…的聲音說話 按鈕會選取角色,並自動套用儲存的模型與語音組合。你無需再手動選擇,因此下個月錄製的台詞與今天錄製的台詞將由同一個語音朗讀。
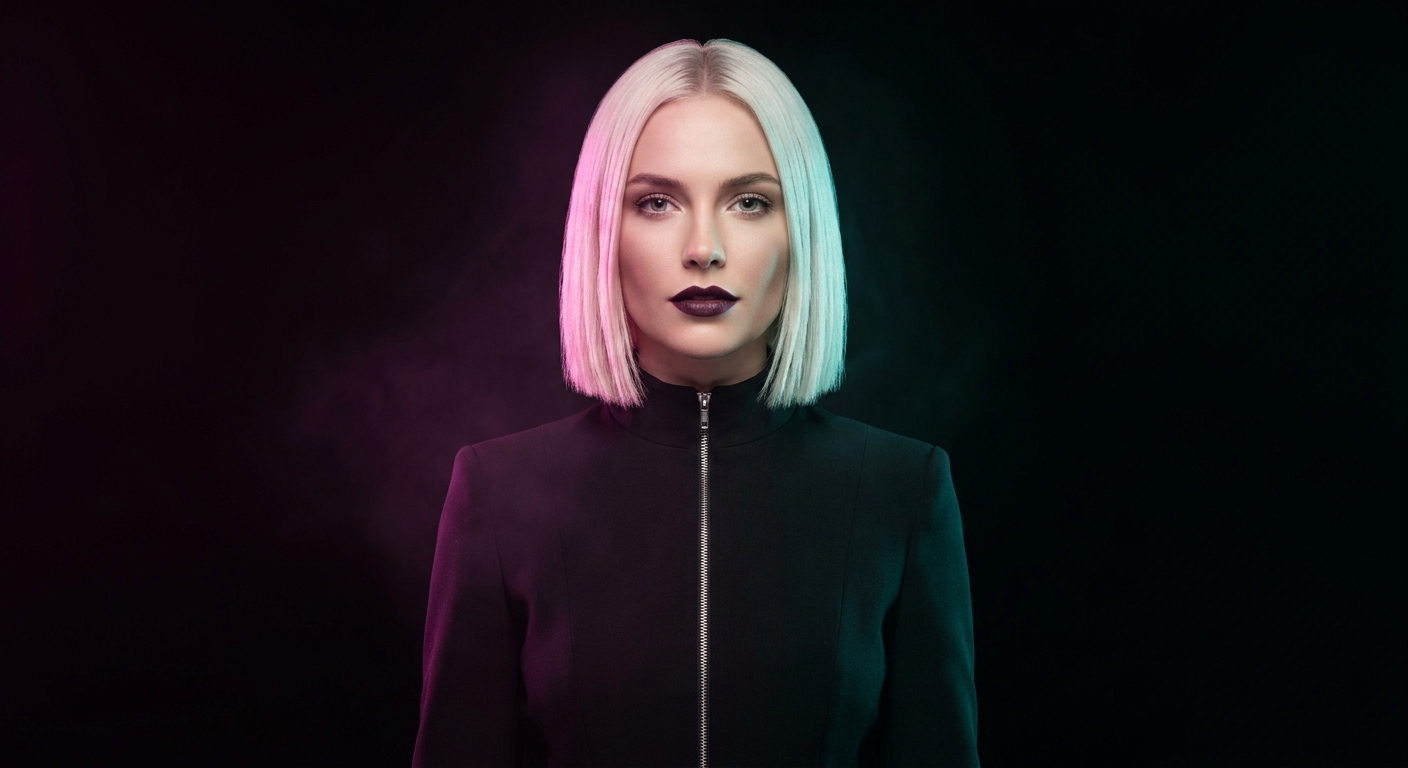
本指南將建立一位旁白員,我們為這個虛構的行銷活動語音命名為 Isla Marr,並讓她在三個不相關的片段中朗讀台詞:伸展台、夜間駕駛和屋頂派對。每個片段也在 Studio 中添加了背景音樂和一個音效提示,鋪設在語音之下。每個片段和每句台詞都是實際輸出;模型與語音在這些片段之間從未改變。
常見問題與修正方法
| 錯誤 | 造成的影響 | 修正 |
|---|---|---|
| 每次手動選擇語音 | 一次使用 v3,另一次使用 Turbo,導致相同名稱的語音聽起來不同 | 將模型與語音儲存於角色上,並使用 以…的聲音說話 |
| 選擇沒有語音清單的模型 | MiniMax Speech、Inworld、Dia 和 Orpheus 不提供具名語音,因此無法固定 | 對於重複使用的旁白員,請使用 ElevenLabs 或 Kokoro |
| 提供角色語音片段並期待旁白 | 語音片段適用於需要參考音軌的模型;文字轉語音需要目錄語音 | 為旁白設定目錄語音,僅在影片模型要求時使用語音片段 |
| 每次拍攝改變速度 | 相同語音,不同節奏,聽起來像兩個人 | 保持速度不變;改為調整腳本以配合片段 |
| 重寫台詞以聽起來更像該語音 | 語音是固定的;文字才是變數 | 為你儲存的語音撰寫,並保持句子長度穩定 |
開始之前
- 角色頁面上的一個角色。建立角色需要名稱和至少一張照片:按 加入參考圖片,上傳照片,為角色命名,然後按 建立角色。我們的是生成的人像,因此不涉及真實人物。
- 具有具名語音的語音模型。人聲對話框僅列出這些:ElevenLabs 模型和 Kokoro。
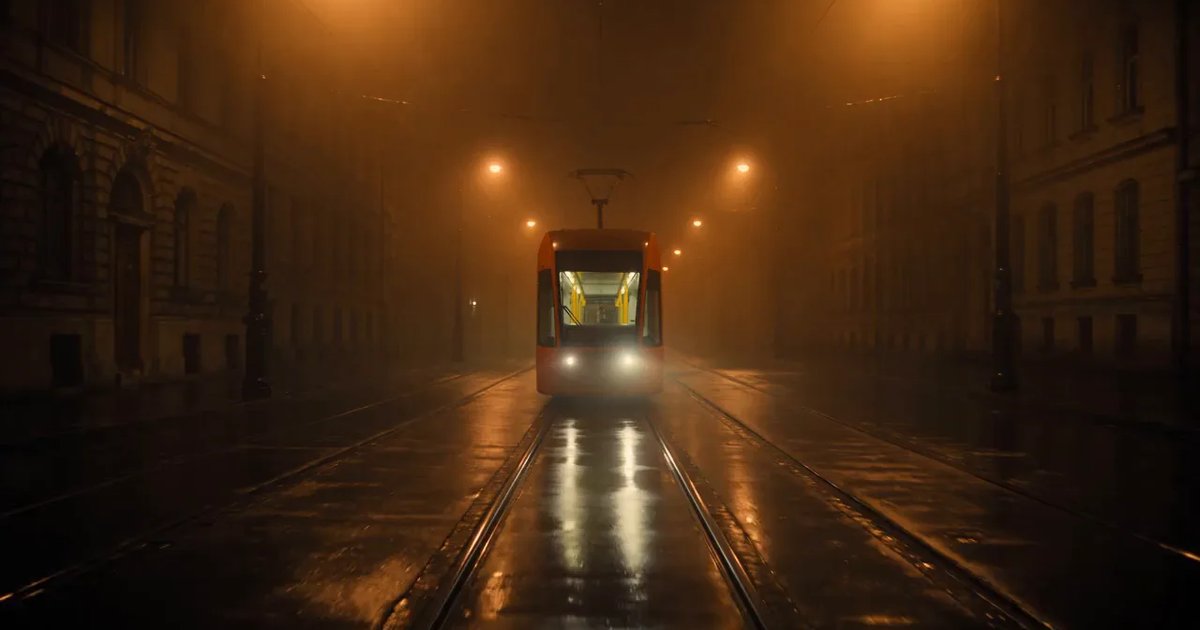
- 你想加上旁白的片段,位於你的媒體庫中。我們的是三個無聲的五秒片段:Kling v3 上的跑道和屋頂,以及 Seedance 2.5 上的夜間駕駛。
在角色上儲存語音
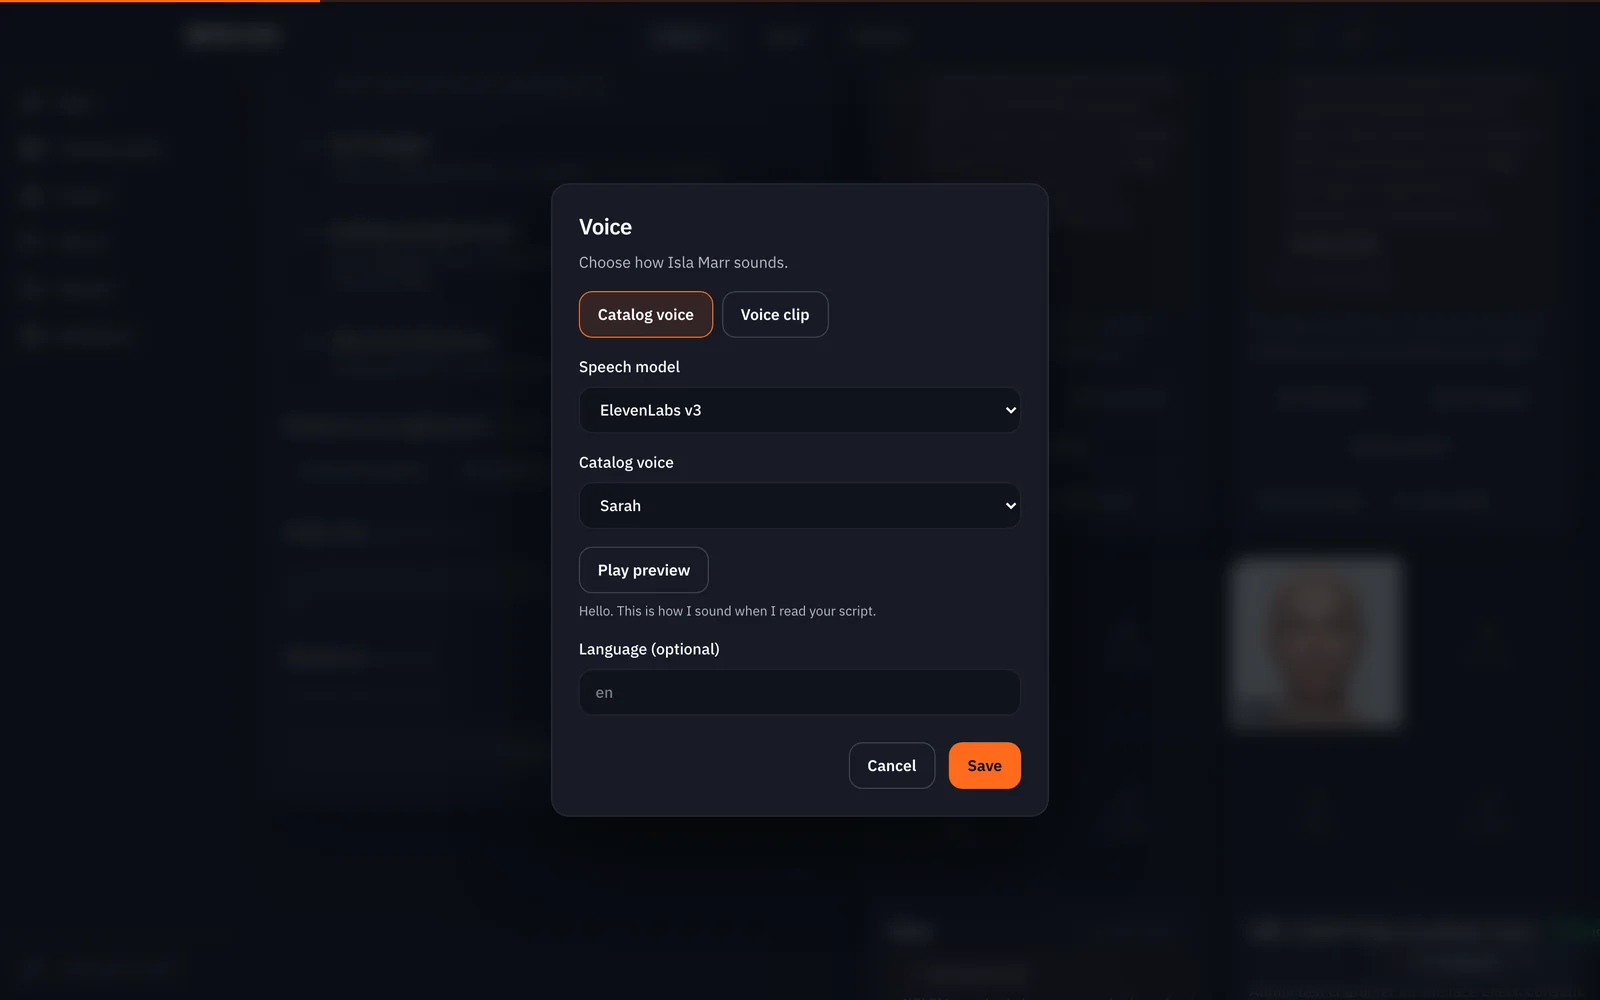
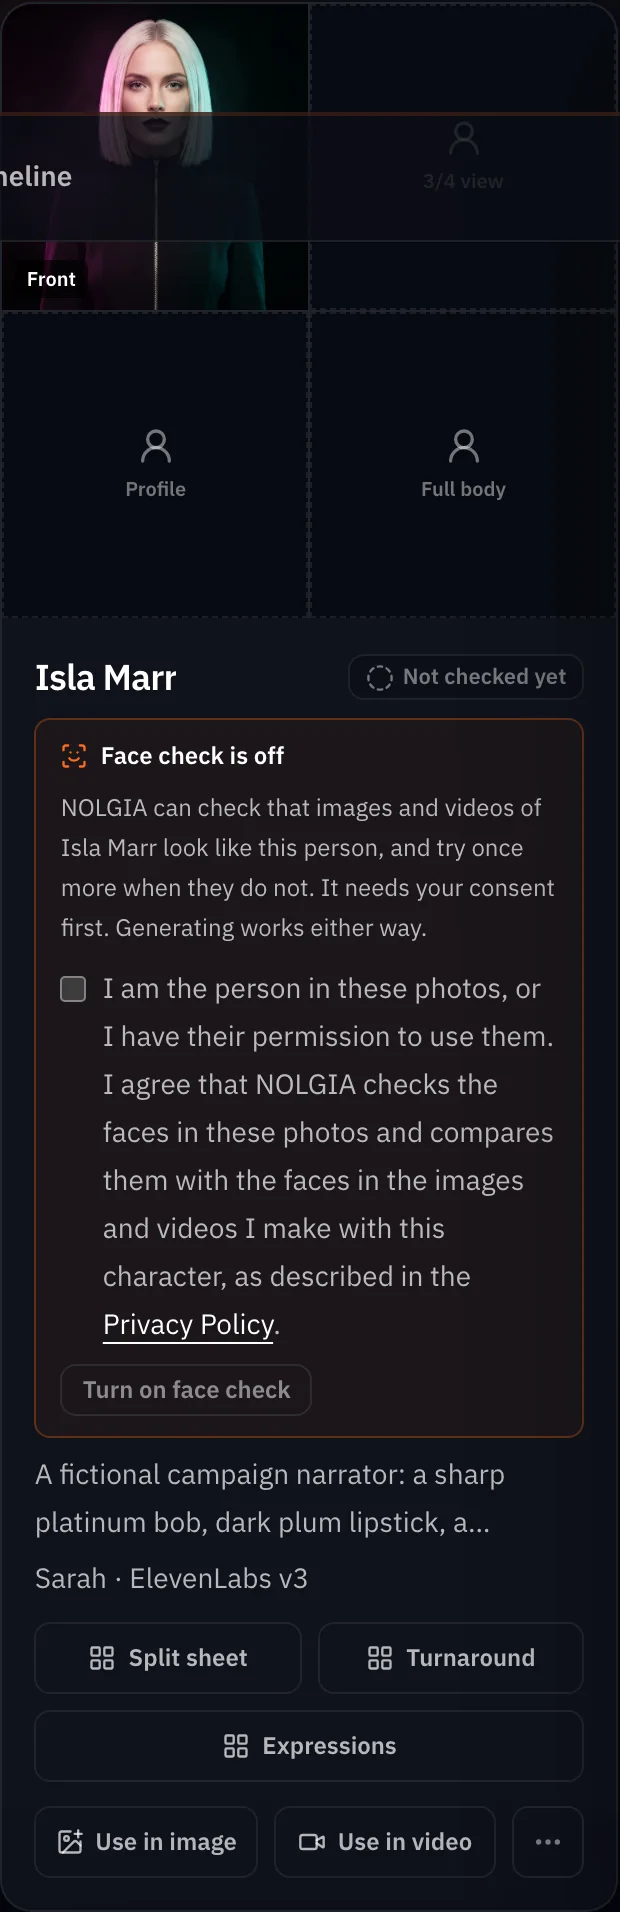
在「角色」頁面,開啟角色卡片上的 ... 選單,然後選擇 人聲。對話框提供兩種類型:目錄聲音 和 語音片段。請保持選擇「目錄聲音」。先選擇 語音模型,再選擇 目錄聲音;播放預覽 按鈕會免費播放該聲音的錄音範例。如有需要,請新增語言,然後按 儲存。卡片現在會在描述下方顯示該聲音。
使用「以…的聲音說話」進行旁白
在配音任務中開啟音訊編輯器,然後按以…的聲音說話。選擇角色。模型選擇器會切換到已儲存的模型,Voice 清單會切換到已儲存的聲音,按鈕下方的文字會確認此設定:Speaking as Isla Marr · Sarah。輸入台詞,然後按生成音訊。我們為兩份指南連續這樣做了五次,這組搭配從未改變。
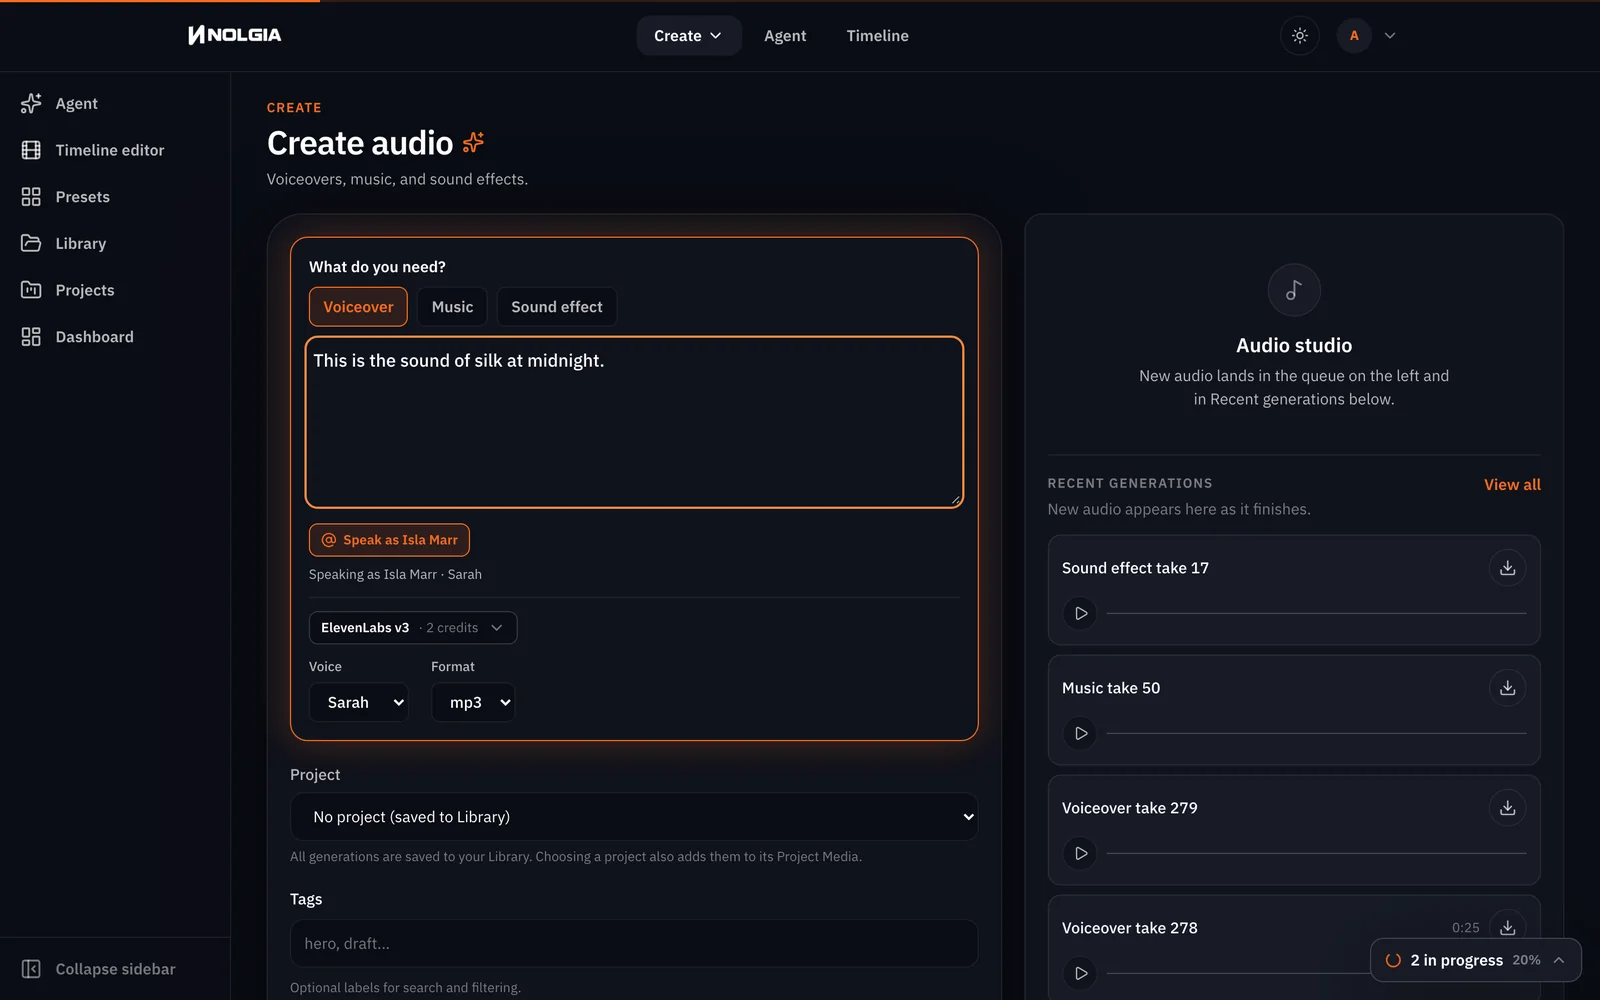
This is the sound of silk at midnight.Nothing here was built to stand still.You already know the ending. Wear it anyway.注意:如果註記顯示聲音無法使用. 以…的聲音說話會檢查已儲存的模型是否仍提供已儲存的聲音。如果某個聲音從目錄中移除,註記會請你在「角色」頁面選擇另一個聲音,而不是使用替代聲音朗讀。
在聲音下方加入背景音樂和提示音
單行對白聽起來很空。在音訊編曲器的 音樂 任務中製作背景音樂,並在 音效 中製作一個音效提示,然後在 Studio 中建立每個片段的時間軸:時間軸、新時間軸,並在左側面板的 媒體庫 分頁中,使用 + 加入片段、播放頭位置的對白、背景音樂和音效提示。
提示:Studio 會在人聲出現時降低背景音樂音量. 今天建立的時間軸在匯出時會自動混音:有人說話時音樂會降低約 12 dB,背景音樂在結尾淡出,且響度會保持均勻。若要自行設定音量,請選取一個聲音並開啟 音訊 檢查器:片段音量、淡入 和 淡出、人聲迴避,以及軌道的 軌道音量。我們的三個時間軸是在 Studio 推出這些功能之前剪輯的,因此我們改為從每個背景音樂中挑選一段安靜的樂段:向音樂模型要求強烈的動態變化,在 來源預覽 中播放軌道,在完整小節進入安靜樂段處按 標記入點,五秒後按 標記出點,並將播放頭置於 0 處按 +。這樣仍然能為對白留出空間,而不會有明顯的音量降低。
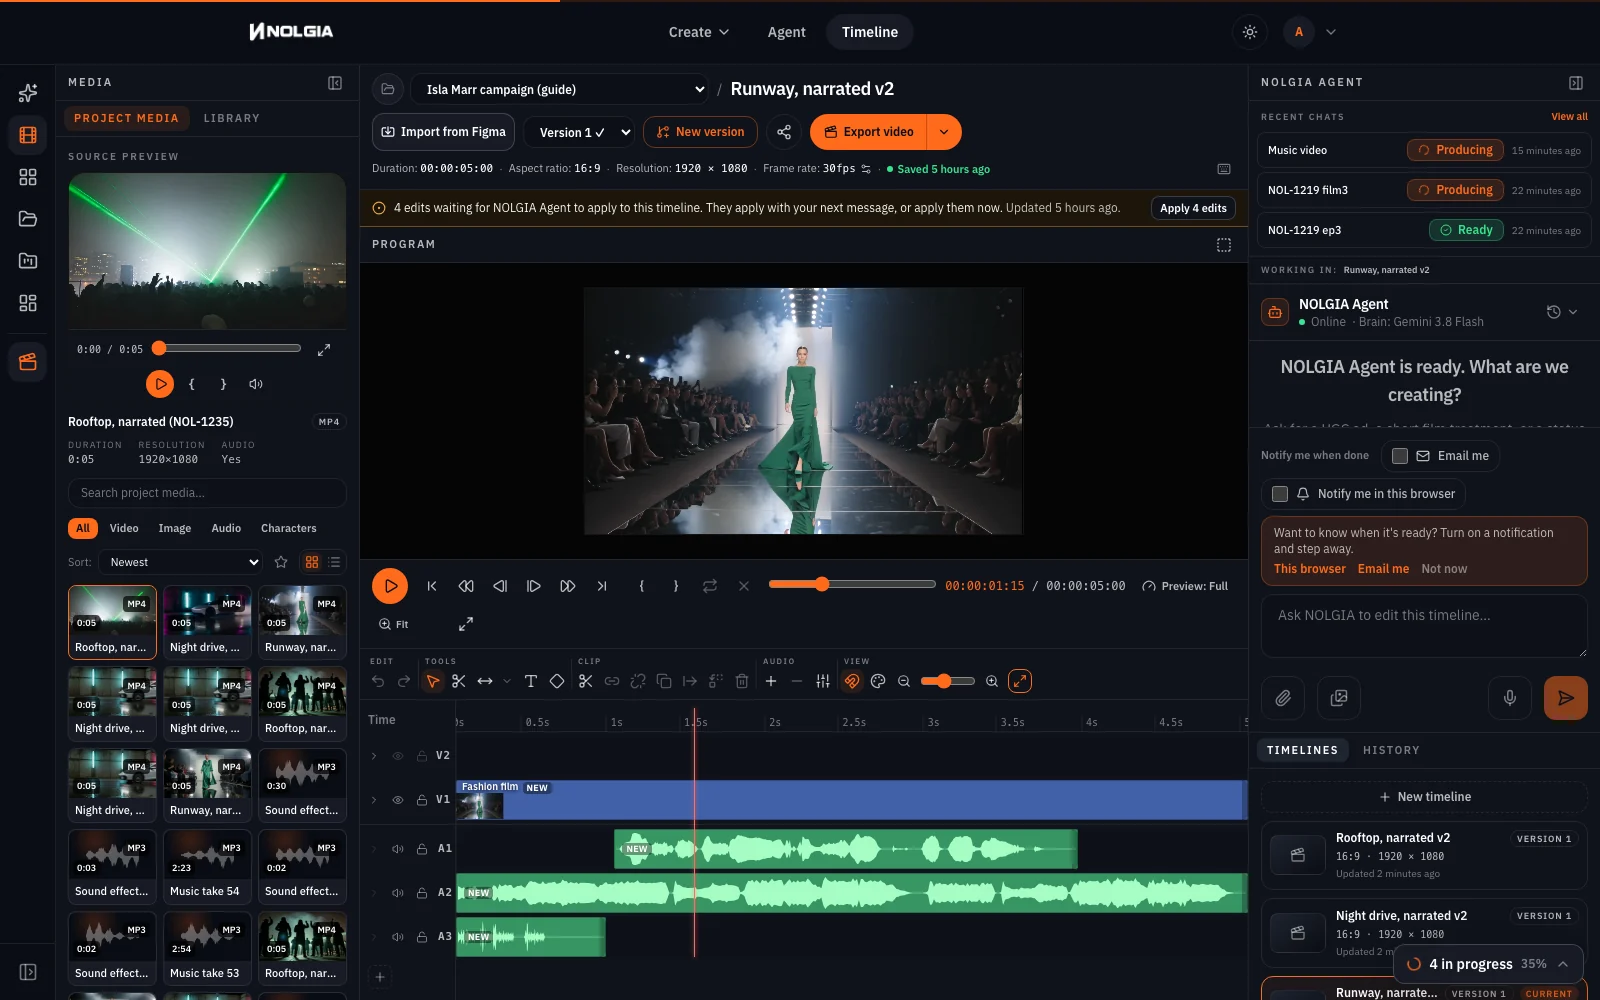
Sleek fashion-show runway track, 120 bpm, deep kick and a crisp clicking hi-hat, glossy synth stabs, instrumental, no vocals. Strong dynamics: two seconds of the full groove, then four seconds of a hushed, near-silent filtered pulse, then the full groove slams back in, and that shape repeats through the track.Dark synthwave night-drive track, 100 bpm, driving analog bass arpeggio, gated snare, cold pads, instrumental, no vocals. Strong dynamics: two seconds of the full drive, then four seconds of a sparse, hushed passage with only a low filtered bass, then the full drive returns, and that shape repeats through the track.Warehouse rave build for a rooftop party at night, 128 bpm, instrumental, no vocals: a soft muffled kick and a quiet rising filtered riser that builds for five seconds, then a huge drop with open hi-hats and a big supersaw lead, and that quiet build and big drop repeat through the track.音效提示在 ElevenLabs Sound Effects v2 上各為一行短文字,並使用 Mark Out 修剪,以免干擾人聲:伸展台開頭一秒的相機快門聲、駕駛台詞後的引擎與水花聲,以及屋頂彩帶落下時的群眾歡呼聲。按下播放:因為每次請求使用的模型與聲音都相同,所以三個片段中的人聲保持一致,且位於音樂之上。
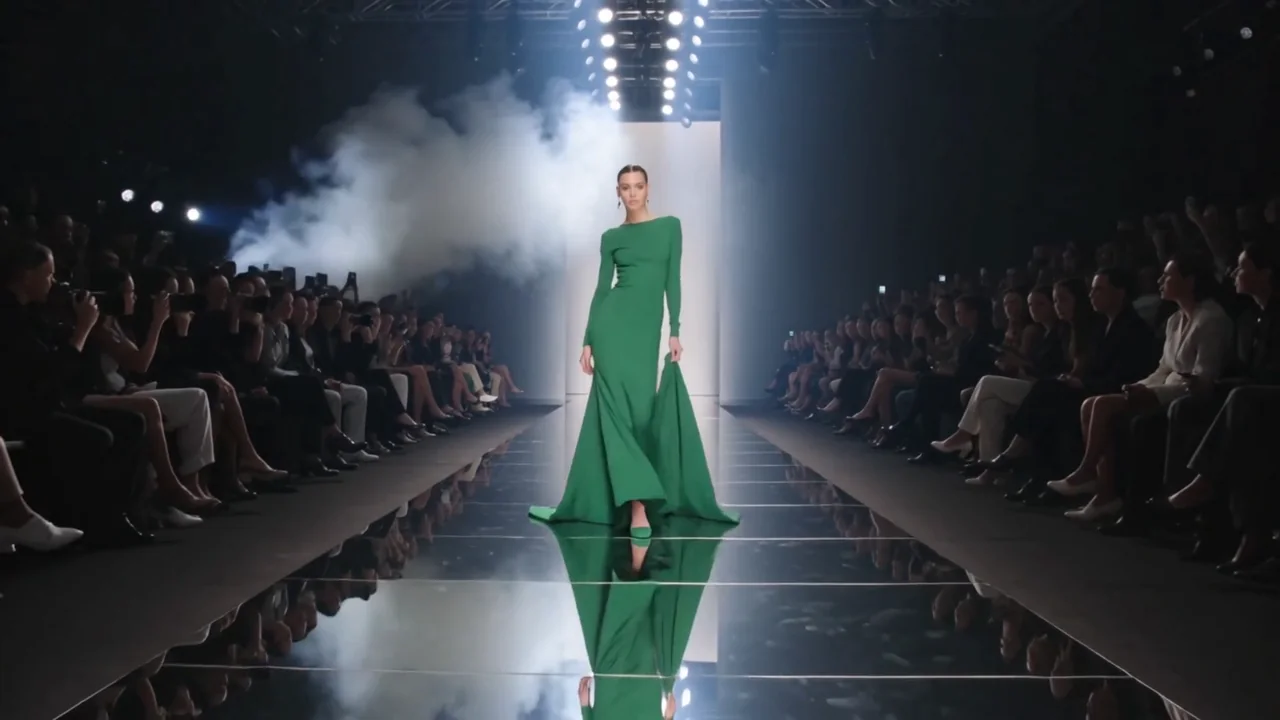
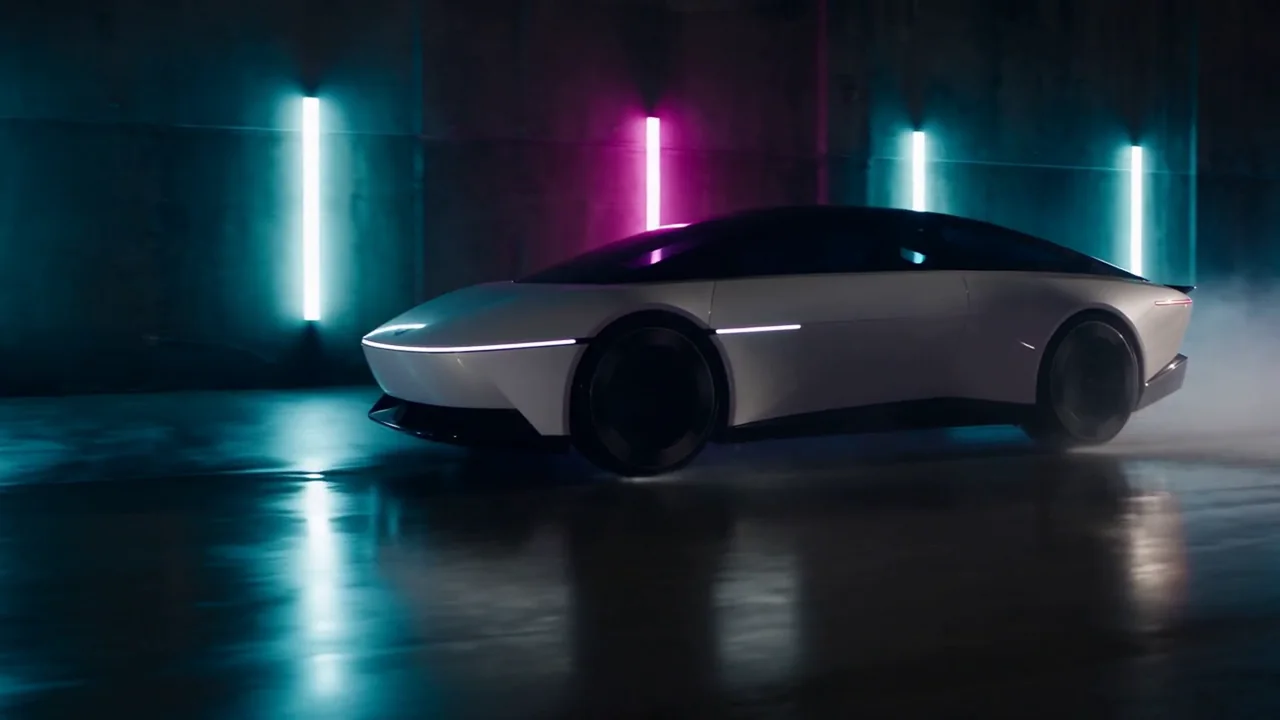
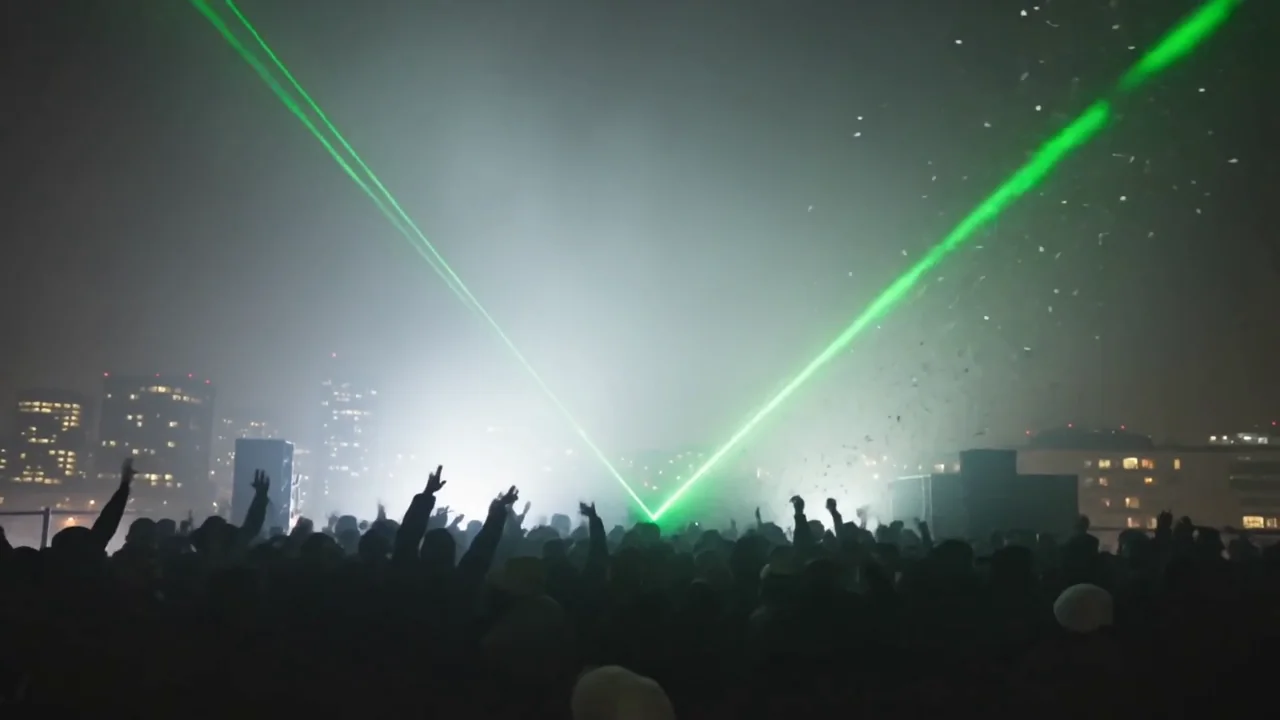
我們測量了每個輸出檔案:沒有超過半秒的靜音間隙,且她在說話時,聲音至少比其他所有聲音高出 3 dB。這些時間軸以相同音量混合了所有音軌,因此這些數據來自我們選擇的段落,而非設定值。
三種執行方式
| 路徑 | 方法 | 最佳時機 |
|---|---|---|
| 最快 | 音訊編曲器、Speak as、一次一行 | 你正在製作的剪輯中幾行台詞 |
| 免手動 | 向 NOLGIA Agent 提供角色名稱;它可以列出你的角色並使用儲存的聲音生成音訊 | 來自腳本的一系列集數 |
| 最多控制權 | API:使用角色的 id 執行 POST /generate/audio,或從你自己的程式碼呼叫 MCP 工具 nolgia_text_to_audio | 從文件或工作流程批次產生旁白 |
API 路徑的文件位於 角色與地點:音訊生成會使用角色的 id 來套用角色聲音,而在要求使用角色聲音進行影片生成時也會套用。本指南實際執行的是編曲器路徑,而非另外兩種。
仍需重新生成的情況
- 交付成果仍有些微差異。 聲音相同、模型相同,但每次生成都是新的朗讀。如果某句語氣平淡,請重新執行;聲音本身不會改變。
- 背景音樂仍可能蓋過台詞。 匯出時會自動降低音樂音量以配合人聲,但音量較大的段落仍可能干擾台詞。請在音訊檢查器中調低背景音樂的 片段音量,或將 Mark In 移動到較安靜的段落。
- 你的聲音由人工挑選。在付費方案中,於音訊編輯器的 Voice 清單中選擇 建立自訂聲音,即可使用 ElevenLabs 語音模型,從 10 秒到 5 分鐘的錄音中複製你的聲音。Characters 頁面的聲音對話框僅儲存目錄聲音和聲音片段,因此 Speak as 目前尚無法使用自訂聲音:請每次在 Voice 清單中選擇它。角色上的聲音片段僅供支援該功能的模型參考,並非文字轉語音的聲音。
- 速度僅透過 API 調整。目前編輯器沒有速度控制功能。
費用說明
儲存聲音免費;預覽聲音也免費。每一行皆按模型的每字元費率計費,並設有最低費用。每個音樂背景音軌和每個提示音皆收取固定費用。影片片段按長度計價,而 Studio 匯出的檔案不計費。
ElevenLabs v3Every plan
Per 1,000 characters
Standard 6 點
Lyria 3.5Every plan
Per generation
Standard 5 點
Stable Audio 3 MediumEvery plan
Per generation
Standard 3 點
ElevenLabs SFXEvery plan
Per generation
Standard 4 點
Kling v3Pro and up
Per 5s clip (audio on by default)
720p 35 點 · 1080p 47 點 · 4K 117 點
Seedance 2.5Pro and up
Per 5s clip
480p 26 點 · 720p 56 點 · 1080p 137 點
1080p renders at 16:9 and 9:16
頁面載入時從目錄即時讀取。 所有價格都會在生成前顯示。 查看所有費率.
親自試試看
旁白的頭像
- Isla Marr 頭像,1408x768 JPEGJPEG 相片 · 1408x768 · 483 KB下載
Fashion film, one continuous shot. A model in a sculpted emerald green floor-length gown with long sleeves walks down a mirrored runway toward the camera, camera strobes flashing from the crowd in silhouette on both sides, white haze, slow motion, low tracking shot moving backwards, anamorphic flares, deep blacks. No text, no logo.Premium car commercial, one continuous shot. An original concept coupe that resembles no production car: a low, wide, wedge-shaped matte white body with a single thin continuous light bar across the nose, no grille, no badges, a smooth flush glass canopy, enclosed rear wheel arches and a sharp ducktail rear. It slides sideways through a wet night street lined with bare concrete walls and plain vertical neon tubes in teal and magenta, no shop windows, no signs, no lettering anywhere. Rain streaks in the air, neon reflections stretched across the asphalt, low side tracking shot, spray from the tyres, motion blur on the passing lights, cinematic contrast.Music video, one continuous shot. A rooftop rave at night: a dense crowd in silhouette wearing long dark coats, hoodies and bucket hats, arms raised, under sharp green laser beams fanning through a thick haze layer, confetti bursting in slow motion, a city skyline of blurred lights behind them, low handheld camera looking up, backlit, high contrast. No text, no logo.你的片段和背景音樂可能與我們的不同;提示詞提供給模型的是場景或氛圍,而非具體的鏡頭表現,因此請為 Mark In 尋找你自己的安靜段落。語音會保持一致,因為角色會承載它。
檢查清單
- 角色已存在,並具有名稱和照片。
- 語音對話框:目錄語音,具有具名語音的模型,已播放預覽,已儲存。
- 音訊合成器:「以...說話」顯示角色,且備註名稱標示語音。
- 每行台詞生成一次;在剪輯前檢查每個鏡頭。
- 要求具有強烈動態變化的音樂背景,且每個片段對應一個提示音。
- Studio:片段,播放頭處的鏡頭,從安靜段落截取的五秒背景音樂窗口,提示音避開語音,匯出影片。
常見問題
- 哪些模型可以作為角色的語音?
- 支援具名語音的模型:ElevenLabs 語音模型提供十種語音,Kokoro 提供二十種。MiniMax Speech、Inworld、Dia 和 Orpheus 沒有語音清單,因此對話框中不會提供這些選項。
- 每次生成的語音都會完全相同嗎?
- 語音和模型是相同的。但朗讀內容每次都是重新生成的,因此不同生成結果之間的節奏和重音可能會略有差異。如果不喜歡某一行,可以重新生成;語音會保持不變。
- 我可以使用自己的聲音嗎?
- 可以,但僅限付費方案。在音訊編輯器中,選擇 ElevenLabs 語音模型,開啟「語音」清單並選擇「建立自訂語音」:錄製或上傳 10 秒到 5 分鐘的一人說話音訊,確認這是你的聲音或你已獲得說話者的許可,之後它就能朗讀任何腳本。目前角色尚無法使用自訂語音,請在「語音」清單中選擇。角色上的語音片段(3 到 30 秒)僅作為支援參考音軌的模型的參考。
- 影片模型可以使用角色的聲音嗎?
- API 在影片生成中提供了此開關。我們未在本次指南中測試此功能,因此不描述其聽感效果。
- 語言欄位是用來做什麼的?
- 與語音一同儲存的選填標籤,例如 en 或 en-US,代表角色說話的語言。如果不確定,請留空。
- Studio 可以自動降低背景音樂音量以配合語音嗎?
- 可以。在今天建立的時間軸上,當有人說話時,匯出的音樂會自動降低約 12 dB,且音樂的「Duck under voice」(語音閃避)預設為開啟。你可以在「音訊檢查器」中自行關閉此功能,或手動設定「片段音量」、「淡入」、「淡出」和「軌道音量」。
將語音綁定至角色
開啟「角色」相關指南
音訊
為你的影片製作語音、音樂與音效
在音訊編排器中製作旁白、背景音樂與音效,然後在 Studio 中將它們疊加在你的片段下方。了解哪個模型負責哪項工作,以及各自的費用。
· 閱讀時間 10 分鐘
頻道
無臉旁白頻道:工具、工作流程與下一集
腳本、一個已儲存的旁白聲音、影片合成器中鎖定風格的 B-roll、在 Studio 中剪輯,以及用於下一集的 NOLGIA Agent。實際製作兩集短片。
· 閱讀時間 12 分鐘
Agent
NOLGIA Agent 食譜指南:該說什麼,以及接下來會發生什麼事
你可以發送給 NOLGIA Agent 的十則訊息、它對每則訊息的處理方式及其背後的預設集,從產品照片和上架套組到鉤子評分和調色剪輯。
· 閱讀時間 6 分鐘