

動画のためのボイス、音楽、サウンドエフェクト
音のないクリップは、半分だけのクリップです。オーディオコンポーザーは、サウンドトラックに必要な3つの要素を一つずつ作成し、Studioで映像の下に配置します。
- 10 分で読めます
英語から自動翻訳されています。原文を読む
音声、音楽、効果音は、オーディオコンポーザーでそれぞれ別々の生成として作成し、各タスクに最適化されたモデルを使用します。その後、Studioでクリップの下に配置します。コンポーザーの「ナレーション」タスクではスクリプトを音声に変換し、「音楽」タスクでは説明からトラックを作成し、「効果音」タスクではワンショットのキューや環境音を作成します。いずれも動画は必要ありません。タイムラインに配置するまでは、ライブラリ内のオーディオアセットとして保存されます。
このガイドでは、Seedance 2.5で作成した音声をオフにした香水広告の無音クリップを、何もない状態からミックスされたサウンドトラックに仕上げる過程を追います。ここで再生できるすべてのクリップは実際の出力結果であり、価格はページの読み込み時にライブカタログから取得されます。
よくある失敗と修正方法
| ミス | 問題点 | 修正 |
|---|---|---|
| ビデオモデルにサウンドトラック全体を依頼する | ネイティブ音声対応モデルは独自の音楽や効果音を生成するため、画像を再生成せずに一部だけを変更することはできません | クリップを無音でレンダリングし、オーディオコンポーザーで各サウンドを作成してから、Studioでミックスします |
| ナレーションを含んだ長い音楽プロンプトを使用する | 音楽モデルは記述された内容を歌うため、ナレーションの行は歌詞として返ってきてしまいます | スクリプトは「ナレーション」タスクで、雰囲気は「音楽」タスクで指定してください |
| 効果音に対して完全な文を使用する | 効果モデルはシーンを解析し、ノイズの層を作成します | その音、素材、空間を短い一行で説明します |
| 名前のみのボイス選択 | 同じモデルで同じ台詞を異なるペースで読む2つの指定ボイス | 消費前に無料プレビューを再生し、テイクが長い場合はAPIの速度フィールドを使用します |
| カットに合わせてナレーションを再録音 | 再実行ごとに文字数分のクレジットが消費されます | Studioでテイクをトリミングまたはスライドし、クリップを保持または延長します |
開始前に
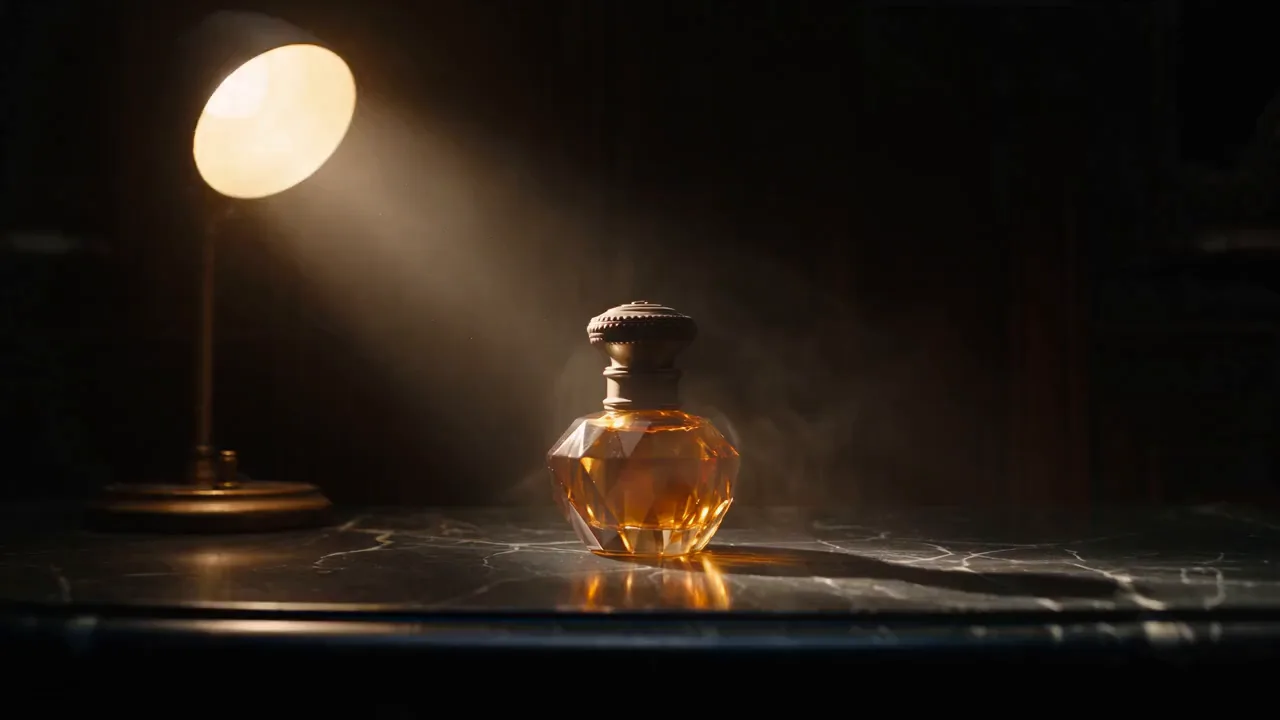
- ライブラリ内のクリップ。このガイドでは、Seedance 2.5で作成した5秒間の香水ボトルの映像を使用します。音声をオフにしているため、サウンドトラックと競合しません。
- 書き出されたスクリプト。音声は文字数課金のため、生成前にカットしてください。
- 音楽と効果音用にそれぞれ1行ずつ記述。モデルはファイルではなく説明を受け取ります。
- どのプランでも利用可能。すべての音声モデルはすべてのプランで利用でき、推奨モデルでの音声生成は2クレジットから開始できます。
ナレーションを作成する
オーディオコンポーザー を開きます。 何が必要ですか? の下で、ナレーションタスクがデフォルトで選択されており、推奨モデルとして ElevenLabs v3 と、10 種類の命名されたボイスを含む ボイス リストが表示されます。読ませたいセリフを入力し、ボイスを選択します。ここでは Roger を使用しました。ボタンには オーディオを生成 とライブ価格が表示され、入力に応じて価格が変動します。ワンクリックで生成できます。
Some nights do not ask for permission.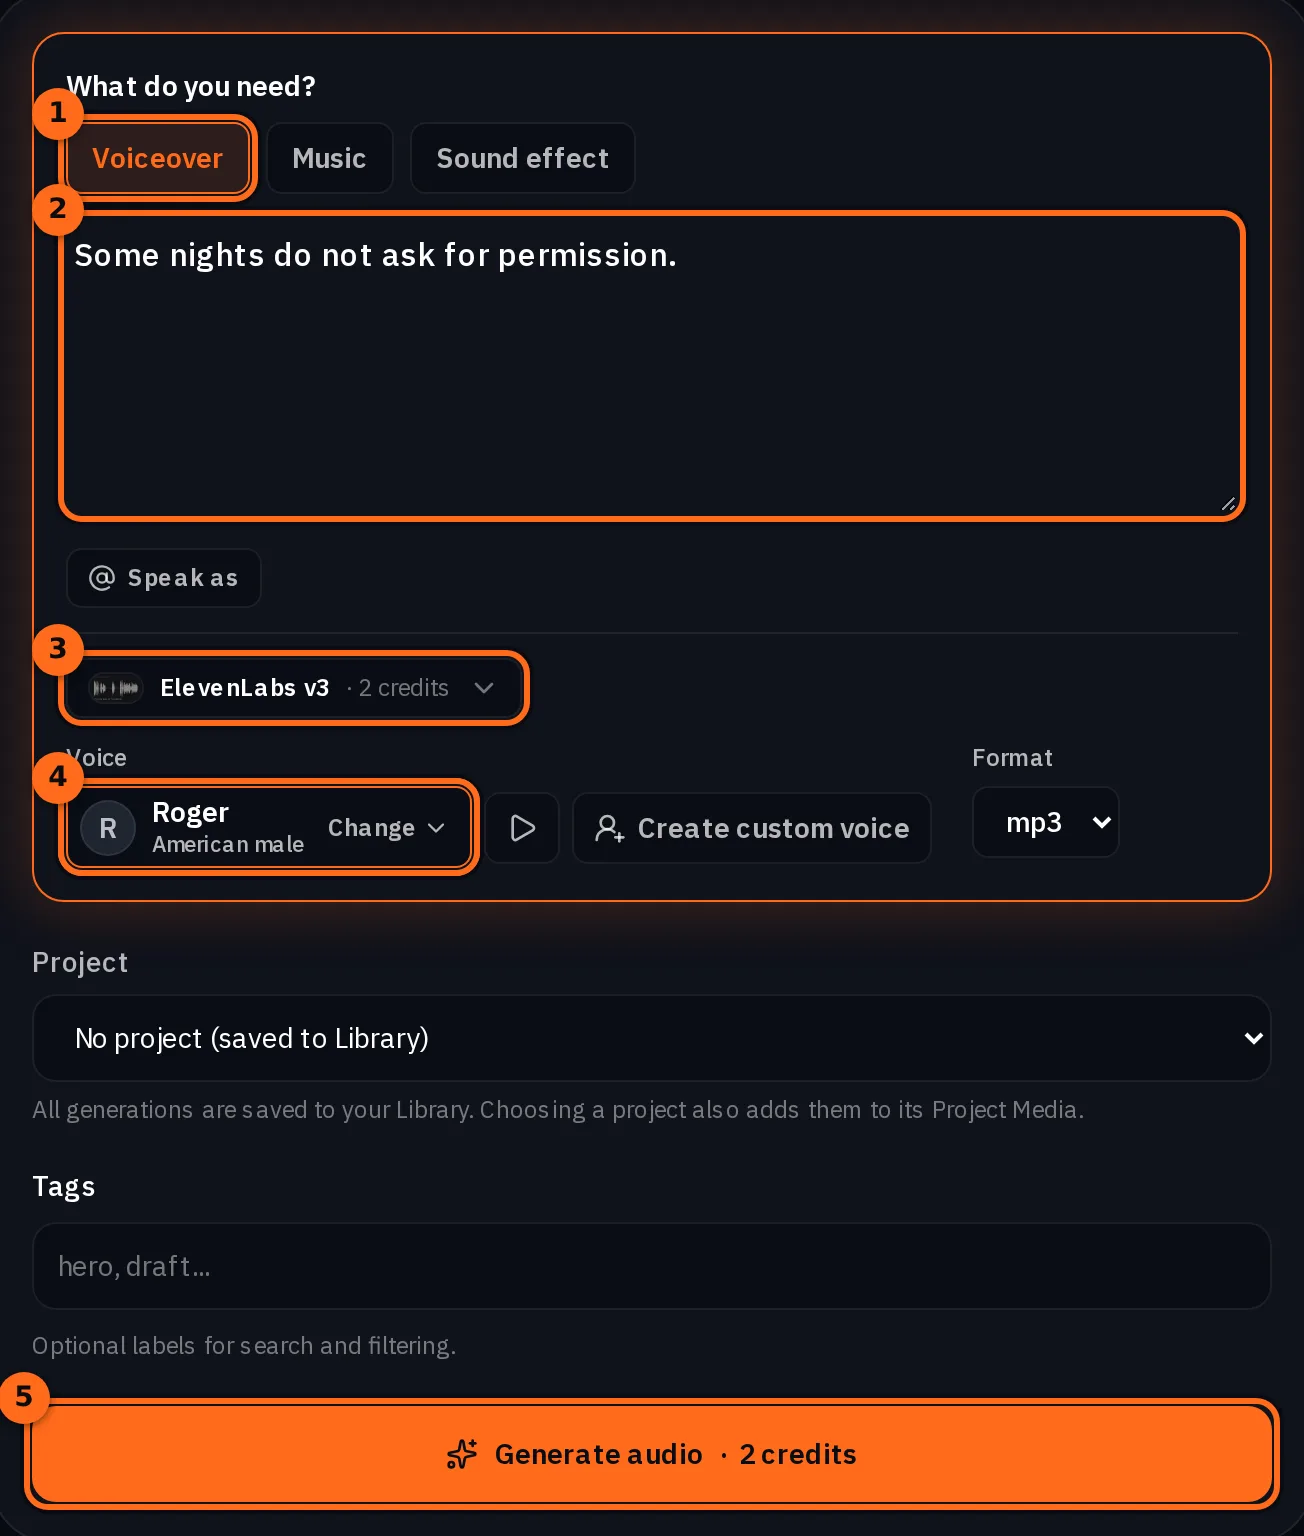
ヒント:ボイスを無料でプレビュー. ElevenLabs と Kokoro の各命名されたボイスには、短い録音サンプルがあります。テイクにクレジットを消費する前に、キャラクターページのボイスダイアログで再生してみてください。
音楽ベッドを作成する
タスクを 音楽 に切り替えます。推奨モデルは Lyria 3.5 で、価格はトラックごとに一律の料金です。入力内容に関わらず同じです。ムード、楽器、テンポ、トラックの動きを説明してください。歌が入らないようにしたい場合は、ボーカルなし と指定します。クリップより長いトラックが生成されますが、問題ありません。Studio でトリミングします。
Dark minimal electronic pulse for a fragrance commercial: a deep sub bass heartbeat, sparse glassy synth stabs, a slow rising pad, 90 bpm, cinematic and expensive, no vocals, no drums until the last two seconds.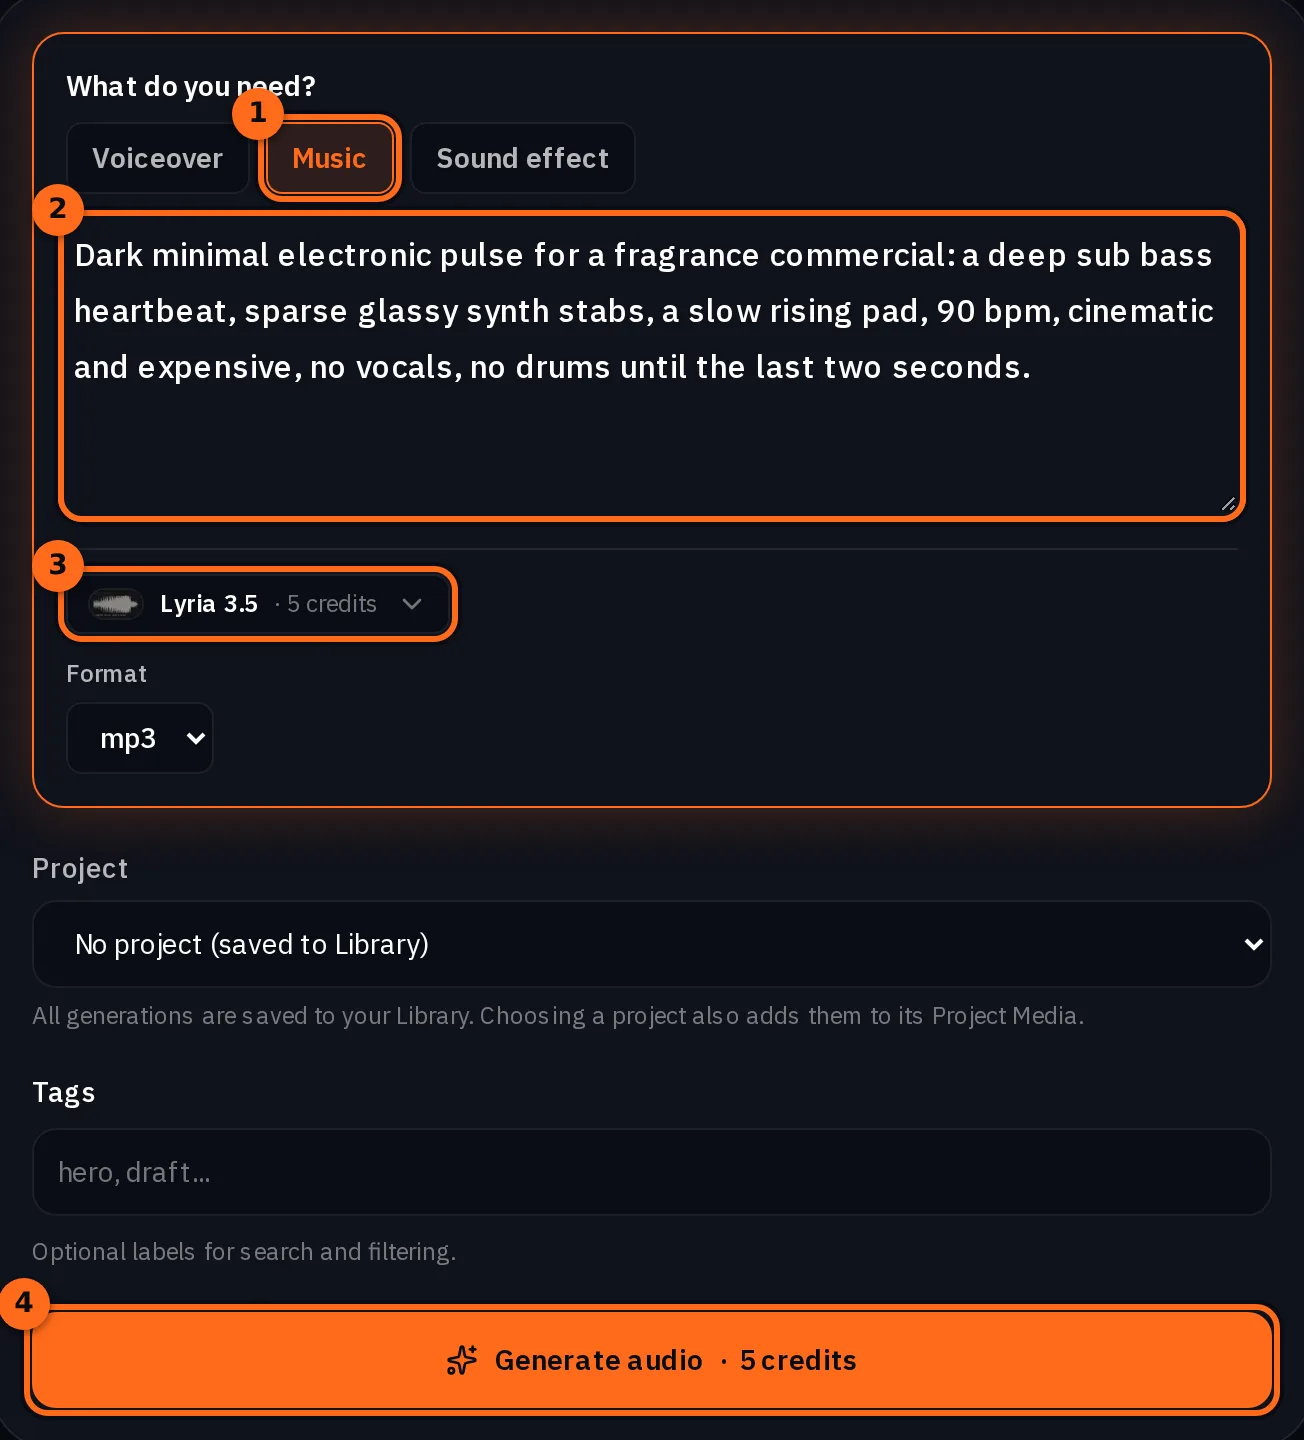
効果音を作成する
効果音 に切り替えます。推奨モデルは ElevenLabs Sound Effects v2 で、リクエストごとに一律の料金です。最大450文字の短いプロンプトを受け付けます。音、素材、そして音が響く空間を指定してください。1回の生成につき1つの音です。2つ目の効果音は2回目の実行が必要です。
A single deep glass chime with a low reverberant thud underneath, decaying slowly in a large empty hall.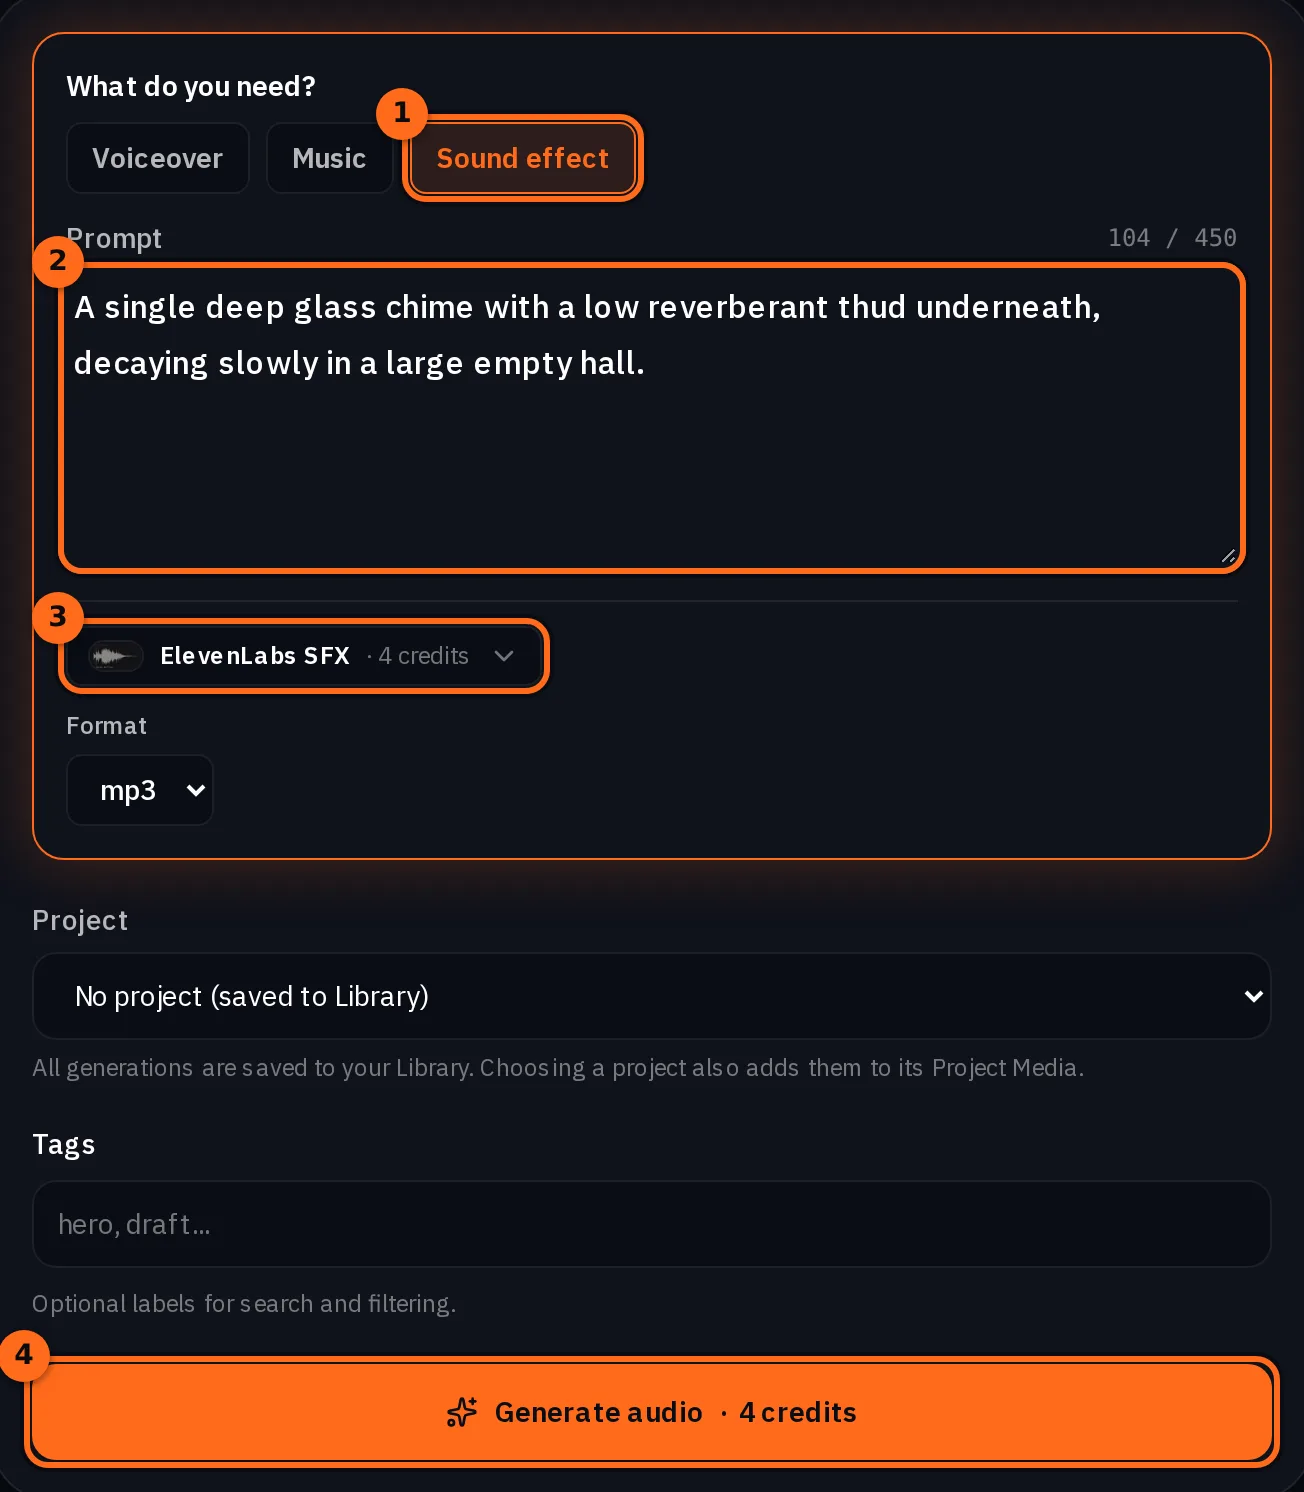
注意:MMAudio v2は、言葉だけでなく画像からも動作します. 「サウンドエフェクト」リストの2番目のモデルであるMMAudio v2は、動画からオーディオを生成するモデルです。クリップを見て、それに合うトラックを作成します。特定のキューではなく、空間や動きを自動的にスコアリングしたい場合に最適です。
Studioでクリップの下に配置する
タイムラインを開き、新しいタイムラインを押します。プロジェクトを選択するか、新しいプロジェクトを作成し、タイムラインに名前を付けて作成を押します。Studioがそのタイムラインで開きます。左パネルで、プロジェクトのメディアからライブラリに切り替えます。ここには検索ボックスとタイプフィルターを備えた、あなたの全ライブラリが表示されます。各カードには、再生ヘッドの位置に追加する+ボタンがあります。
- クリップを検索し、その+を押します。0秒の位置にある最初のビデオレーンに配置されます。
- 音楽カードをクリックして、リスト上部の ソースプレビュー に読み込みます。プレビューのスクラブバーを0にドラッグして インをマーク を押し、5秒にドラッグして アウトをマーク を押してから、+ を押します。背景音乐(ベッド)がオーディオレーンに配置され、クリップの長さに合わせてトリミングされます。2分間のトラックの残りの部分はタイムラインには表示されません。
- タイムラインのスクラブバーを1.6秒にドラッグし、ナレーションの + を押します。再生ヘッドの位置で、独自のオーディオレーンに配置されます。
- 3.9秒にドラッグし、チャイムの + を押します。
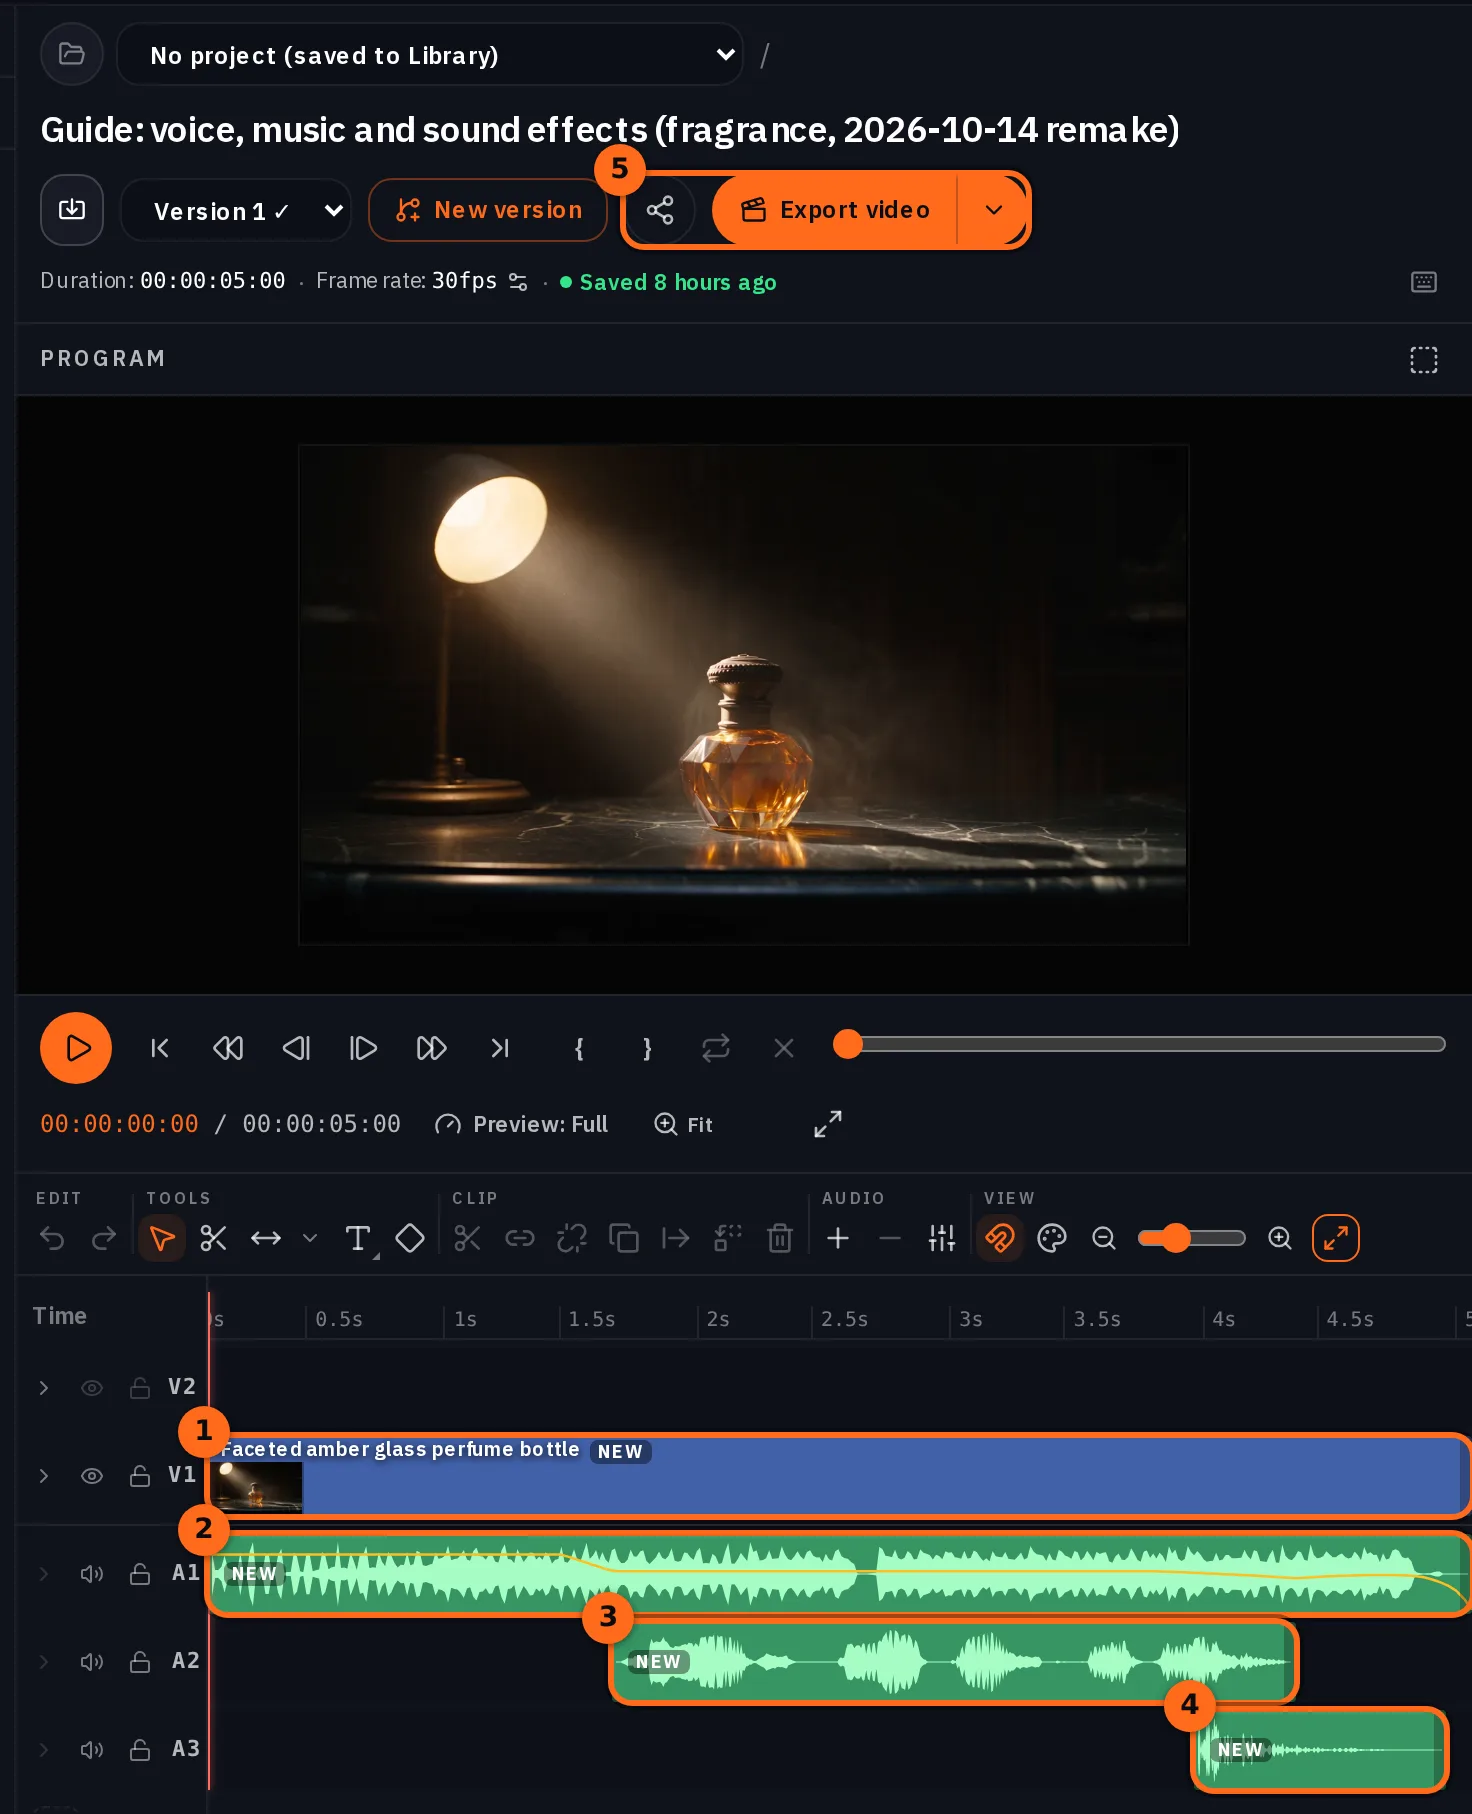
上部にある動画を書き出しを押します。MP4はサーバー上でレンダリングされ、ライブラリにレンダリングとしてタグ付けされて保存され、プロジェクトの最近のエクスポートリストに表示されます。エクスポートには課金されません。
ヒント:編集行はエクスポートをブロックしません. 項目を追加した後、Studioは編集がNOLGIA Agentによって適用されるのを待っていることを示す行を表示します。これは、それらをタイムラインのオーサリングドキュメントに書き込むことに関するものです。エクスポートにはすでに含まれています:当社のレンダリングでは3つのサウンドすべてが反映されていました。
無音のクリップ
サウンドトラック付き
どのタスクにどのモデルを使うか
| 必要なもの | タスク | まずこれを使う | リスト内の他の選択肢 |
|---|---|---|---|
| ナレーターまたはセリフ | ナレーション | ElevenLabs v3、10種類の指定音声 | 半分のレートでのv3 Conversational、Multilingual v2、Turbo v2.5、20種類の音声のKokoro、MiniMax Speech、Inworld、Dia、Orpheus |
| 歌詞のない音楽のベース | 音楽 | Lyria 3.5 | MiniMax Music 2.6、ElevenLabs Music、Stable Audio 3 Medium および 2.5 |
| 1つのキュー: ヒット、ウィッシュ、ドア | サウンドエフェクト | ElevenLabs Sound Effects v2 | トラックがクリップに追従すべき場合は MMAudio v2 |
| 映像に追従するサウンド | サウンドエフェクト | MMAudio v2 | または、コントロールを犠牲にしてネイティブオーディオ対応のビデオモデル |
再生成が必要な場合
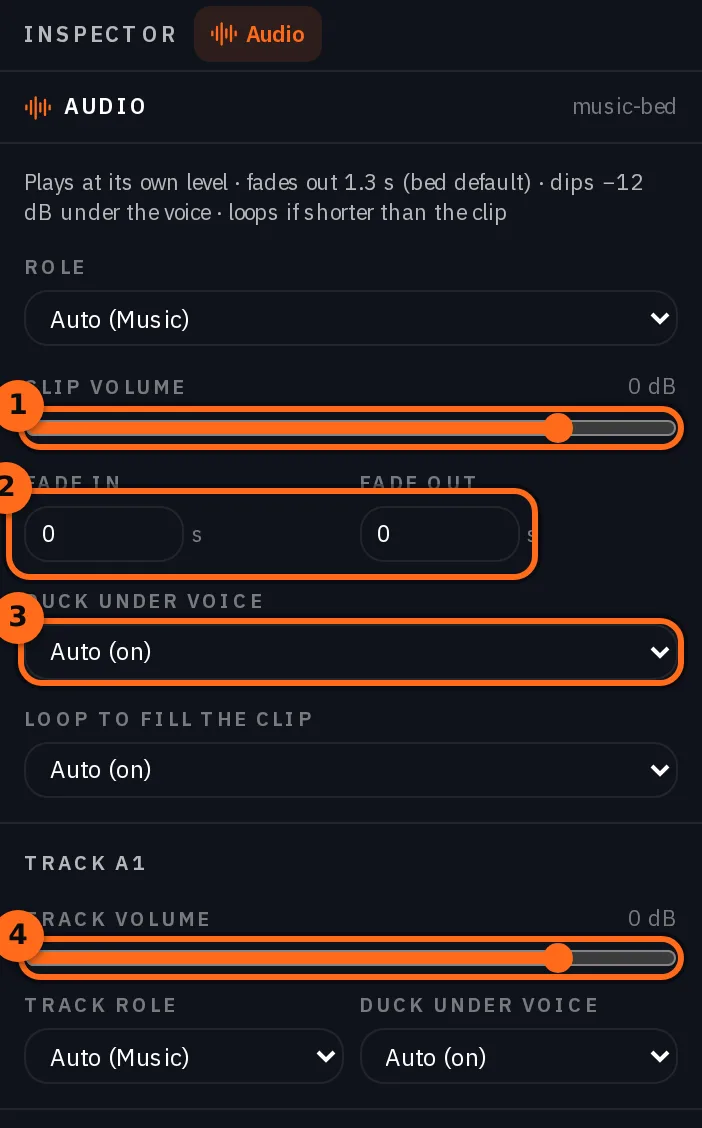
- レベル。 エクスポートでは基本的なミックスが自動で行われます。ボイスの下で音楽をダッキングし、最後にベースをフェードアウトし、ラウドネスを均一にします。私たちの場合は -14.2 LUFS になりました。変更するには、サウンドを選択して オーディオ インスペクターを開き、クリップの音量、フェードイン、フェードアウト、ボイスの下でダッキング、およびレーンの トラックの音量 を調整します。
- 残したいボイス。 名前付きボイスは ElevenLabs と Kokoro のみに存在します。MiniMax Speech、Inworld、Dia、Orpheus はここでボイスリストを公開していないため、それらで再実行すると同じサウンドにならない場合があります。すべてのビデオで同じボイスを使用する で、固定する方法を確認できます。
- 速度。 速度設定(ElevenLabsボイスでは0.7から1.2)はAPIフィールドです。コンポーザーにスライダーはまだないため、長すぎるテイクは書き直されるかトリミングされます。
- 正確なタイミング。 音楽はクリップより長く戻ってきます。5秒の映像に対して2分になることもありますし、ビートはモデルが配置した場所にきます。クリップに合わせてイン点とアウト点をマークするのではなく、その逆です。
- 1回の実行につき1つの効果音。 3つの音がプロンプトに含まれている場合、1つのブレンドとして返されます。
コスト
音声は文字数課金で、短い行には最低料金があります。音楽と効果音は1リクエストにつき1課金です。クリップは長さに応じて課金されます。このガイドで使用されるモデルの最新料金は以下の通りです。
ElevenLabs v3Every plan
Per 1,000 characters
Standard 6 クレジット
Lyria 3.5Every plan
Per generation
Standard 5 クレジット
ElevenLabs SFXEvery plan
Per generation
Standard 4 クレジット
Seedance 2.5Pro and up
Per 5s clip
480p 26 クレジット · 720p 56 クレジット · 1080p 137 クレジット
1080p renders at 16:9 and 9:16
このページを開いたときにカタログから最新の値を読み込みます。 料金はすべて生成前に表示されます。 すべての料金を見る.
Studioでのエクスポートは課金対象外です。新規アカウントは350の無料クレジットから始まります。
試してみる
ソースクリップと3つのプロンプト
- 香水のクリップ、無音、5秒、1280x720MP4 動画 · 1280x720 · 624 KBダウンロード
- スクリプトをElevenLabs v3のボイスオーバーに入力し、任意の指定ボイスを使用します。ここではRogerを使用しました。
- 音楽プロンプトをLyria 3.5の音楽に入力します。クリップより長いトラックになることを想定してください。
- 効果音プロンプトをElevenLabs Sound Effects v2の効果音に入力します。
- タイムライン、新規タイムライン、次にStudioで左パネルをライブラリに切り替えます。クリップを「+」で追加し、ソースプレビューで「マークイン」と「マークアウト」を使って音楽を追加し、再生ヘッドにナレーションとチャイムを追加します。ビデオを書き出します。
よくある質問
- 音声、音楽、効果音を1つの場所で生成できますか?
- はい。オーディオコンポーザーには、ボイスオーバー、音楽、効果音の各タスクがあり、それぞれ独自のモデルを使用します。すべての結果はライブラリ内のオーディオアセットとして保存されます。
- オーディオの料金はどのように計算されますか?
- 音声はスクリプトの文字数に基づいて課金され、最低料金があります。入力中にボタンに価格が表示されます。音楽と効果音はリクエストごとに一律の料金で、生成前にボタンに表示されます。
- ナレーションは映像に自動的に同期しますか?
- いいえ。手動で配置します。Studioでは、各オーディオアセットがオーディオレーン上の個別のアイテムとして扱われるため、テイクを希望するフレームにスライドさせ、クリップに合わせて音楽をトリミングします。
- ビデオモデルにサウンドを生成させるだけにしたほうがよいですか?
- 一部のモデルは可能で、迅速です。ただし、映像を再生成せずに特定のサウンドのみを変更することはできなくなります。ミックスを制御したい場合は、無音でレンダリングしてください。
- Studioからの書き出しはクレジットを消費しますか?
- いいえ。MP4レンダリングは課金対象外です。課金されるのは、クリップとサウンドを作成した生成のみです。
- 1つのプロンプトで2つの効果音を作成できますか?
- 1つのブレンドが返されます。各キューを個別に生成し、別々に配置してください。
クリップにサウンドトラックを付ける
オーディオコンポーザーを開く関連ガイド
オーディオ
すべての動画で同じ声を使う
キャラクターにカタログボイスを保存し、「Speak as」ですべての台詞を読み上げ、Studioで音楽ベッドとサウンドキューを配置します。1人のナレーターで3つのクリップを作成し、本物のような仕上がりを実現します。
· 11 分で読めます
チャンネル
顔出しなしのナレーションチャンネル:ツール、ワークフロー、次のエピソード
脚本、保存されたナレーターの声、ビデオコンポーザーによる統一されたルックのBロール、Studioでのカット編集、そして次のエピソード用のNOLGIA Agent。実際に制作した2つの短いエピソード。
· 12 分で読めます
クレジット
クレジットの仕組みと、レンダリング失敗時の対応について
料金は「Generate」ボタンに表示され、ジョブは処理中その金額を確保します。この確保分は、請求になるか返金になります。失敗、拒否、またはキャンセル後にクレジットが返還されるタイミングについて説明します。
· 6 分で読めます