

اجعل فيديو الذكاء الاصطناعي يبدو حقيقياً: الإضاءة والحركة والكاميرا
يبدو المقطع مزيفاً لثلاثة أسباب: إضاءة بلا مصدر، وجسد بلا وزن، وكاميرا لا يحملها أحد. الحل لكل منها هو جملة، وليس إعداداً. قمنا بعرض كل حل قبل وبعد على Kling v3، وكذلك الأمر النصي الكامل على Seedance 2.5، حتى ترى أي تعليمات وصلت.
- قراءة في 9 د
تُرجم تلقائيًا من الإنجليزية. اقرأ الأصل
لجعل الفيديو بالذكاء الاصطناعي يبدو حقيقياً، أصلح ثلاثة أشياء في الأمر النصي: مصدر الضوء، وكيفية انتقال الوزن عبر الجسم، وكيفية تصرف الكاميرا إذا كان شخص ما يحملها. "واقعي" و"سينمائي" ليستا تعليمات؛ المصباح، وخطوة القدم، والكاميرا المثبتة على الكتف هي كذلك.
يبدأ كل زوج من أمر نصي متوسط واحد يحتوي على الأسطر الثلاثة الضعيفة، ثم يستبدل سطراً واحداً بالضبط بنسخته القوية. نفس النموذج، ونفس المدة؛ لا يقبل Kling v3 بذرة عشوائية (seed)، لذا كل تشغيل هو محاولة جديدة. أجرينا الأزواج على Kling v3 بدقة 720p ولمدة 5 ثوانٍ، والأمر النصي النهائي على Kling v3 وعلى Seedance 2.5 بدقة 480p.
ما الذي يجعل المقطع يبدو مزيفاً
| العلامة | سبب الحدوث | الحل |
|---|---|---|
| إضاءة موحدة من كل الاتجاهات | لم يتم تحديد مصدر | مصدر رئيسي واحد له اتجاه ولون، ثم إضاءة حافة أو إضاءة تعبئة |
| المشي يبدو طافياً، والقدمان تنزلقان | "يمشي نحو الكاميرا" لا يحتوي على وزن | مكان هبوط الكعب، وكيفية حمل الوركين لكل خطوة، وما تفعله الملابس |
| الإطار ملتصق بمسار ثابت، أو ينحرف بعيداً | "تتبعه الكاميرا" يحدد النتيجة، وليس المشغل | يدوي أو على الكتف، يمشي للخلف بنفس سرعته، مع تمايل واهتزاز دقيق |
| جلد بلاستيكي، حاد من الأمام إلى الخلف | "8k، واقعي مفرط" يطلب لمعاناً زائداً | حبيبات، هالة، ملمس بشرة، وشيء في الإطار يبدو ناعمًا |
قبل أن تبدأ
- أداء واحد ومصدر ضوء واحد يمكنك تسميته: مصباح شارع، نافذة، مصباح عمل على حامل.
- اكتب الأمر النصي المتوسط أولاً: الموضوع، المكان، والسطور الثلاثة الضعيفة. ثم استبدل سطرًا واحدًا في كل مرة.
- حافظ على نفس الطول والحجم في كل تشغيل. توقع أن يتحرك باقي الإطار بين التشغيلات.
- قيّم كل زوج بناءً على الشيء الوحيد الذي قمت بتغييره.
Fashion film, one continuous take, real-time, night. SUBJECT: a man of 24, tall, dark wavy shoulder-length hair, olive skin, a long camel wool coat buttoned closed, a black turtleneck, wide charcoal trousers, chunky black boots, a thin silver chain. LOCATION: a narrow rain-wet alley, black asphalt with puddles, brick walls, light drizzle. LIGHTING: moody cinematic lighting. ACTION: he walks toward the camera. CAMERA: the camera follows him. LOOK: 35mm film grain, halation on the lamp, wet reflections, deep shadow with detail. No text, no logos, no readable signage.الإضاءة: سمِّ المصدر، والاتجاه، واللون
الإضاءة هي أسرع مؤشر. سمِّ مصدرًا رئيسيًا واحدًا، وحدد مكانه ولونه، وأعطِ الجانب المظلل إضاءة تعويضية، وحدد ما يوجد في الهواء.
LIGHTING: moody cinematic lighting.LIGHTING: one orange sodium street lamp high behind him as a backlight, rimming his hair and shoulders and glittering in the puddles; a soft cool white glow from an open shop doorway camera-right as the only fill on his face.سطر ضعيف
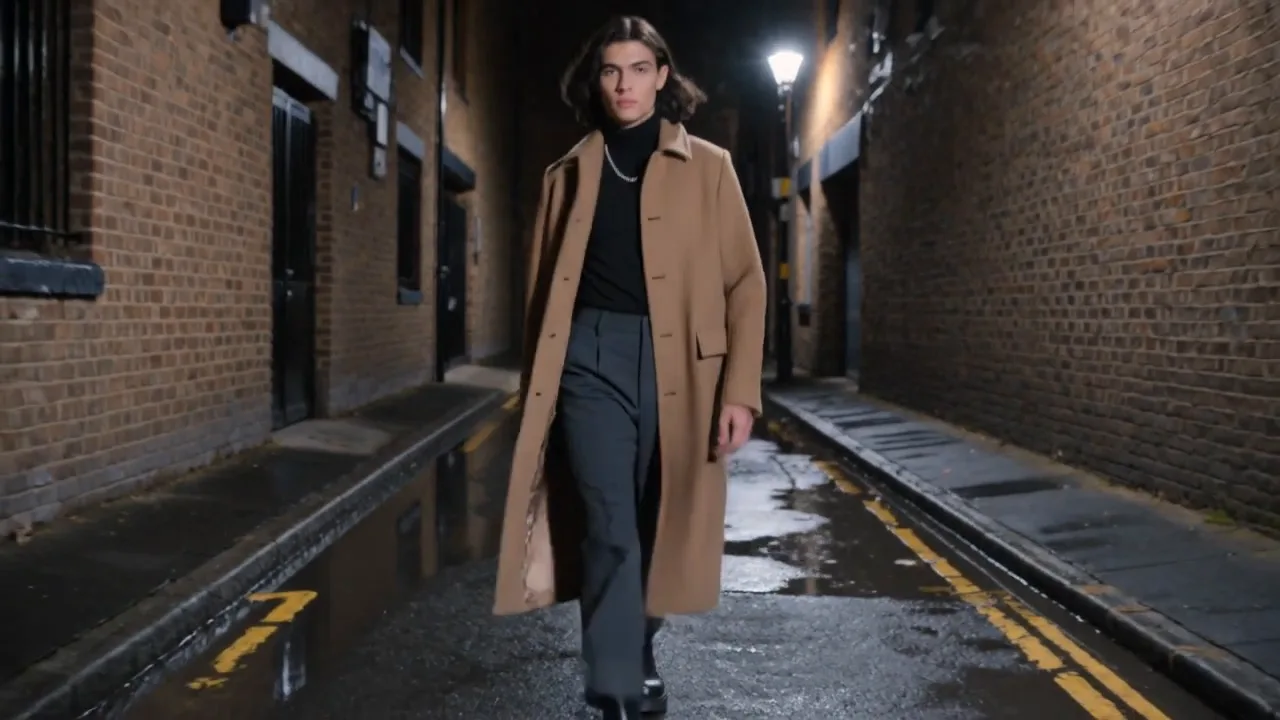
المصدر مسمى
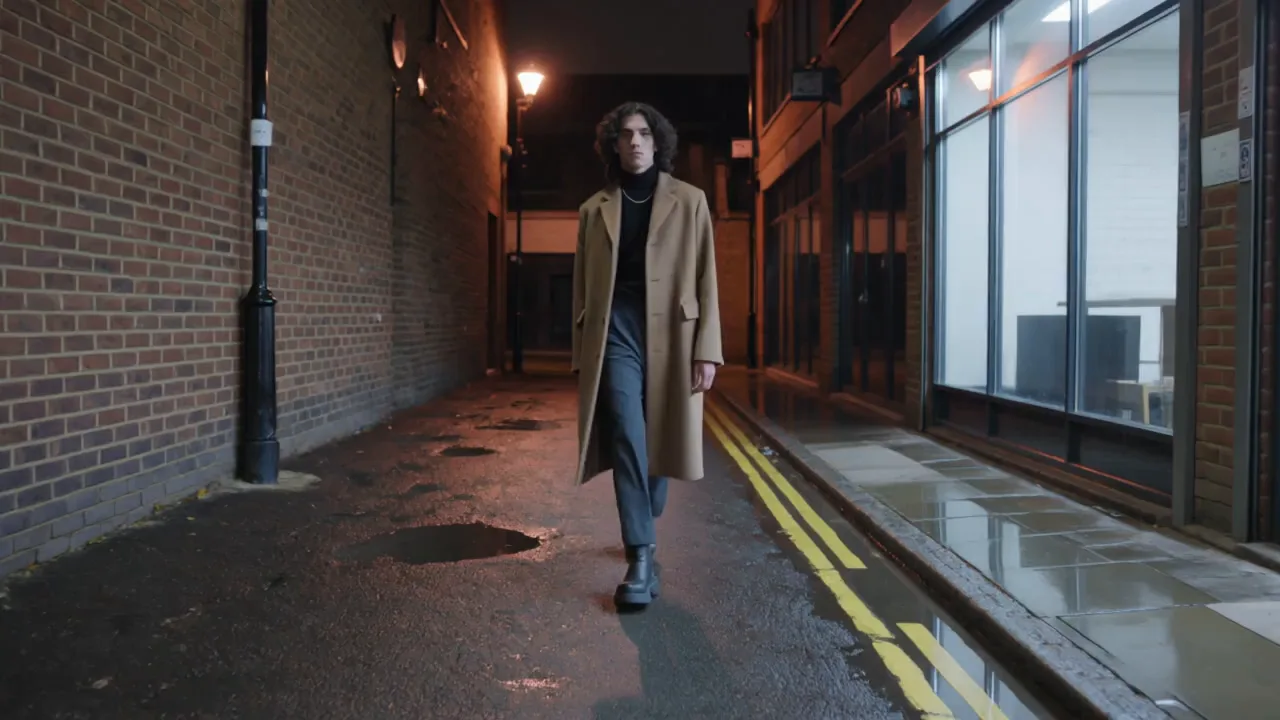
الحركة: امنح الجسم وزنًا
المشي بلا وزن هو العلامة الثانية: تنزلق القدمان، ويتدلى المعطف بلا حركة. اذكر ما يفعله كل خطوة، وما تفعله الملابس، وما تلمسه الأيدي. لمعرفة المزيد عن الوزن والتلامس والتوقيت في الرقص والعروض، راجع جعل شخصيات الذكاء الاصطناعي تتحرك بشكل واقعي.
ACTION: he walks toward the camera.ACTION: he walks straight toward the camera at an unhurried pace, each step landing heel first with a visible weight shift, the coat swinging with each stride; halfway through he lifts his right hand and turns up his coat collar, four fingers on the outside of the collar and the thumb inside, then lets the hand drop.سطر ضعيف
تحديد الوزن
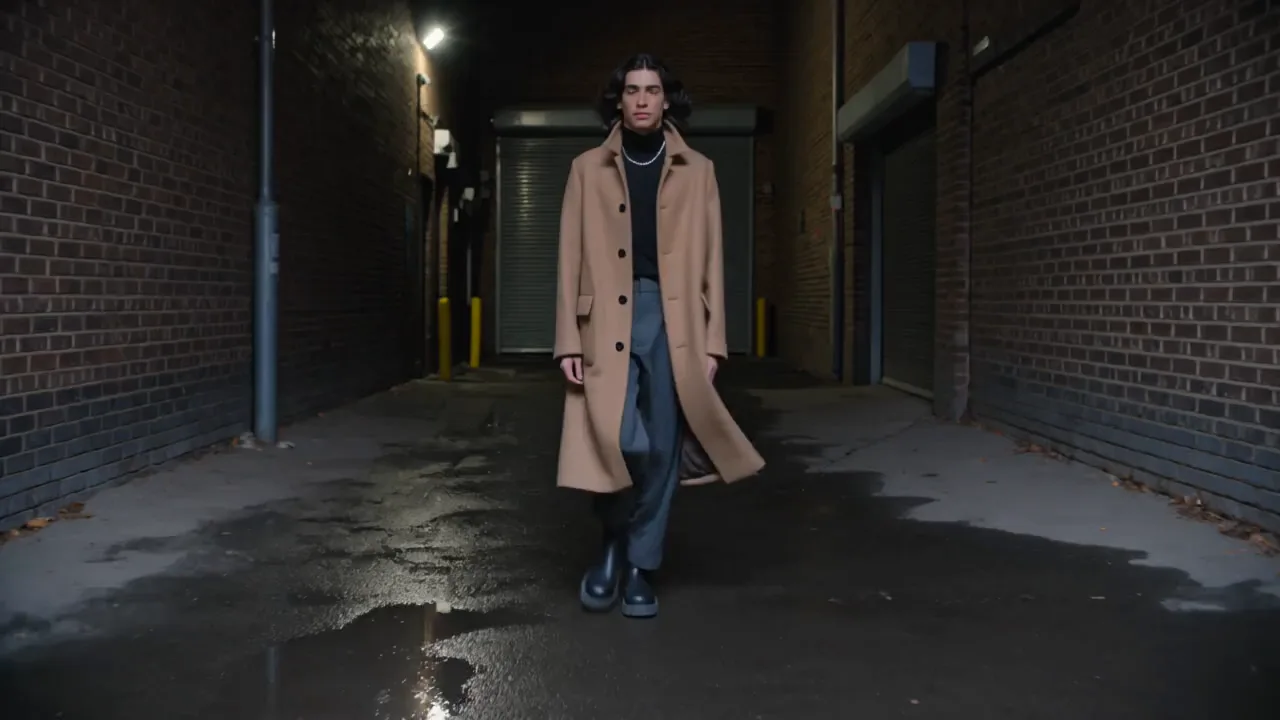
الكاميرا: امنحها شخصية
الإطار السلس تمامًا هو علامة فارقة بحد ذاته، والكاميرا التي لا يوجد لها مشغّل تتجول عشوائيًا. حدد من يمسك الكاميرا، وكيف يتحرك، وأين يقع التركيز. أو اختر يدوي من صف حركة الكاميرا في المحرر وحدد القوة؛ تُضاف الحركة إلى الأمر النصي الخاص بك كجملة مستقلة.
CAMERA: the camera follows him.CAMERA: handheld, walking backward at his pace, chest-up framing, natural sway and micro-shake, focus locked on his face, the alley behind him falling soft.سطر ضعيف
اسم المشغّل محدد
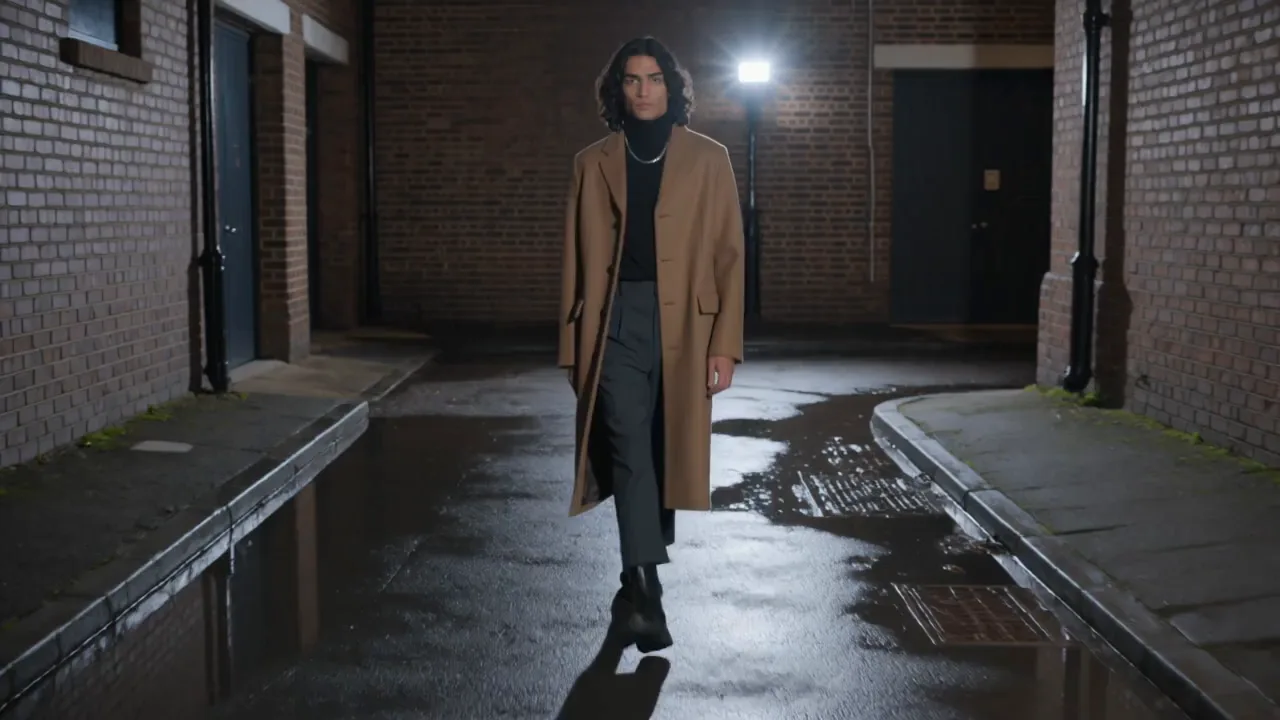
أي نموذج يستجيب لأي تعليمات
قمنا بتقييم كل سطر بناءً على سؤال واحد: هل وصل ما طُلب؟ تلقى Kling v3 سطرًا واحدًا في كل مرة؛ تلقى Seedance 2.5 الأسطر الثلاثة دفعة واحدة، بدقة 480p. هذا ما رأيناه في هذا المشهد، تشغيل واحد لكل خلية.
| التعليمات | Kling v3، سطر واحد في كل مرة | Seedance 2.5، الأسطر الثلاثة معًا |
|---|---|---|
| مصدر ضوء محدد الاتجاه واللون | النتيجة: مصابيح دافئة عالية خلفه، مدخل متجر مضاء على اليمين؛ حافة خفيفة على شعره | النتيجة: مصباح برتقالي عالٍ خلفه، مدخل مضاء بارد على الجدار الأيمن |
| مشي مع ضربات كعب ومعطف يتأرجح | النتيجة، مع وضع اليد اليمنى على الياقة كما هو مكتوب | النتيجة، مع وضع اليد اليمنى على الياقة كما هو مكتوب |
| مشغل محمول يمشي للخلف، من الصدر للأعلى | وصلت حركة المشي للخلف في كلتا المحاولتين؛ واحدة صورته من الصدر للأسفل مع قطع رأسه، والأخرى بكامل الطول؛ لا واحدة منهما من الصدر للأعلى | بدأت بلقطته على معطفه مع خروج رأسه من الكادر، ثم ارتفعت إلى لقطة من الفخذ للأعلى؛ ليست من الصدر للأعلى |
انتبه:الإطار هو السطر الذي انزلق. حافظ كلا النموذجين على الإضاءة والمشي. لم يحافظ أي منهما على لقطة الصدر للأعلى: قام Kling v3 بتصويره من الصدر للأسفل في محاولة واحدة وبكامل الطول في المحاولة التالية، ومع دمج الأسطر الثلاثة في أمر نصي واحد، قام Kling بتصويره بكامل الطول بينما بدأ Seedance 2.5 بلقطته على معطفه وارتفع إلى الفخذين. تحقق من حجم الكادر قبل أن تبني على المقطع.
الأسطر الثلاثة معًا
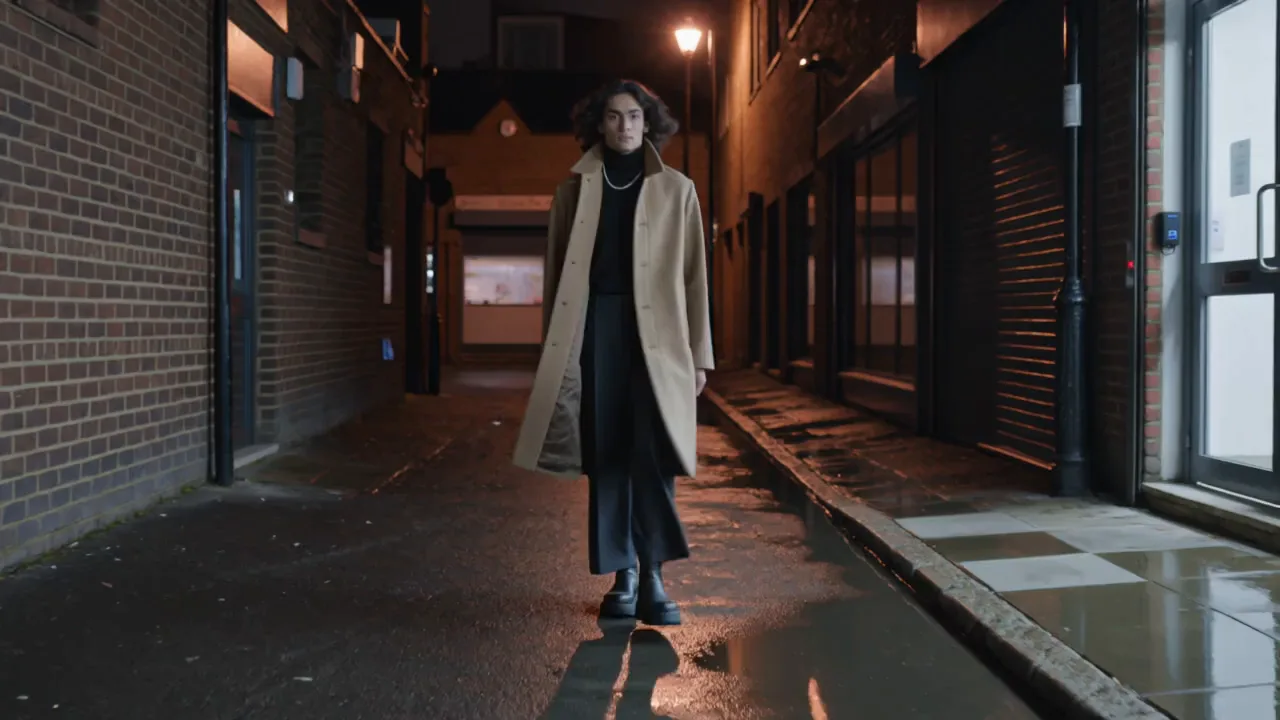
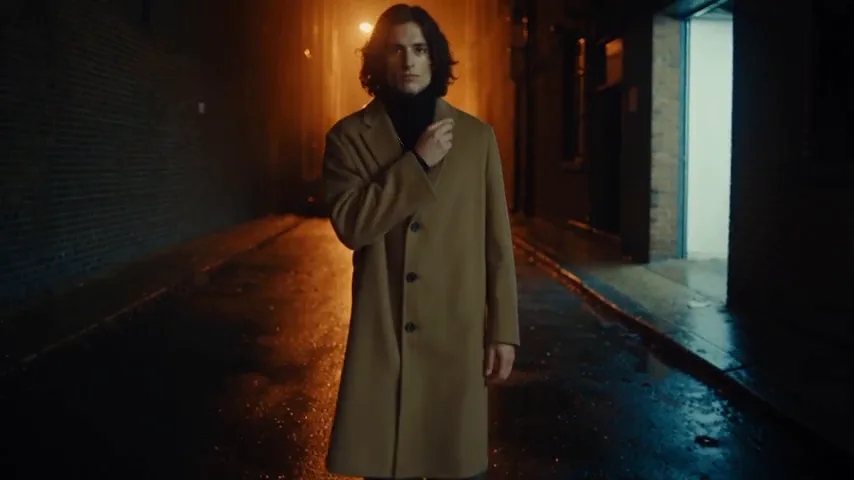
Fashion film, one continuous take, real-time, night. SUBJECT: a man of 24, tall, dark wavy shoulder-length hair, olive skin, a long camel wool coat buttoned closed, a black turtleneck, wide charcoal trousers, chunky black boots, a thin silver chain. LOCATION: a narrow rain-wet alley, black asphalt with puddles, brick walls, light drizzle. ACTION: he walks straight toward the camera at an unhurried pace, each step landing heel first with a visible weight shift, the coat swinging with each stride; halfway through he lifts his right hand and turns up his coat collar, four fingers on the outside of the collar and the thumb inside, then lets the hand drop. CAMERA: handheld, walking backward at his pace, chest-up framing, natural sway and micro-shake, focus locked on his face. LIGHTING: one orange sodium street lamp high behind him as a backlight, rimming his hair and shoulders and glittering in the puddles; a soft cool white glow from an open shop doorway camera-right as the only fill on his face. LOOK: 35mm film grain, halation on the lamp, wet reflections, deep shadow with detail. No text, no logos, no readable signage.ثلاث طرق لتشغيل هذا
- الأسرع: افتح مؤلف الفيديو، والصق الأمر النصي القوي، واختر Kling v3 (Kling 3.0 في قائمة النماذج) أو Seedance 2.5، ثم اضغط على توليد. السعر يظهر على الزر.
- بدون تدخل يدوي: صف المشهد لـ NOLGIA Agent واطلب إضاءة محددة، ومشية ذات وزن، وعامل كاميرا محمول باليد. سيقوم بكتابة الأوامر وعرض الفيديو.
- أقصى تحكم: تأخذ API نفس الأمر النصي، لذا يمكنك تشغيل الأوامر الضعيفة والقوية مقابل بعضها على عدة نماذج والاحتفاظ بسجلات المهام.
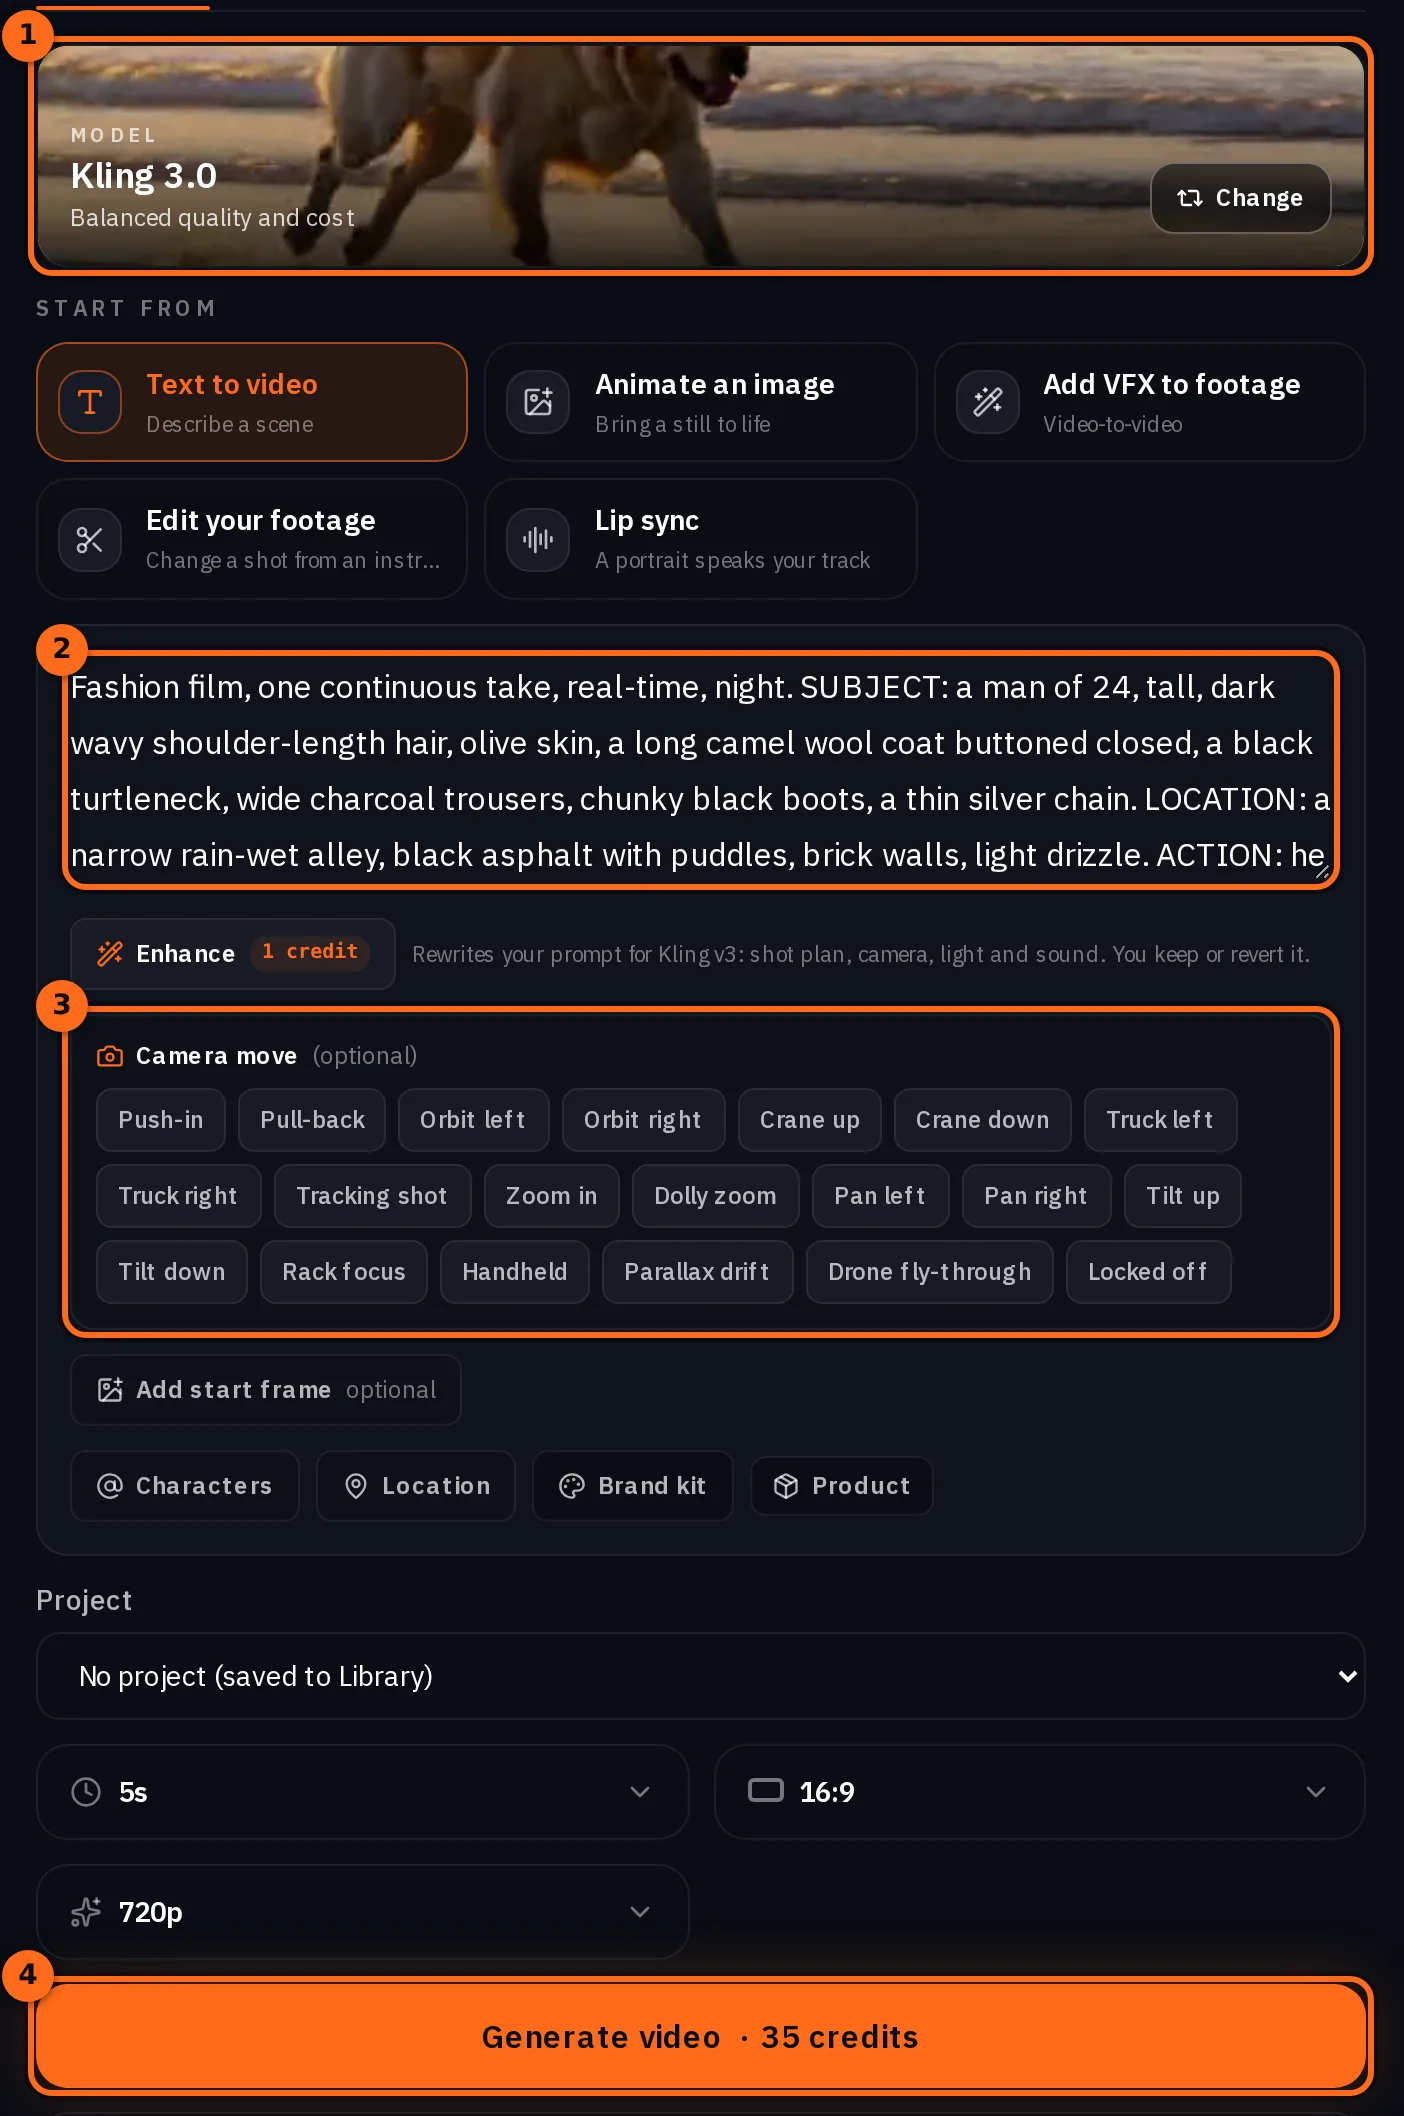
| المهمة | استخدام | السبب |
|---|---|---|
| حركة كاميرا محمولة باليد أو على عربة دون كتابتها | صف حركة الكاميرا، محدد القوة | يُضاف إلى الأمر النصي الخاص بك كجملة مستقلة |
| الحبيبات، الهالاشن، فيلم سينمائي بعد العرض | تدرج الألوان في Studio | المظهر وأشرطة الفيلم على الخط الزمني، دون إعادة العرض |
| نفس المشهد على عدة نماذج | Explore، أو API | كل نموذج يُعاين بمخرجاته الخاصة؛ عرض سعر واحد لكل تشغيل |
التكلفة
اختبر كل سطر لمدة 5 ثوانٍ على Kling v3، أو بدقة 480p على Seedance 2.5، وقم بعرض النتيجة النهائية مرة واحدة. يظهر السعر على زر Generate قبل أن تنفق أي رصيد.
Kling v3Pro and up
Per 5s clip (audio on by default)
720p: 35 رصيد · 1080p: 47 رصيد · 4K: 117 رصيد
Seedance 2.5Pro and up
Per 5s clip
480p: 26 رصيد · 720p: 56 رصيد · 1080p: 137 رصيد
1080p renders at 16:9 and 9:16
تُقرأ مباشرة من الكتالوج عند تحميل هذه الصفحة. يظهر كل سعر قبل أن تبدأ التوليد. عرض كل الأسعار.
متى لا يزال عليك إعادة التوليد
- قامت الكاميرا بحركة غير متوقعة. أعد التشغيل قبل إعادة كتابة الأمر النصي؛ فكل تشغيل جديد هو محاولة جديدة. حافظت لدينا على الحركة لكننا فقدنا حجم الإطار.
- ظهر الضوء في المكان الخطأ. حدد الاتجاه: يسار الكاميرا أو يمينها، خلف أو فوق؛ فذكر كلمة اتجاه لا يكلف شيئاً.
- تغير الوجه بين عمليات التشغيل. هذا أمر متوقع في غياب صورة مرجعية، ولا نقدم أي ضمان بشأنه. قيّم كل مقطع على حدة.
- شخصان في الإطار. استخدم ممثلاً واحداً لكل اختبار.
خمسة أمور يجب التحقق منها قبل اعتبار العمل منجزاً
- يجب أن يكون للضوء مصدر يمكن الإشارة إليه، وأن تتوافق الظلال معه.
- يجب أن يكون للمشي صوت خطوات؛ وأن تتحرك الملابس مع الجسد.
- يجب أن تكون الكاميرا في المكان الذي حددته، وليس خلف ظهر الممثل.
- يجب أن يكون هناك عنصر في الإطار غير حاد التركيز.
- يجب أن يبدو المقطع مصوراً بشكل طبيعي عند النظرة الأولى، وليس فقط عند التدقيق.
أسئلة وأجوبة
- لماذا لا يجعل كتابة كلمة "realistic" المقطع واقعياً؟
- لأنها ليست تعليماً فيزيائياً. مصباح له اتجاه، كعب قدم يهبط على الأرض، كاميرا على الكتف: هذه هي الأشياء التي يمكن للنموذج عرضها.
- ما هو أكبر دليل على الزيف؟
- إضاءة بلا مصدر. إضاءة الشخص بالتساوي من كل الجوانب تُسطّح المشهد قبل أن يتحرك أي شيء.
- أي نموذج هو الأفضل للواقعية؟
- لأي شيء يمشي أو يستدير أو يحمل وزنًا، استخدم Kling v3 أو Seedance 2.5. يوضح الجدول أعلاه ما فعله كل نموذج بنفس الأسطر في مشهد واحد. شغّل مشهدك الخاص قبل الالتزام.
- هل أكتب حركة الكاميرا يدويًا إذا استخدمت صف حركة الكاميرا؟
- لا. يضيف الصف الحركة إلى الأمر النصي كجملة مستقلة، بالقوة التي تختارها. اكتب الإضاءة والحركة بنفسك.
- كيف أعرف أن الإصلاح نجح؟
- قم بعرض النسخة الجديدة جنبًا إلى جنب مع النسخة السابقة وقارن بينهما. يحفظ المحرر كل عملية تشغيل في المكتبة.
حدد الإضاءة في مقطعك التالي
افتح محرر الفيديوأدلة ذات صلة
كتابة الأوامر
سبعة أخطاء في أوامر الفيديو النصية، والحل لكل منها
سبع طرق يخطئ فيها الأمر النصي للفيديو، تم عرض كل منها مرتين على Kling v3: الأمر الغامض، ثم نفس الأمر مع حل واحد. انسخ الحلول، واقرأ ما لا يفعله البذرة (seed).
· قراءة في 12 دقيقة
كتابة الأوامر
اجعل شخصيات الذكاء الاصطناعي تتحرك بشكل واقعي: الوزن، التلامس، والتوقيت
تتحرك الشخصيات بشكل سيئ في فيديو الذكاء الاصطناعي عندما يحدد الأمر النصي الفعل فقط، لا فيزياءه. عرض واحد لحركة بهلوانية خلفية على ثلاثة نماذج من نفس اللقطة، بالإضافة إلى ثلاث أزواج حول الوزن، التلامس، والتوقيت.
· قراءة في 11 دقيقة
المدونة · مقارنة
أمر نصي واحد، ستة نماذج فيديو، تسعة فحوصات دقيقة
أمر نصي واحد يحتوي على تسعة تفاصيل قابلة للتحقق، أُرسل إلى ستة نماذج فيديو بالذكاء الاصطناعي مرتين لكل نموذج، وقُيِّس كل مقطع باستخدام كاشف، وقراءة النص، وتتبع الكاميرا.
· قراءة في 12 دقيقة